Author InformationName: Shutter Zor(左祥太)Email: Shutter_Z@outlook.com商务联系:ShutterZor
目录
0 引言
最近,Science 上的一篇文章引起了热议,该文章指出:“中国光伏扩张政策减少了鸟类多样性。”生态学学者与经济学学者对该文章产生了激烈的争论。需要指出的是,有分歧很正常,有不同的意见也很正常,就像心理学比较喜欢三步法中介,但经济学近年来却掀起了对三步法中介的批判一样。
我注意到一个声音,他们指出:“ Science 就是偏爱有关中国的负面消息”,并将该文章定性为符合西方叙事的“政治正确”。这个引起了我的好奇,Science 真的是这样的吗?
于是,我通过 Python 爬取了 Science 正刊近十年的所有文章,根据国家进行划分,使用预训练的语言模型判断这些文章的标题所透露出来的情绪。
1 数据来源与分析逻辑
我尝试了爬 Science 官网,有点难,经常 403。所以我换了一个思路,通过 crossref 的 API 获取文章的基本信息。
整体的处理逻辑大致如下:
- 首先,通过该 API 一次性获取 Science 近十年的所有文章。
- 其次,根据标题中含有的China、Japan、American、Singapore及其全称(或变体)等判断该标题在讲哪个国家。
- 最后,对标题整体进行情绪分析,得到情绪分类标签与具体取值。若标题中涵盖多个国家,则该样本对应分裂成多条,分别为其中的国家增加一条情绪记录。
2 Python 实现代码
2.1 数据获取
主要思路与方法如下:
- 数据源:Crossref REST API- 期刊:Science- ISSN:0036-8075- 时间:2016-01-01 至 2025-12-31处理流程:1. 获取 Science 正刊全部 journal-article2. 使用 cursor 自动翻页3. 保存完整母样本4. 根据标题识别五个国家5. 输出五国子样本
完整代码从文章末尾下载。
2.2 情绪分析
主要思路与方法如下:
- 输入:science_2016_2025_five_countries.csv- 输入中的核心变量:title、publication_date、matched_countries- 逻辑: - Step 1,对每一个标题进行一次情绪分析 - Step 2,获得:negative_prob、neutral_prob、positive_prob、sentiment_score - Step 3,根据 matched_countries 拆分国家 - Step 4,形成 Article-Country 数据 - Step 5,按 Country-Year 聚合- 最终得到:1. article_country_sentiment.csv article_id title country publication_date year sentiment negative_prob neutral_prob positive_prob sentiment_score2. country_year_sentiment_panel.csv country year article_count mean_sentiment median_sentiment negative_rate neutral_rate positive_rate
这里使用到的情绪判别模型为“cardiffnlp/twitter-roberta-base-sentiment-latest”,它是一个基于 RoBERTa 的模型,使用 2018 年 1 月至 2021 年 12 月间约 1.24 亿条推特推文训练,并用 TweetEval 基准进行情感分析进行微调。
此部分完整代码与数据从文章末尾下载。
2.3 词频统计与可视化
词频统计的主要思路与方法如下:
- 数据:science_article_country_sentiment.csv- 逻辑:一篇文章如果涉及多个国家,则该标题分别进入多个国家的词云。- 例如, - Title: China and Japan face challenges in climate policy - matched_countries: China; Japan - 则: - China词云 ← 加入该标题 - Japan词云 ← 加入该标题
可视化部分的逻辑同上,同样地,代码在文章末尾下载。
3 结果讨论
3.1 词云结果
我们在这里简单比较一下发表在 Science 正刊上的,含有“中国”、“日本”、“美国”的标题,所构成的词云。
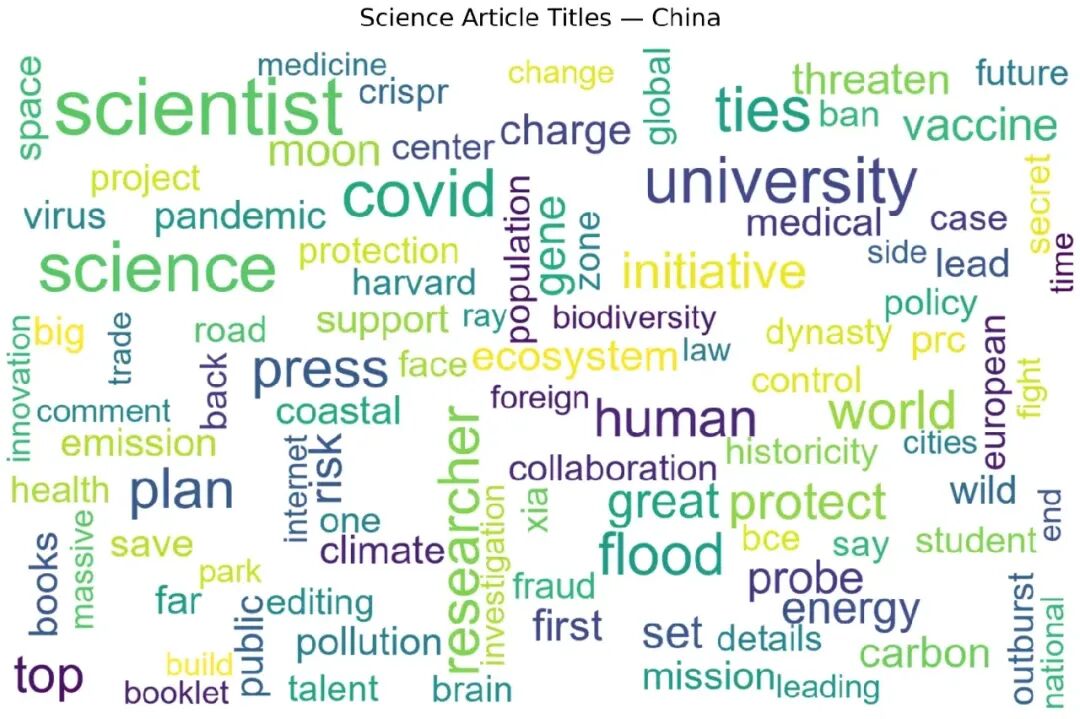 图1.Science正刊过去十年标题中含中国的词云
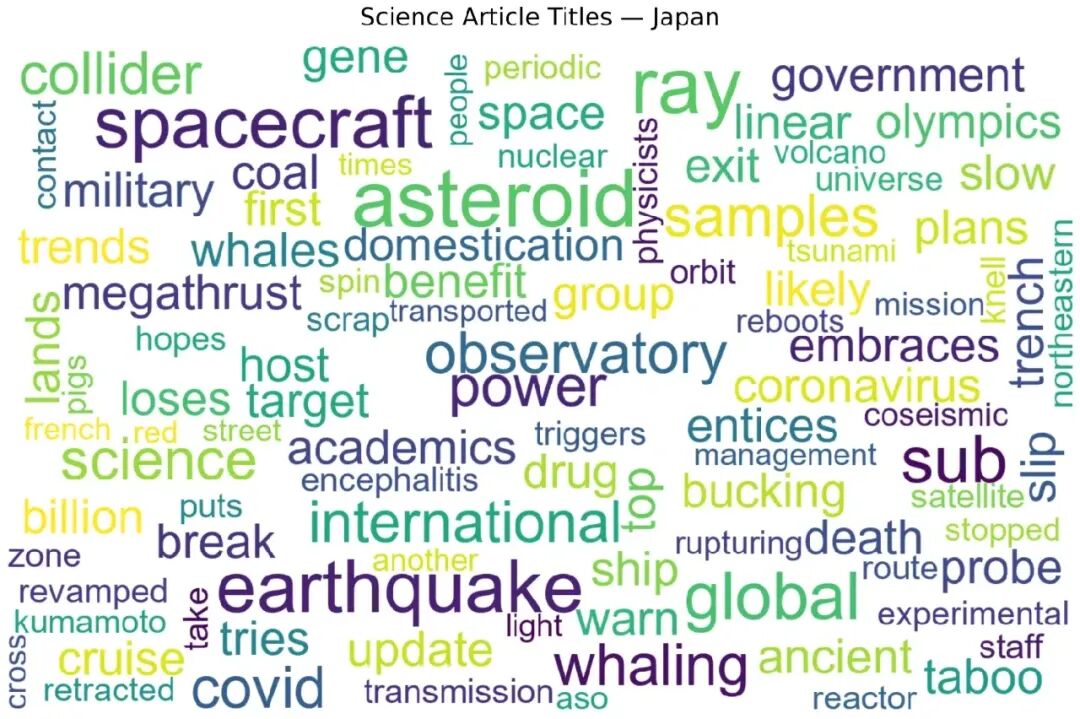 图2.Science正刊过去十年标题中含日本的词云
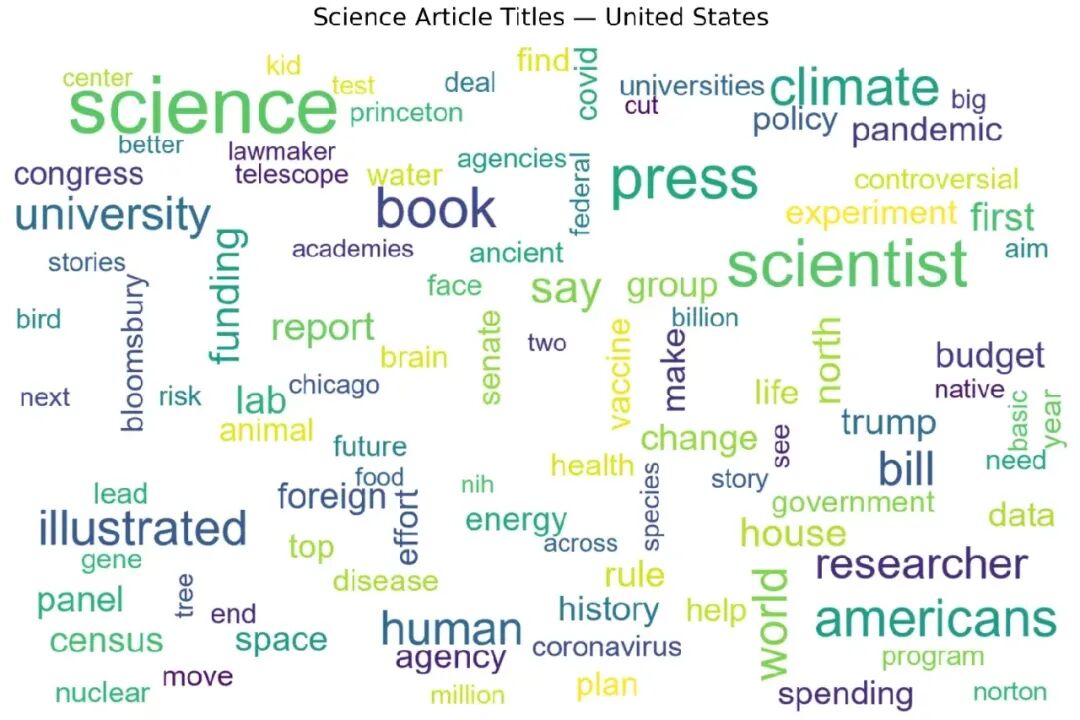 图3.Science正刊过去十年标题中含美国的词云
3.2 情绪可视化结果
词云图的内容可能比较难以直接判断标题所传达出来的情绪,接下来我使用上述的预训练语言模型对标题进行了情绪分析。
首先我用该模型判断标题的情绪属性,是“积极”、“中性”,还是“消极”,然后我计算了这 5 个国家在近十年的 Science 正刊中的被评为“消极”标题的占比,结果如下:
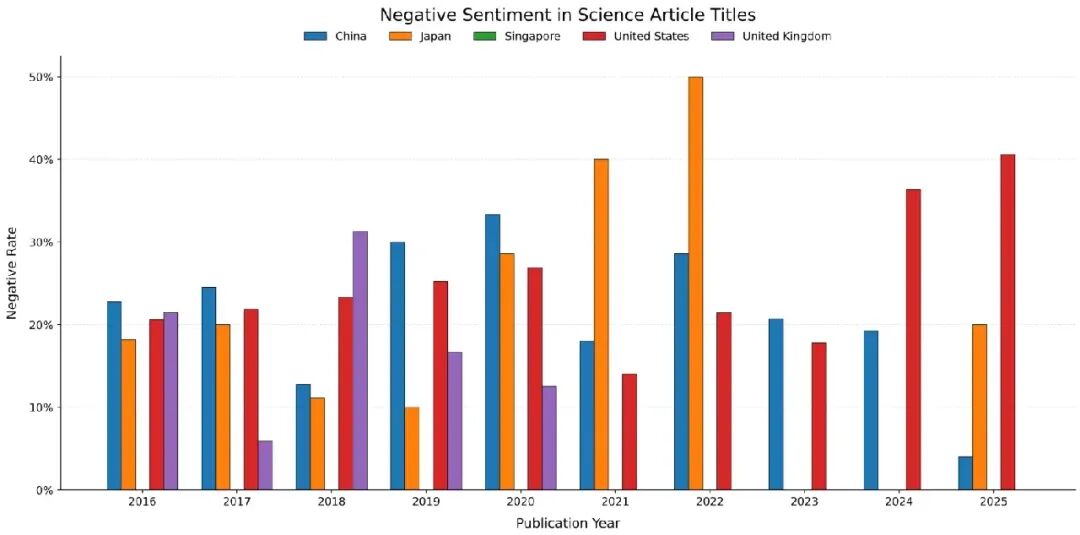 图4.消极文章占比
不难发现,在 Science 正刊近十年发表的文章中,中、日、美三个国家的消极概率都不低。Science 正刊上发表的(仅限标题)与中国相关的文章中,负面比例存在波动,但持续下降;与美国相关的文章中,负面比例存在波动,但持续增长。
接下来我判定了每篇文章的情绪得分,其计算方法为“积极情绪得分-消极情绪得分”,并基于得分结果进行了组间差异分析,如下:
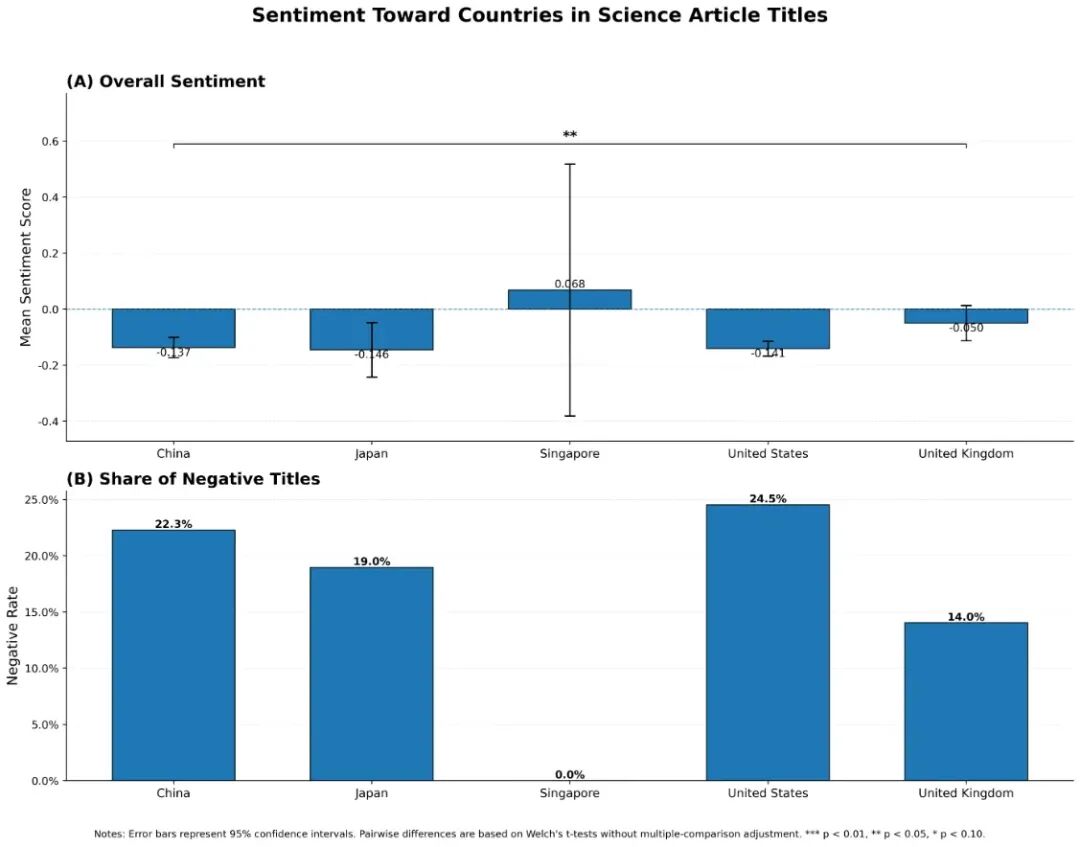 图5.消极文章整体分析
从平均情绪来看,Science 正刊上发表的文章,标题中但凡涉及中国、日本、美国的,都会存在显著的负面情绪,暂不能推断“Science 偏爱报道中国的负面研究”这一结论。此外,从整体份额来看,对美国的负面报道比例更大。
从美国到英国的负面比例排序,倒是跟国家 GDP 大小的排序一致。
4. 本推文局限性
本推文只是对结果进行一些描述性的说明,而不是严谨的因果推断。事实上,确实可能存在部分编辑/审稿人对某类主题的文章具有偏好,所以如果要进行严格的因果推断,至少需要控制编辑类别、作者国籍等一系列变量。
当然,本文所使用的预训练语言模型可能也并不是那么的恰当。为简单验证,我选择了一个能在本地直接运行的模型,该模型基于推特文章训练,可能在对学术文章标题的情绪判别方面存在局限。
最后,本推文的所有代码数据均已上传至网盘,如有需要请自取:
BW-20260826链接: https://pan.baidu.com/s/1Yb51gIAcLI6JyCp_zQbFSA?pwd=GWSL提取码: GWSL
 10个月宝宝每天需要喝多少奶粉?