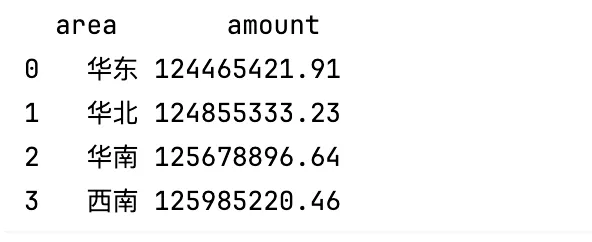
import pandas as pdimport numpy as np# 1. 统一定义数据长度,确保所有字段绝对对齐(避免长度不一致报错)n_rows = 200000# 2. 生成模拟测试数据,字段:order_id, area, amount, order_timemock_data = pd.DataFrame({ "order_id": np.arange(1, n_rows + 1), "area": np.random.choice(["华北", "华东", "华南", "西南"], size=n_rows), "amount": np.round(np.random.uniform(10, 5000, size=n_rows), 2), "order_time": pd.date_range(start="2026-01-01", periods=n_rows, freq="1min")})mock_data.to_csv("large_order.csv", index=False)# 3. 分块处理逻辑(使用列表收集结果,避免循环中频繁concat导致性能损耗)chunk_iter = pd.read_csv("large_order.csv", chunksize=20000)chunk_results = []for chunk in chunk_iter: # 过滤:金额大于0的有效订单 valid = chunk[chunk["amount"] > 0] # 分块内聚合 chunk_agg = valid.groupby("area")["amount"].sum().reset_index() chunk_results.append(chunk_agg)# 4. 合并分块结果,再次聚合得到最终统计total_result = pd.concat(chunk_results, ignore_index=True)final_stat = total_result.groupby("area")["amount"].sum().reset_index()# 禁用科学计数法,保留两位小数,方便查看大数值pd.set_option('display.float_format', lambda x: '%.2f' % x)print(final_stat)