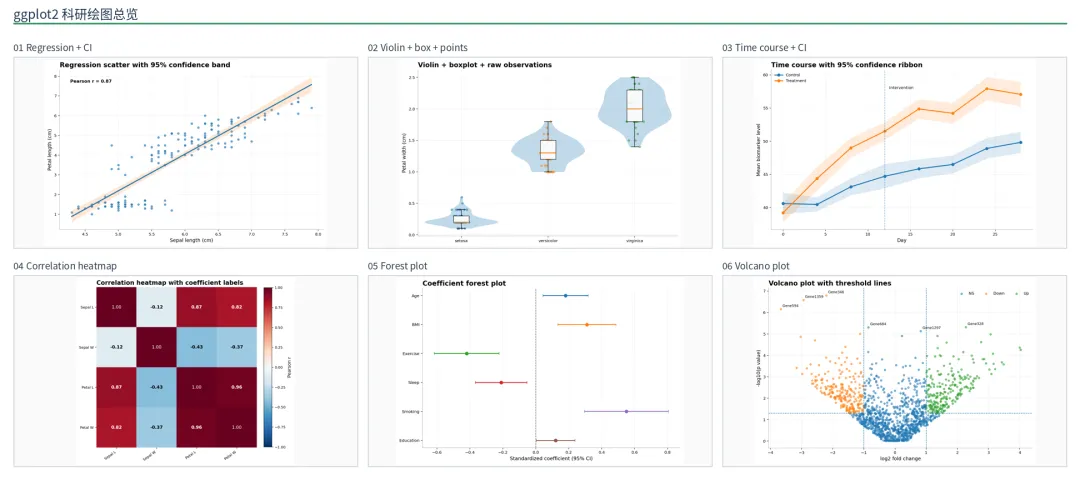
不止 Python:R 语言 ggplot2 科研绘图
从“图形语法”到 6 张论文常用图,一篇入门
很多刚开始做数据分析的人会先接触 Python,但如果研究方向偏统计学、流行病学、生态学、社会科学或生物信息,R 语言的 ggplot2 几乎绕不开。它最大的特点不是“函数很多”,而是把一张图拆成数据、映射、几何对象、统计变换、坐标系统、分面和主题等层次。理解这套逻辑以后,你不需要死记几十个绘图模板,只要判断“我要把哪个变量映射到位置、颜色、形状或大小,再叠加哪些统计图层”即可。这篇文章不从枯燥语法表开始,而是直接用 6 张常见科研图带着理解 ggplot2。
ggplot2 的核心:一张图 = 数据 + 映射 + 图层 + 尺度 + 主题
组件 | 常见写法 | 它负责什么 |
数据 | ggplot(data) | 使用哪张数据表 |
映射 | aes(x, y, color) | 变量映射到位置、颜色 |
图层 | geom_*() | 真正画出点、线、区间 |
统计 | geom_smooth() | 平滑、汇总等变换 |
分面 | facet_wrap() | 按组拆成多个小图 |
主题 | theme_*() | 字体、网格、背景、图例 |
安装:install.packages(c("ggplot2", "dplyr", "ggrepel"))
01散点图 + 回归线 + 95% 置信区间:ggplot2 最经典的统计图组合
如果只用一张图理解 ggplot2,散点图加回归线几乎是最好的入口。它把 ggplot2 的核心思想展示得非常完整:数据来自 data,横纵坐标通过 aes() 映射,原始观测由 geom_point() 绘制,模型趋势由 geom_smooth() 追加,而 theme_classic() 或 theme_minimal() 决定最后的视觉风格。这里最值得注意的是,ggplot2 并不是要求你一次性把整张图“写完”,而是不断往图上叠加图层。科研中,这种图特别适合回归分析、相关分析、剂量—反应关系以及两个连续变量之间的趋势展示。与单纯放一条拟合线相比,加入 95% 置信区间能告诉读者估计趋势的不确定性;同时保留原始散点,又能帮助判断离群值、非线性和异方差。
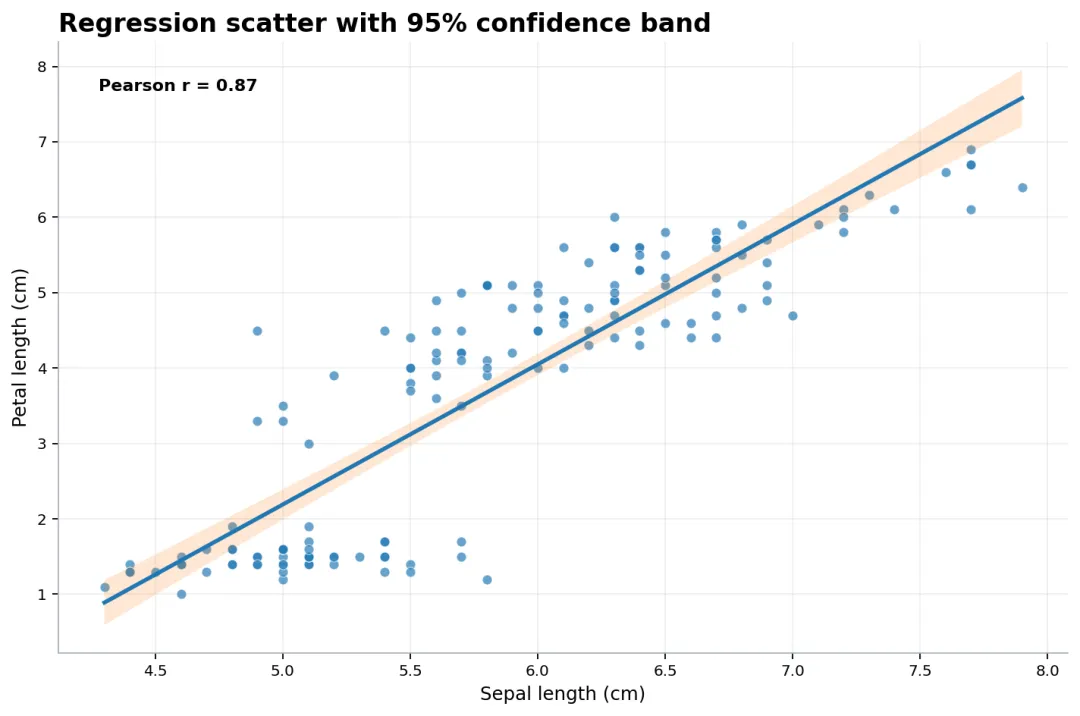
示例:Iris 数据中的花萼长度与花瓣长度,回归线叠加 95% 置信区间。
aes() 映射 x 与 y | geom_point() 原始观测 | geom_smooth() 拟合 + CI | theme_classic() 期刊式主题 |
02小提琴图 + 箱线图 + 原始点:不要只给均值,让分布自己说话
科研作图中一个常见问题是:只画柱状图和均值,容易把真实数据结构隐藏起来。ggplot2 的优势在于可以非常自然地把多个统计表达叠到一起。以组间分布为例,geom_violin() 用密度宽度展示分布形状,geom_boxplot() 提供中位数和四分位数,geom_jitter() 则把每个原始观测重新放回图中。三者组合以后,一张图可以同时回答“数据集中在哪里”“离散程度如何”“有没有多峰或异常点”“每组到底有多少样本”等问题。现在不少实验类、生命科学和社会科学论文都倾向保留原始点,因为它比只给 summary statistics 更透明。实际作图时要注意透明度和层级:小提琴应该作为背景,箱线图稍窄,原始点则适当抖动以减少重叠。
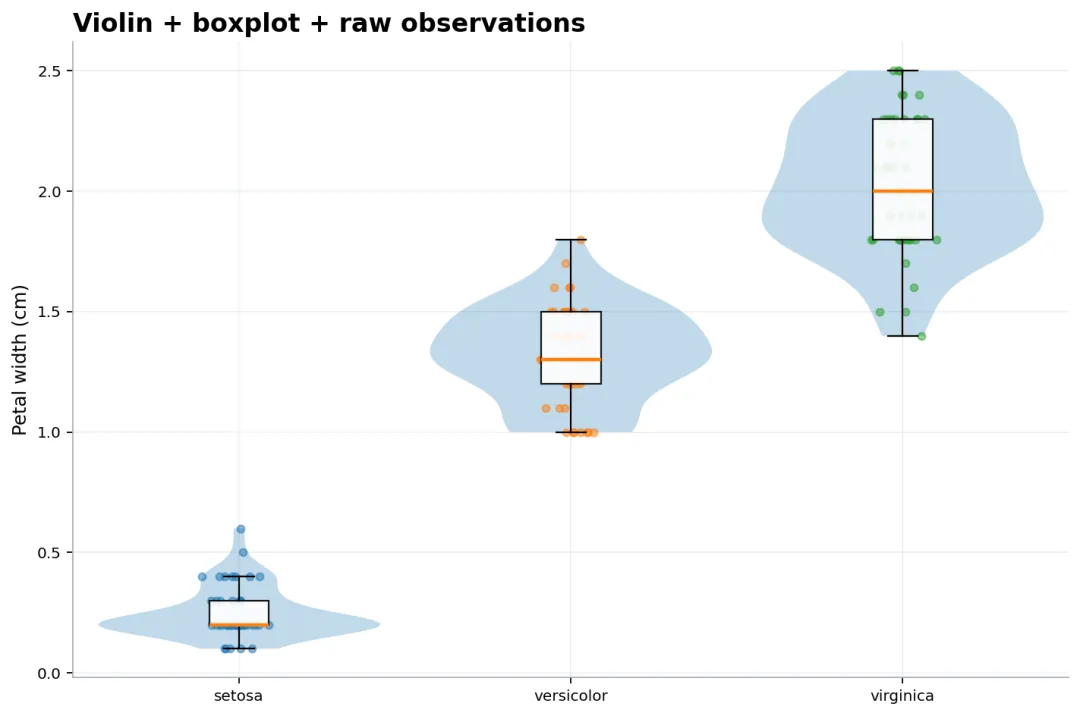
示例:三种 Iris 的花瓣宽度分布,小提琴、箱线和原始点叠加。
geom_violin() 密度形状 | geom_boxplot() 四分位摘要 | geom_jitter() 原始样本 | alpha 控制透明度 |
03时间序列 + 置信带:geom_ribbon() 是科研折线图的关键
折线图在科研中真正有价值的地方,不只是把几个均值连起来,而是同时表达“趋势”和“不确定性”。ggplot2 中常见的做法是先用 dplyr 对重复观测按组和时间汇总,计算均值、标准误以及 95% 置信区间,再用 geom_line() 画均值趋势,用 geom_point() 标出观测时点,用 geom_ribbon() 绘制置信带。如果研究设计中存在干预时点,还可以用 geom_vline() 加一条参考线。这样一张图就可以清楚展示两组是否随时间分化、差异出现在哪个阶段、置信区间是否大量重叠。需要注意,置信带并不是“数据波动范围”,它描述的是均值估计的不确定性;如果希望展示个体波动,则应该画 SD、原始轨迹或 spaghetti plot。
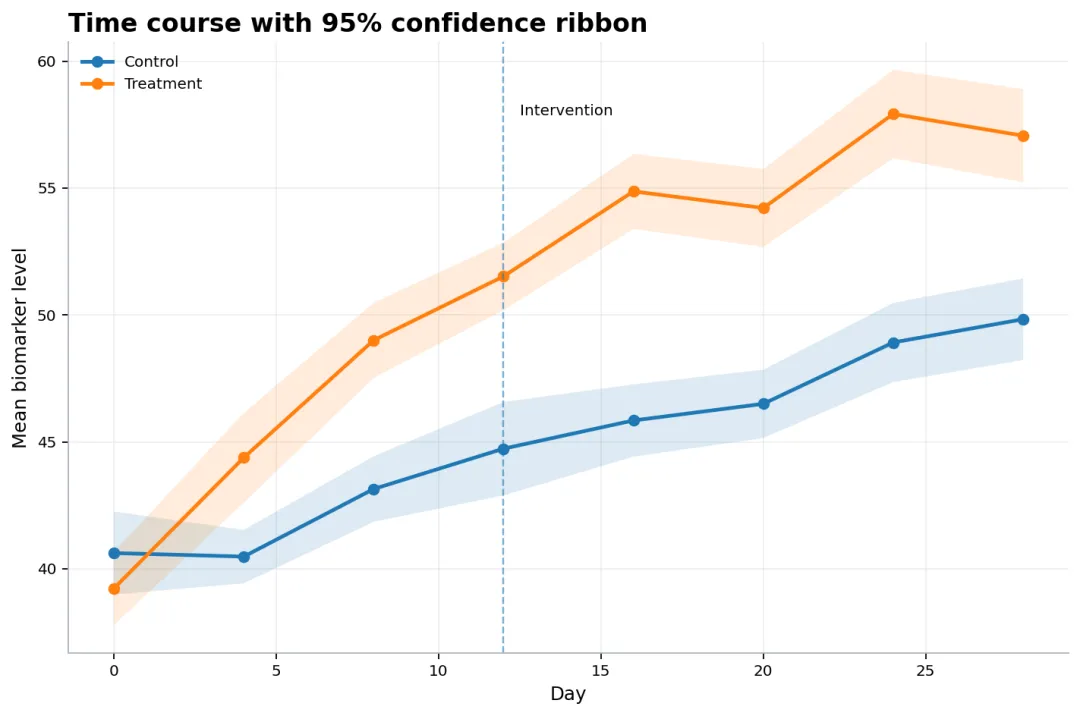
教学示例:两组生物标志物随时间变化,并叠加 95% 置信区间。
group_by() 按组汇总 | geom_ribbon() 置信区间 | geom_line() 均值趋势 | geom_vline() 事件参考线 |
04相关系数热图:geom_tile() 把矩阵数据变成一眼能读的结构
热力图是统计学和数据科学中最常见的矩阵型图之一,而 ggplot2 更强调把矩阵整理成长数据后再交给 geom_tile()。这恰好体现了 tidy data 与 ggplot2 的配合方式:先用 cor() 得到相关系数矩阵,再转换成长表,每一行表示一对变量和对应的 r 值,最后让 x、y 决定格子位置,fill 决定颜色。为了让读者不仅看到颜色,还能读取具体数值,可以再叠加 geom_text();对于以 0 为中心、既有正相关又有负相关的结果,scale_fill_gradient2() 是非常合适的发散色带。科研中还可以进一步只保留下三角、加入 P 值星号、按层次聚类重新排序变量。
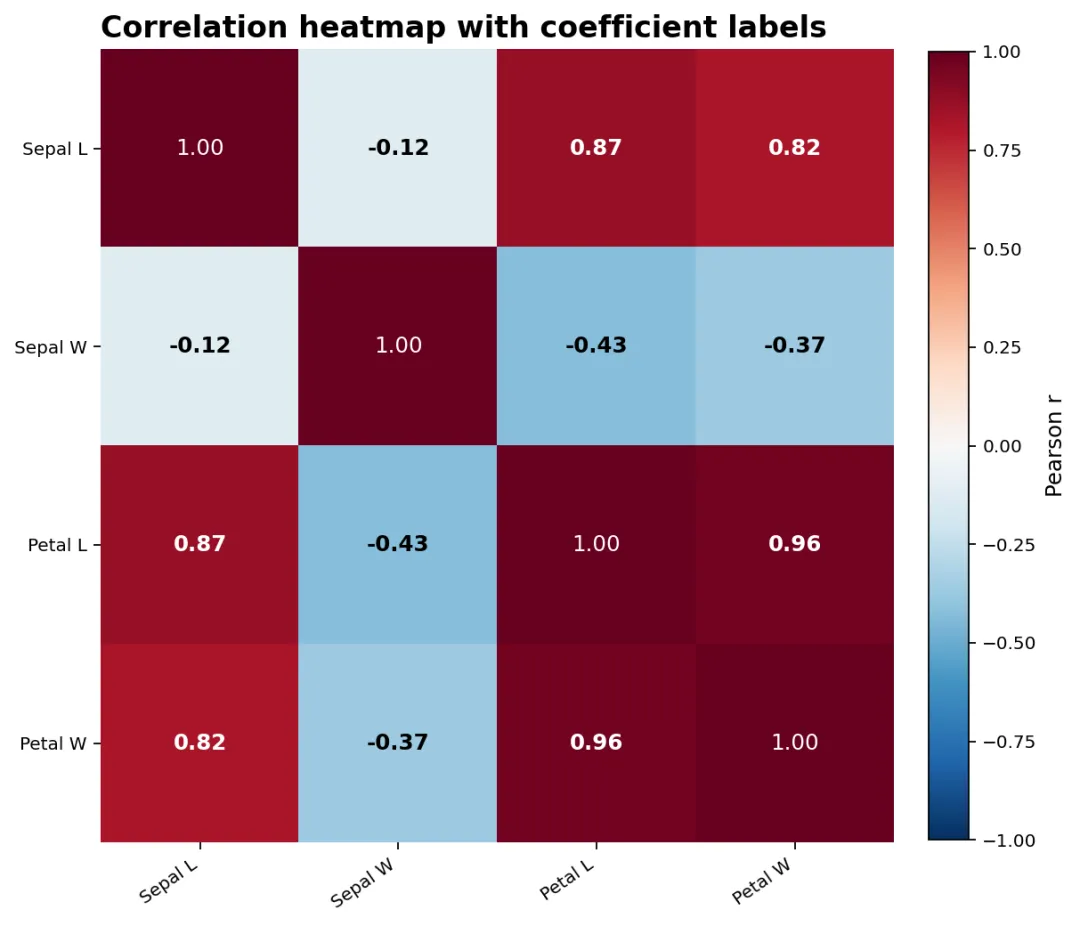
示例:Iris 四个连续测量变量的 Pearson 相关系数热图。
cor() 计算相关矩阵 | geom_tile() 绘制色块 | geom_text() 叠加 r 值 | scale_fill_* 控制色带 |
05森林图:用 geom_pointrange() 同时表达效应方向、大小和不确定性
如果研究结果包含多个回归系数、多个亚组效应或多项 Meta 分析结果,森林图通常比结果表更容易阅读。ggplot2 中的森林图其实并不神秘:每一行就是一个变量,点表示 estimate,横线表示 lower 到 upper 的置信区间,再加一条 x=0 的参考线即可。geom_pointrange() 可以一次完成点和区间的绘制。读者可以迅速判断哪些效应为正、哪些为负、哪些区间跨过 0,以及哪些估计最精确。对于 OR、HR 或 RR 这类比值指标,应把无效应参考线改为 1,并通常使用对数坐标。科研写作中还可以按照变量组添加分隔、在右侧附上数值标签,甚至把多个模型并排比较。
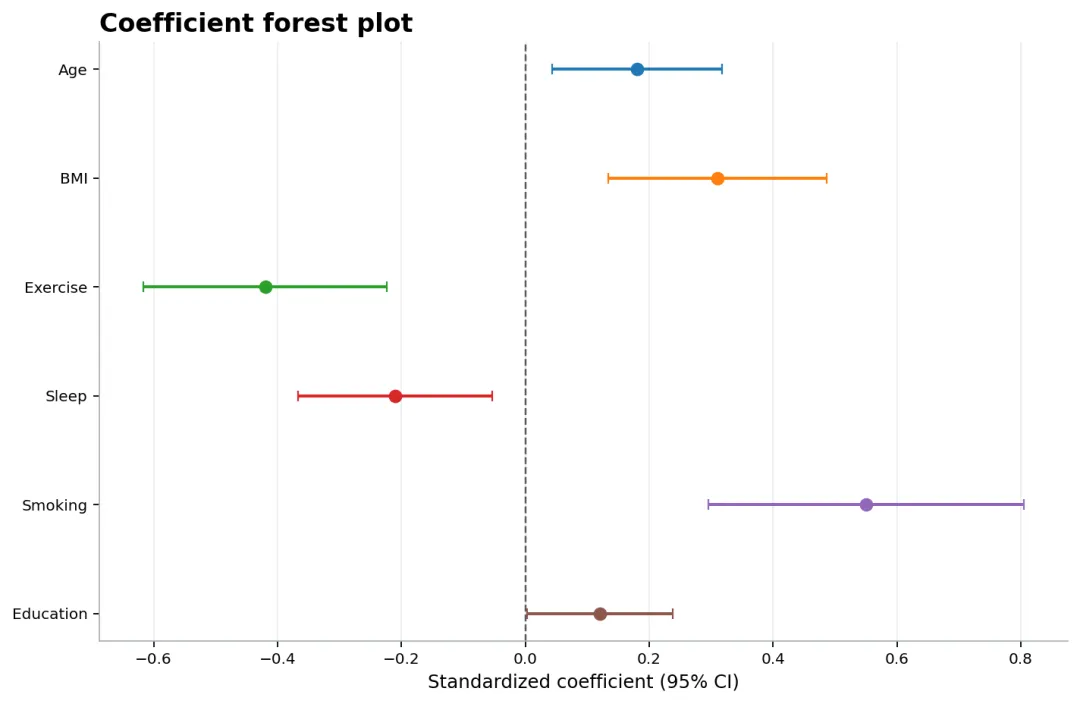
教学示例:六个预测变量的标准化回归系数及 95% 置信区间。
geom_pointrange() 点 + CI | geom_vline() 无效应线 | reorder() 调整变量顺序 | coord_* 控制方向 |
06火山图:ggplot2 的图层思维特别适合“阈值 + 分类 + 标签”
火山图是组学研究中的经典图,但它也非常适合用来理解 ggplot2 的“多图层组合”。横轴通常是 log2 fold change,纵轴是 -log10(P value)。第一层 geom_point() 负责画全部基因,颜色映射 status 后即可区分上调、下调和不显著;geom_vline() 与 geom_hline() 负责画 fold change 和显著性阈值;如果想给最重要的基因加标签,可以继续叠加 geom_text(),或者使用 ggplot2 扩展包 ggrepel 的 geom_text_repel() 自动避让文字。这里可以看到,ggplot2 的高级感往往不是来自某一个“高级函数”,而是来自把不同信息拆成清晰图层。
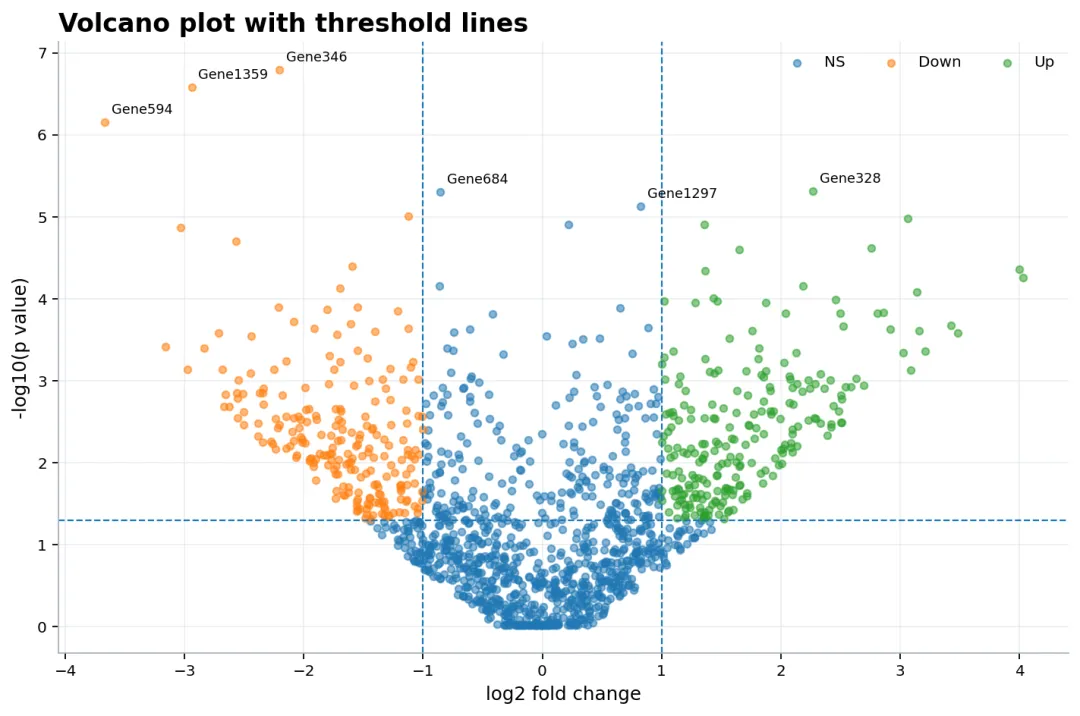
教学示例:模拟差异分析结果的火山图,展示阈值线、分类和重点标签。
geom_point() 全部基因 | geom_vline() FC 阈值 | geom_hline() P 值阈值 | ggrepel 标签避让 |
结尾:真正要学的不是 6 张图,而是 ggplot2 的图层思维
学 ggplot2 最容易走进的误区,是把它当成“R 语言里的一堆绘图函数”去背。实际上,真正值得掌握的是它背后的图形语法:先准备整洁的数据,再用 aes() 指定变量与视觉属性的映射,然后按需要叠加点、线、区间、文本、参考线和统计结果,最后用 scale 与 theme 调整尺度和视觉风格。上面的回归图、分布图、时间序列、热图、森林图和火山图看起来完全不同,但它们的代码结构高度一致。等你熟悉这种思维后,面对论文里没见过的新图,也能把它拆成几个图层重新组合,而不是到处寻找“同款模板”。
说明:Iris 示例使用 R 自带数据集;时间序列、森林图和火山图使用教学模拟数据。
完整 R 代码附录
以下代码可直接复制到 RStudio;第 06 图需要额外安装 ggrepel。
01|散点图 + 回归线 + 95% 置信区间:ggplot2 最经典的统计图组合
library(ggplot2) ggplot(iris, aes(Sepal.Length, Petal.Length)) + geom_point(size=2.2, alpha=.65) + geom_smooth(method="lm", se=TRUE, linewidth=1.1) + labs(x="Sepal length (cm)", y="Petal length (cm)") + theme_classic(base_size=12) |
02|小提琴图 + 箱线图 + 原始点:不要只给均值,让分布自己说话
library(ggplot2) ggplot(iris, aes(Species, Petal.Width, fill=Species)) + geom_violin(trim=FALSE, alpha=.35, width=.85) + geom_boxplot(width=.14, outlier.shape=NA, alpha=.8) + geom_jitter(width=.06, size=1.6, alpha=.50) + labs(x=NULL, y="Petal width (cm)") + theme_classic(base_size=12) + theme(legend.position="none") |
03|时间序列 + 置信带:geom_ribbon() 是科研折线图的关键
library(ggplot2); library(dplyr) set.seed(12) df <- expand.grid(group=c("Control","Treatment"), day=seq(0,28,4), id=1:18) |> mutate(mean0=ifelse(group=="Control",40+.35*day,40+.65*day+4*sin(day/8)), value=rnorm(n(),mean0,3.4)) sum_df <- df |> group_by(group,day) |> summarise(mean=mean(value), se=sd(value)/sqrt(n()), lo=mean-1.96*se, hi=mean+1.96*se, .groups="drop") ggplot(sum_df,aes(day,mean,color=group,fill=group)) + geom_ribbon(aes(ymin=lo,ymax=hi),alpha=.15,color=NA) + geom_line(linewidth=1.1) + geom_point(size=2.4) + geom_vline(xintercept=12,linetype=2) + theme_classic(base_size=12) |
04|相关系数热图:geom_tile() 把矩阵数据变成一眼能读的结构
library(ggplot2) vars <- iris[,c("Sepal.Length","Sepal.Width","Petal.Length","Petal.Width")] R <- cor(vars) long_R <- as.data.frame(as.table(R)); names(long_R) <- c("Var1","Var2","r") ggplot(long_R,aes(Var1,Var2,fill=r)) + geom_tile(color="white",linewidth=.7) + geom_text(aes(label=sprintf("%.2f",r)),size=4) + scale_fill_gradient2(low="#2166AC",mid="white",high="#B2182B",midpoint=0,limits=c(-1,1)) + coord_equal() + theme_minimal(base_size=12) + theme(panel.grid=element_blank(),axis.text.x=element_text(angle=40,hjust=1)) |
05|森林图:用 geom_pointrange() 同时表达效应方向、大小和不确定性
library(ggplot2) df <- data.frame(term=c("Age","BMI","Exercise","Sleep","Smoking","Education"), estimate=c(.18,.31,-.42,-.21,.55,.12), se=c(.07,.09,.10,.08,.13,.06)) df$lower <- df$estimate-1.96*df$se; df$upper <- df$estimate+1.96*df$se ggplot(df,aes(estimate,reorder(term,estimate))) + geom_vline(xintercept=0,linetype=2,color="grey45") + geom_pointrange(aes(xmin=lower,xmax=upper),linewidth=.8) + labs(x="Standardized coefficient (95% CI)",y=NULL) + theme_classic(base_size=12) |
06|火山图:ggplot2 的图层思维特别适合“阈值 + 分类 + 标签”
library(ggplot2); library(ggrepel) set.seed(29); n <- 1400 df <- data.frame(gene=paste0("Gene",1:n),log2FC=rnorm(n,0,1.15)) df$neglogP <- pmax(abs(df$log2FC)*1.15+rgamma(n,1.2,.7)-.45,.02) df$pvalue <- 10^(-df$neglogP); df$status <- "NS" df$status[df$log2FC>1 & df$pvalue<.05] <- "Up" df$status[df$log2FC< -1 & df$pvalue<.05] <- "Down" lab <- df[order(df$pvalue)[1:6],] ggplot(df,aes(log2FC,-log10(pvalue),color=status)) + geom_point(size=1.6,alpha=.55) + geom_vline(xintercept=c(-1,1),linetype=2) + geom_hline(yintercept=-log10(.05),linetype=2) + geom_text_repel(data=lab,aes(label=gene),size=3,show.legend=FALSE) + theme_classic(base_size=12) |
 10个月宝宝每天需要喝多少奶粉?