如果让你来设计这个程序,你会怎么做?
先别急着写代码,我们一起来捋一捋思路。
核心问题: 怎么判断谁是主角?
一个很自然的想法是:谁的名字出现的次数最多,谁就是主角。
这个思路不一定完全准确,但至少是一个可以量化的起点。就像我们平时说“这本书里某某出现了很多次”,其实就是一种朴素的频率感知。
所以,我们的任务变成了:
统计《红楼梦》全文里,每个人物名字出现了多少次,然后按次数从高到低排序。
我们把大目标拆成小问题:
问题1:文本从哪里来?
需要有一份《红楼梦》的电子版全文(.txt 格式),程序才能读取这个文本文件。
问题2:怎么拿到《红楼梦》里的人物名字?
英文有空格,用 split() 就能拆开。但中文句子是连在一起的,程序不知道“词”在哪里。需要用 jieba 库来分词。
具体怎么拆分,就要看jieba库的具体用法
问题3:怎么判断谁是主角?
把人物名字出现的次数,从高到低排序。
文件操作在以后讲解“文件”时还会具体介绍,本篇只做一个入门。
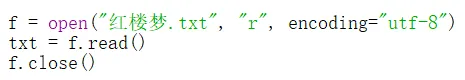
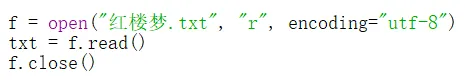
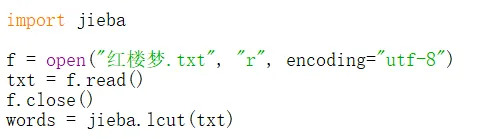
读取文本文件很简单:先打开文件,然后读取文件内容,最后关闭文件
对应着三行语句,如下所示:
open()函数的功能是“打开文件”,有三个参数:
①"红楼梦.txt"表示需要打开的文件
②"r" 表示只读(read)
③encoding="utf-8"指定编码为utf-8,保证中文正常读取
既然打开了文件,并且把文件称为f,就可以用f.read()一次性读取整个文件内容,存入变量 txt,也就意味着txt变量里存放着红楼梦.txt中所有的内容。这里的txt是字符串类型。
需要注意的是,honglou.txt 文件和py文件需要放在同一个目录下。
f.close()表示关闭文件。
以后学到文件操作时会详细展开。
上一步我们读取了《红楼梦》全文,存入了变量 txt。
运行下面这段代码,什么结果都没显示是正常的。因为仅仅是读取了文件,把所有文件内容存放在txt变量里,没有任何输出。
接下来要解决的问题是:中文没有空格,怎么把文本拆分成词语?
跟所有库的使用一样,要先导入库,才能使用库。
jieba 库最常用的方法:jieba.lcut(),l 代表 list(列表),cut 表示“切分”。lcut 表示“切分后返回列表”。
具体来说,就是接收一个字符串,返回一个列表,列表中的每个元素就是切分好的词语。
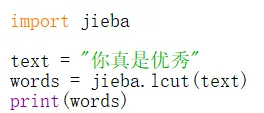
举个例子:
运行结果如下所示:
['你', '真是', '优秀']
看到没,jieba库可以把这句话自动分成三个有意义的词语。而且结果是以列表形式存储的。
对于《红楼梦》全文,我们同样用 lcut() 来处理。
这样,words 列表里就存放了《红楼梦》所有的词语。
简单来说,jieba.lcut() 就是用来中文分词的,把一整段中文切分成一个个有独立意义的词语。
试想一下,如果用print(words)直接输出分词后的结果,会怎样?
《红楼梦》全文分词后有几十万或者几百万个词,是不方便直接输出的。
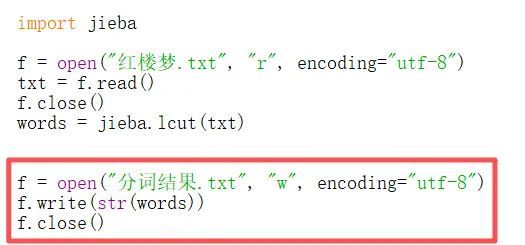
咱们可以把所有分词的结果输出到一个文件,方便查看。
跟读取红楼梦.txt文件操作类似,将生成的结果保存到分词结果.txt文件中
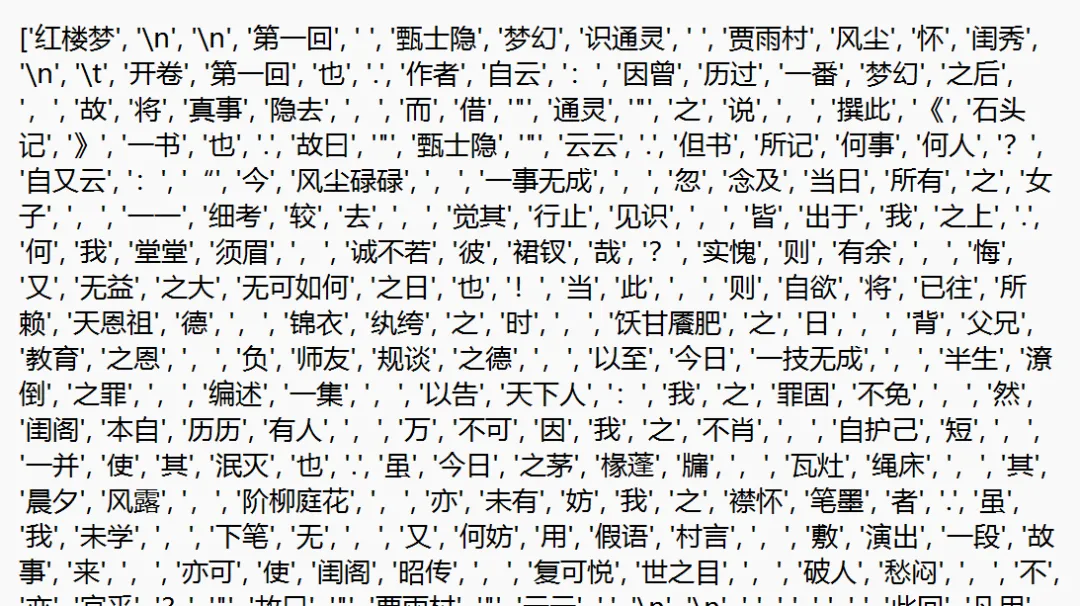
打开分词结果.txt,效果如下图所示:(仅为第一页)
是不是太庞杂了?别急,下一篇,我们将对分词结果进行处理和优化。
jieba.lcut() 到底是怎么工作的?有没有什么可以调整的地方?
接下来,我们就来深入了解一下。
下面的内容,仅适合喜欢探究的伙伴。如果你只需要完成《红楼梦》分词,已经做完了,可以跳过后面的内容。
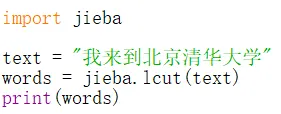
jieba.lcut() 的基本格式:
jieba.lcut(字符串, 模式) 表示将字符串按指定的模式来分词。
三种分词模式
jieba 提供了三种分词模式,适用于不同的场景。
1. 精确模式(默认)
特点: 把句子最精确地切开,适合文本分析。
运行结果如下:
['我', '来到', '北京', '清华大学']
这是最常用的模式,也是我们分析《红楼梦》时使用的模式。
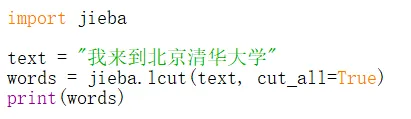
2. 全模式
特点: 把句子中所有可能的词语都扫描出来,速度最快,但可能有冗余。
运行结果如下:
['我', '来到', '北京', '清华', '清华大学', '华大', '大学']
可以看到,这句话中所有可能的词语都显示出来了,"清华大学" 被拆成了 "清华"、"清华大学"、"华大"、"大学" 等多个结果,有冗余。
3. 搜索引擎模式
特点: 在精确模式的基础上,对长词再次切分,适合搜索引擎索引。
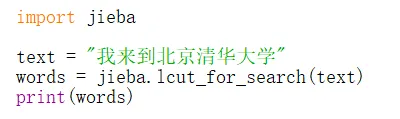
运行结果如下:
['我', '来到', '北京', '清华', '华大', '大学', '清华大学']
为什么叫搜索引擎模式?它是专门为搜索引擎设计的。
宁可多切几种可能,也要让搜索引擎能找到你。长词会被拆成更短的词,方便模糊匹配。
所以 lcut_for_search() 会多切出 "清华"、"大学" 这些短词,让搜索引擎建立索引时覆盖更多关键词。
这也是搜索引擎模式和全模式的结果很像的原因,但底层逻辑不一样。
全模式也是把词切碎,把所有可能的词都找出来,不管重不重复
搜索引擎模式是尽可能把长词拆成有检索价值的短词,方便匹配
jieba 是怎么做到的?简单来说,jieba 分三步走:
第一步:准备一个“词库”
jieba 自带一个词库,里面收录了常见的中文词语,以及每个词的使用频率。
比如词库里可能有:
词 频率
清华大学 1000
清华 800
大学 5000
华大 200
这个词库就像一本词典,jieba 拿着它去“查词”。
第二步:找所有可能的分词方式
把句子放进去,jieba 会找出所有可能的分词方案。
比如 "我来到北京清华大学":
jieba 会把所有可能都列出来,形成一个有向无环图(DAG)。这个名字听起来复杂,但你可以理解成“把所有可能的分词路径都画出来”。
第三步:选概率最大的
jieba 会根据词库里的频率,计算哪种分词方案最“合理”。
回到上面的例子:
"清华大学" 在词库里的频率是 1000
"清华" 的频率是 800,"大学" 的频率是 5000
"华大" 的频率是 200,"学" 单独成词可能匹配到 "学习"、"学生" 等词的词频,组合概率更低。
虽然 "大学" 这个词单独出现的频率比 "清华大学" 高得多,但 jieba 不是只看一个词,而是看整句话的总体得分。它会把这几个词的频率综合考虑,算出整句话的概率。方案A中 "清华大学" 作为整体出现的概率更高,所以整句得分更高,最终选择了方案A。
遇到不认识的字怎么办?
如果词库里没有这个词,jieba 怎么处理?
比如人名 "周杰伦",如果词库里没有,jieba 会根据汉字成词的规律来推测:
这是通过 HMM 模型(隐马尔可夫模型)来推测的——根据上下文和汉字组合规律,猜测哪些字应该组成一个词。
不过这个推测并不完美。如果程序里涉及到大量专有名词(人名、地名、品牌名),光靠 jieba 自己是不够的。
可以在代码中临时添加个别词语,或者准备一个词库文件,一次性加载所有自定义词语。
咱们只需要知道:jieba 不认识的新词,我们可以手动教给它。
 10个月宝宝每天需要喝多少奶粉?