你有没有发现,最近几年 AI 圈有个怪现象:Python 跑得慢大家都知道,但没人愿意换。
为什么?因为 Python 生态太强了,PyTorch、NumPy、HuggingFace……换一门语言等于从头来过。可问题是,当你真的要写 GPU kernel、要优化推理性能、要把延迟压到毫秒级的时候,Python 就像一辆自行车上高速——能跑,但跑不快。
所以过去几年,每隔一阵就有人跳出来说"我要做 Python 的替代品"。Julia、Codon、Numba……结果呢?要么生态没起来,要么性能没到位。
但上周发生了一件事,我觉得值得认真聊聊——Mojo 1.0 正式发布,紧接着编译器也开源了。
这可不是又一个"PPT 语言"。Mojo 的背后站着 Chris Lattner——LLVM、Clang、Swift、MLIR 的创始人。而他的公司 Modular,刚刚被高通收购了。
我花了不少时间研究了这个事情,今天跟你聊聊 Mojo 到底是什么来头,为什么它可能是 AI 基础设施领域最重要的编程语言变化。
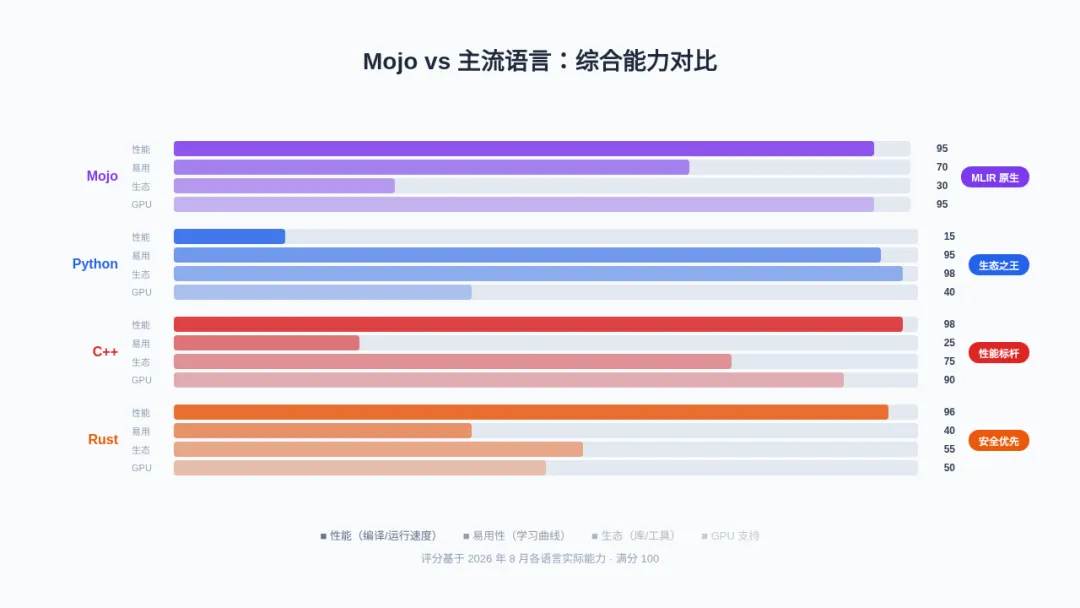
🔧 Mojo 到底是什么?一句话说清楚
Mojo 是一门编程语言,目标很简单:用 Python 的语法,达到 Rust/C++ 级别的性能,还能直接写 GPU 代码。
听起来很玄乎对吧?但你想想,Python 之所以慢,核心原因是它是动态类型+解释执行。而 Mojo 做的事情是:保留 Python 的语法风格(你可以用 fn、var、def 这些关键字),但在底层把它编译成机器码。
更关键的是,Mojo 不是走 LLVM 那条老路,而是直接建在 MLIR(Multi-Level Intermediate Representation)上。这是 Chris Lattner 在 Google 期间主导设计的下一代编译器基础设施,专门为异构计算(CPU+GPU+各种AI加速器)优化。
fast.ai 的 Jeremy Howard 在 2023 年 Mojo 刚发布时就说过一句话:"Mojo 本质上是 MLIR 的语法糖。"这个评价很到位——它不是在已有编译器上打补丁,而是从编译器层面重新设计了一门语言。
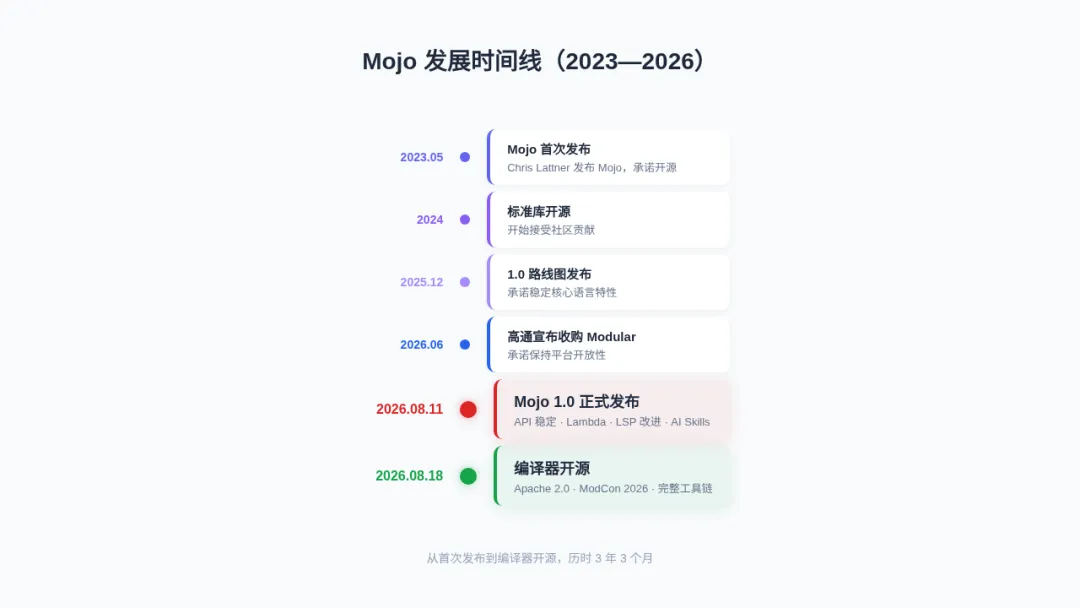
📅 时间线:从发布到开源,Mojo 经历了什么
Mojo 的故事其实挺曲折的。我帮你梳理一下关键节点:
🔸 2023年5月 — Mojo 首次发布,承诺会开源编译器。当时社区期待很高,但也有很多质疑
🔸 2024年 — 标准库开始接受社区贡献,但编译器一直是闭源的。社区对此颇有微词
🔸 2025年12月 — Modular 发布 1.0 路线图,承诺稳定核心语言特性
🔸 2026年5月7日 — Mojo 1.0 Beta 1 发布,同时上线 mojolang.org 官网
🔸 2026年6月24日 — 高通宣布收购 Modular,承诺保持平台开放性
🔸 2026年7月29日 — 高通正式完成收购
🔸 2026年8月11日 — Mojo 1.0.0 正式发布,API 稳定
🔸 2026年8月18日 — 编译器和工具链开源,Apache 2.0 许可证(含 LLVM 例外条款)
你发现没?从承诺开源到真正开源,整整过了三年。这三年里,社区对"你到底开不开源"这个问题的质疑就没停过。尤其是在高通收购之后,很多人觉得这事儿黄了。
但 Modular 在 ModCon 2026 大会上(8月18日,旧金山)直接把编译器源码放出来了。用的是 Apache 2.0 + LLVM Exceptions 许可证,跟 LLVM 项目本身的许可证一样——这意味着你可以拿去做商业项目,没问题。
⚡ 性能到底有多快?说点实际的
Modular 官方曾宣称 Mojo 比 Python 快 68,000 倍。这个数字来自特定的矩阵乘法基准测试,用了 SIMD + 并行优化。老实说,这种极端对比数字更多是营销用的,实际开发中不太会遇到这么夸张的场景。
但去掉营销滤镜,Mojo 的性能确实很能打:
🔸 在 Fibonacci 递归基准测试中,Mojo 的性能接近 Rust 和 Julia,比 Python 快 50 倍以上
🔸 矩阵乘法场景下,经过社区优化后,Mojo 已经追上 NumPy 的水平(之前一度比 NumPy 慢 4-5 倍,社区成员修复后赶上了)
🔸 对于 GPU kernel 编写,Mojo 可以直接用 Python 风格的语法写 CUDA/HIP 级别的代码,不需要学 C++
一个在 Hacker News 上讨论很多的观点是:Mojo 的性能优势主要来自编译时类型推断和 MLIR 后端优化,而不是语言本身有什么魔法。换句话说,任何能做同样优化的编译器都能达到类似性能。Mojo 的价值在于它把这个过程变得对 Python 开发者更友好。
🏗️ 技术架构:为什么 MLIR 是关键
这里要稍微深入一点技术细节,但我会尽量讲人话。
传统的编译器路径是:源代码 → LLVM IR → 机器码。LLVM 非常强大,但它有一个局限——它主要是为 CPU 设计的。当你需要编译 GPU 代码、需要处理张量操作、需要优化内存布局的时候,LLVM 就有点力不从心了。
MLIR 是 LLVM 的"下一代"。它的核心思想是:允许多个层次的中间表示共存。你可以在高层用 Python 风格的语法,在中间层用张量操作的 IR,在底层用硬件特定的指令——整个编译过程可以在不同层次做不同的优化。
这意味着什么?意味着 Mojo 可以:
🔸 SIMD 操作 — 一条指令处理多个数据,这是性能的关键
🔸 内存布局控制 — 直接控制数据在内存中的排列方式,对 GPU 计算很重要
🔸 所有权语义 — 类似 Rust 的内存安全机制,不需要垃圾回收器
🔸 异构计算 — 同一份代码可以跑在 CPU、GPU、NPU 等不同硬件上
这就是为什么高通要收购 Modular——他们需要一套能统一编程各种 AI 芯片的软件栈,而 Mojo + MLIR 正是这个方向上最成熟的技术方案。
🆚 对比:Mojo vs Python vs C++ vs Rust
我做了一个对比表,帮你快速理解 Mojo 的定位:
| 维度 |
Python |
C++ |
Rust |
Mojo |
| 性能 |
慢(解释执行) |
极快 |
极快 |
接近 C++/Rust |
| 学习难度 |
简单 |
很难 |
较难 |
中等(Python 语法) |
| 生态丰富度 |
极丰富 |
丰富 |
中等 |
早期(发展中) |
| GPU 编程 |
需借助 CUDA/框架 |
CUDA 原生 |
有限支持 |
原生 MLIR 支持 |
| 内存安全 |
GC 管理 |
手动管理 |
所有权系统 |
所有权系统 |
简单说:Mojo 想做的是"Python 的易用性 + Rust 的安全性 + CUDA 的 GPU 能力"三合一。这个定位很清晰,也很有野心。
🔍 1.0 版本带来了什么新东西
Mojo 1.0 不只是版本号变了,它带来了几个重要的变化:
🔸 源码稳定性承诺 — 1.0 之前的 Mojo 经常 breaking change,社区维护的库经常被搞坏。1.0 之后,Modular 承诺 API 稳定,不会再随意破坏兼容性
🔸 Lambda 语法 — 终于支持 Python 风格的 lambda 表达式了,写起来更 Pythonic
🔸 LSP 改进 — 编辑器的代码补全、跳转、诊断功能大幅改善,开发体验接近主流语言
🔸 Mojo AI Skills — 新增的 AI 辅助编程功能,帮助开发者更高效地写 Mojo 代码
🔸 编译时元编程 — 可以在编译时做代码生成和优化,这是性能的关键来源之一
同时,标准库在 1.0 之前就已经开源了(2024 年开始接受社区贡献),编译器则在 1.0 发布一周后开源。Modular 表示计划在 2026 年底之前开始接受编译器的社区贡献。
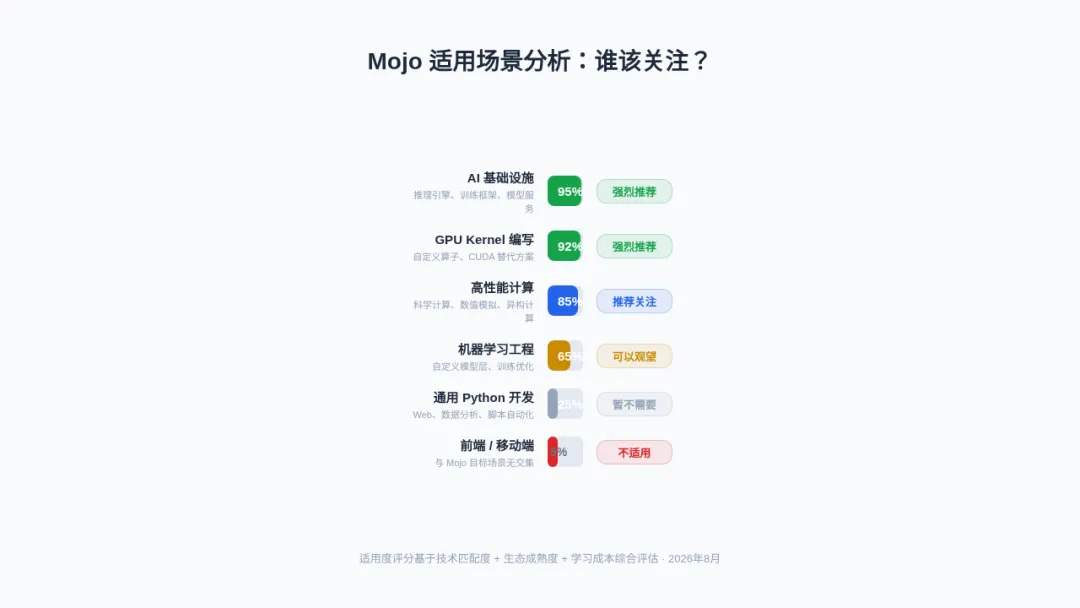
🎯 谁应该关注 Mojo?说说适用场景
这是我觉得最关键的问题。Mojo 听起来很厉害,但不是所有人都需要它。
|
✅ 强烈推荐关注
|
|
🔸 AI 基础设施工程师 — 你在写推理引擎、训练框架、模型服务,Mojo 的 MLIR 原生支持能帮你省掉大量 CUDA 调优工作
🔸 GPU kernel 开发者 — 你受够了 CUDA C++ 的繁琐,Mojo 提供了更友好的语法但不牺牲性能
🔸 高性能计算研究者 — 你需要在异构硬件上跑科学计算,Mojo 的跨平台能力很有价值
|
|
🤔 可以观望
|
|
🔸 普通 Python 开发者 — 如果你主要做 Web 开发、数据分析、脚本自动化,Python 生态完全够用,暂时不需要 Mojo
🔸 机器学习工程师 — PyTorch/JAX 已经帮你处理好了底层优化,除非你要写自定义算子,否则 Mojo 的优势不明显
|
|
⏳ 暂时不需要
|
|
🔸 前端/移动端开发者 — Mojo 的目标场景跟你的工作基本没有交集
🔸 初学者 — Mojo 生态还太早期,学习资源有限,建议先打好 Python 基础
|
💡 高通收购意味着什么?商业模式猜想
2026 年 6 月,高通宣布收购 Modular,7 月底完成交割。这个收购背后的逻辑很清晰:
高通在 AI 芯片领域一直想跟 NVIDIA 竞争,但苦于 CUDA 生态的护城河太深。收购 Modular 意味着高通拿到了 Mojo + MAX 平台,可以为自家的 AI 芯片(包括手机端 NPU 和数据中心加速卡)提供一套统一的编程工具。
Chris Lattner 在 LinkedIn 上说了一句话很有意思:"AI 开发者应该有选择硬件的自由。"翻译一下:我们想打破 NVIDIA CUDA 的垄断。
这也是为什么编译器必须开源——如果 Mojo 的编译器是闭源的,其他硬件厂商(AMD、Intel、Google)根本不会考虑支持它。只有开源,才能让 Mojo 成为真正的行业标准。
⚠️ 风险和不确定性
当然,Mojo 不是没有风险。我列几个你需要注意的点:
🔸 生态早期 — 虽然编译器开源了,但 Mojo 的第三方库、工具链、教程资源都还很匮乏。现在用 Mojo 开发,很多事情需要自己造轮子
🔸 社区贡献限制 — 目前 Modular 还不接受编译器的外部贡献,计划 2026 年底开放。这意味着编译器的发展方向还是 Modular 说了算
🔸 高通收购的不确定性 — 虽然高通承诺保持平台开放,但大公司收购小公司后改变方向的案例太多了。长期来看,Mojo 能否保持 vendor-neutral 还是个问号
🔸 Python 兼容性 — Mojo 号称"Python 超集",但实际上并不兼容所有 Python 代码。很多 Python 库(比如 Pydantic)在 Mojo 上跑不了,因为它们依赖的动态特性 Mojo 不支持
🔸 竞争对手 — NVIDIA 有 cuTile Python(让 Python 直接编译到 CUDA),Julia 也在持续进化,Mojo 的窗口期并不是无限的
🚀 如何快速上手
如果你决定试试 Mojo,这是最快的路径:
🔸 在线 Playground — 访问 playground.modular.com,不需要安装任何东西,直接在浏览器里写 Mojo 代码
🔸 本地安装 — 运行 curl -s https://get.modular.com | sh - 然后 modular install mojo
🔸 VS Code 扩展 — 搜索 "Mojo" 安装官方扩展,获得语法高亮和 LSP 支持
🔸 GitHub 仓库 — 编译器源码在 github.com/modular/mojo,可以研究内部实现
一个简单的 Mojo 代码示例,感受一下语法:
fn fibonacci(n: Int) -> Int:
if n <= 1:
return n
return fibonacci(n - 1) + fibonacci(n - 2)
fn main():
let result = fibonacci(30)
print("Fibonacci(30) =", result)
看着很像 Python 对吧?但这段代码会被编译成机器码执行,性能比等价的 Python 代码快几十倍。
📝 我的看法
说实话,Mojo 1.0 + 开源编译器这件事,是我 2026 年看到的最重要的编程语言事件之一。
不是因为它已经完美了——它的生态还很早期,社区还在成长,高通收购带来的不确定性也还在。而是因为它解决了一个真实存在的痛点:AI 开发者被困在"Python 太慢"和"C++ 太难"的二选一里太久了。
Mojo 给了第三个选项。而且这个选项的背后,站着一个曾经改变了整个编译器行业的人。
如果你是做 AI 基础设施的,我建议现在就开始关注 Mojo,甚至花几天时间上手试试。如果你是普通 Python 开发者,可以先观望,等生态再成熟一些。
但不管怎样,Mojo 这个方向是对的。编译器已经开源了,剩下的就看社区能不能把它推到下一个高度了。
|
💬 互动时间
|
|
你觉得 Mojo 能取代 Python 成为 AI 领域的主流语言吗?
你在工作中有遇到"Python 太慢但 C++ 太麻烦"的场景吗?
欢迎在评论区聊聊你的看法 👇
|
|
👆 觉得有用?点个关注不迷路
点赞 + 在看,是对作者最大的支持 ❤️
|
