python数据可视化技巧的100个练习 -- 54. 分类数据的因素图
重要性★★★★☆
难度★★★☆☆
一家零售公司希望分析不同门店的顾客满意度。
该公司进行了一项调查,收集了来自三家不同门店(A店、B店、C店)顾客的满意度评分(1 到 5)。
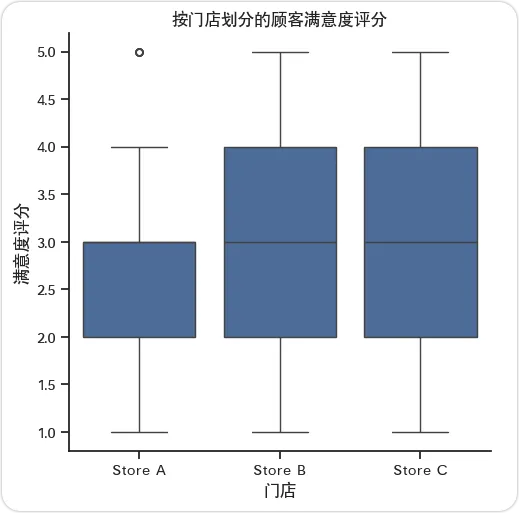
你的任务是创建一个因素图,以可视化这些门店的顾客满意度评分分布。
这将帮助公司了解不同门店之间的顾客满意度是否存在显著差异。
在代码中生成输入数据。
【数据生成代码示例】
import pandas as pdimport numpy as npnp.random.seed(0)data = { 'Store': ['Store A'] * 100 + ['Store B'] * 100 + ['Store C'] * 100, 'Satisfaction': np.random.choice([1, 2, 3, 4, 5], 300, p=[0.1, 0.2, 0.4, 0.2, 0.1])}df = pd.DataFrame(data)
【图表答案】
【代码答案】
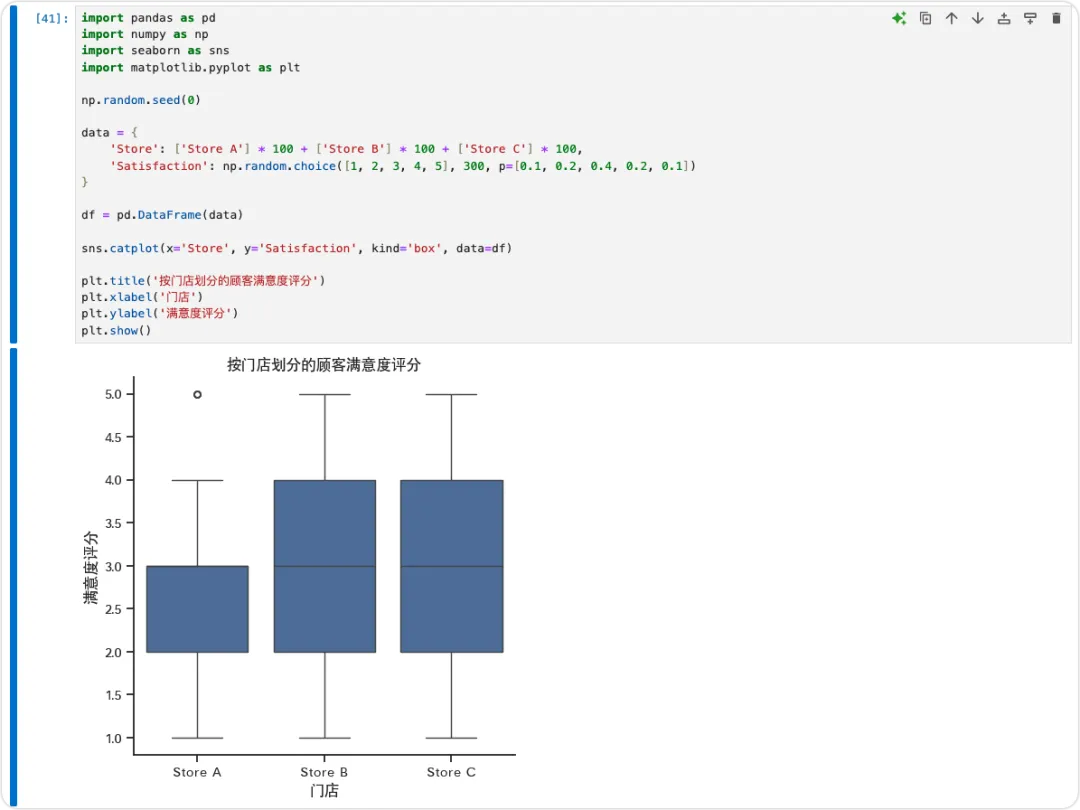
import pandas as pdimport numpy as npimport seaborn as snsimport matplotlib.pyplot as pltnp.random.seed(0)data = { 'Store': ['Store A'] * 100 + ['Store B'] * 100 + ['Store C'] * 100, 'Satisfaction': np.random.choice([1, 2, 3, 4, 5], 300, p=[0.1, 0.2, 0.4, 0.2, 0.1])}df = pd.DataFrame(data)sns.catplot(x='Store', y='Satisfaction', kind='box', data=df)plt.title('按门店划分的顾客满意度评分')plt.xlabel('门店')plt.ylabel('满意度评分')plt.show()
要解决这个问题,我们首先需要生成输入数据。
我们使用 NumPy 和 pandas 创建一个 DataFrame,模拟三家门店的顾客满意度评分调查结果。
我们设置随机数生成器的种子,以确保结果可重复。
满意度评分是根据指定的概率随机生成的。
pandas DataFrame 以两列存储这些数据:“Store” 和 “Satisfaction”。
接下来,我们使用 seaborn 库创建一个因素图。
Seaborn 是基于 matplotlib 构建的强大可视化库,提供了用于统计图表的高级函数。
在这里,我们使用sns.catplot(),并设置kind='box'来创建箱线图,该图可视化了每个门店的满意度评分分布。
箱线图显示了中位数、四分位数和潜在异常值,清晰地总结了数据分布。
我们为 x 轴和 y 轴设置标题和标签,使图表更具信息量。
最后,调用plt.show()显示图表。
这种可视化有助于比较不同门店的顾客满意度,揭示任何显著差异。
【小知识】
箱线图适用于检测异常值和了解数据的分布范围。
Seaborn 提供了许多其他分类图表,如条形图、计数图和小提琴图,每种图表都适用于不同类型的数据分析。
使用随机数生成器的种子可确保结果可重复,这对于数据分析中的调试和比较结果至关重要。
系列完整内容可以在公众号主页搜索或点击分栏找到,欢迎扫码关注预防迷路找不到。感谢您的支持与相伴。
 10个月宝宝每天需要喝多少奶粉?