代码迁移这件事,终于不再是体力活了
在很长一段时间里,我们都把系统迁移当成一种“必要但痛苦的事情”。
不是不会做,而是不想做。
一、为什么我们又一次走上了迁移这条路
事情的起点很普通:
- • 每一次改动,都要反复确认“会不会影响旧逻辑”,维护成本高
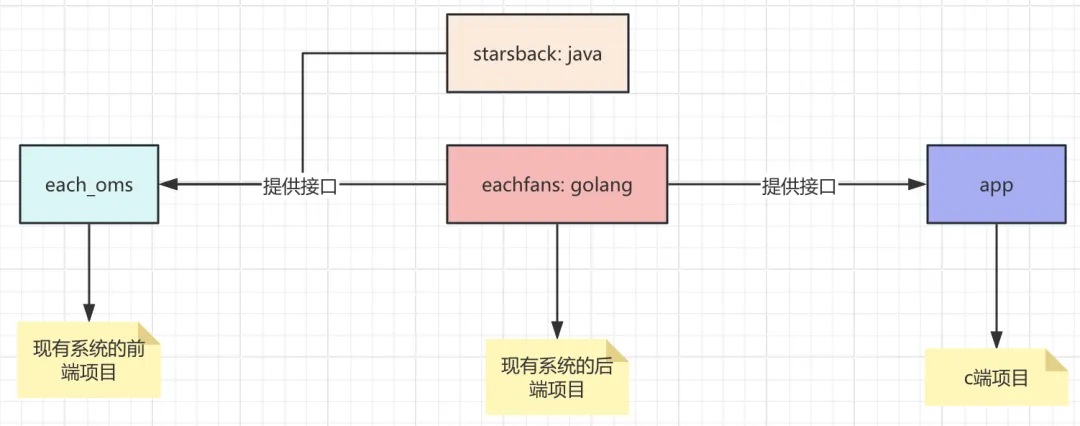 老系统架构
最典型的状态是:系统还能跑,但没人敢大改。
继续堆功能,技术债只会越来越重;推倒重来,又意味着一次不可控的工程风险。
最终我们达成共识:
迁移不是为了追新技术,而是为了让系统重新“可维护”。
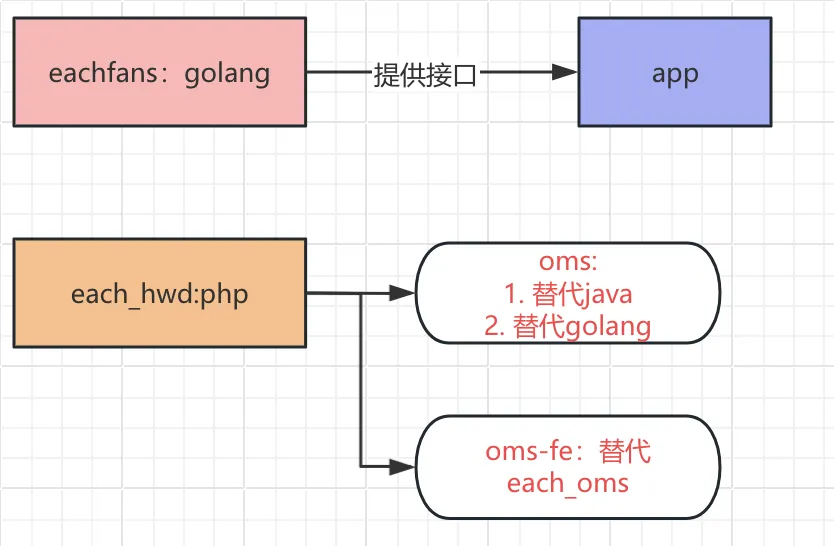 新系统架构
二、迁移真正消耗人的地方,从来不是技术难度
真正开始拆解任务后,我们发现一个很现实的问题:
迁移里 80% 的工作,几乎没有技术含量。
包括但不限于:
这些事情的特点非常一致:
而真正需要工程师思考的部分——架构边界、业务语义、数据一致性,反而只占很小一部分。
问题在于:人被大量“脏活累活”拖住了。
三、传统迁移方式,为什么总是效率低
在使用新的工具之前,我们几乎把能试的方法都试过了:
它们并非没用,但局限非常明显:
迁移做到后期,经常出现一种状态:
人不是在写代码,而是在对付代码。
四、我们是如何把 Codex 引入迁移流程的
需要先说清楚一点:我们并不是抱着“让 AI 自动完成迁移”的期待去用 Codex 的。
我们的目标非常明确:
让它接管那些规则明确、重复度高、不值得人反复消耗精力的工作。
在实际使用前,我们先做了清晰的边界划分。
适合交给 Codex 的事情
坚决不交给 Codex 的事情
一句话总结就是:
让它做执行者,而不是决策者。
五、Codex 在迁移中是如何发挥作用的
实际使用时,我们发现效果比预期更稳定。
典型流程大致是:
在这种前提下:
大约有 70%–80% 的结果可以直接使用。
剩下的工作变成了:
迁移的工作性质发生了明显变化:
从“连续高强度编码”,变成了“规则制定 + 校验”。
🔧 插一句:我们实际用的,并不只是一个 Codex
到这里,通常会有人问一个很现实的问题:
你们用的是哪一个 Codex?是官方接口,还是某个平台?
这个问题本身就说明了一件事:当 AI 真正进入工程流程后,“能不能稳定用”本身,就成了生产力问题。
在实际迁移中,我们并不是只用单一模型:
但现实问题也很直接:
后来我们干脆把这件事工程化了。
🔧 aiconding.sh:把 AI 写代码这件事“稳定下来”
目前我们使用的是 aiconding.sh 提供的镜像服务。
它解决的并不是“AI 能不能写代码”,而是几个非常工程化的痛点:
- • Claude / Codex / Gemini 同一入口可用
简单说,它的价值不是让你第一次用上 AI,而是让你可以放心把 AI 接进日常工程流程。
https://aicoding.sh/i/hubawc: 使用此链接注册并购买套餐后,可发送平台订单号+UID到本公众号领取额外福利。
六、迁移实战演示
老项目新项目放置同一目录
这样做可以方便codex读取项目代码:
☁ 项目迁移 tree -L 1 -d.├── each-oms-main:老项目├── each_hwd:新项目├── eachfans-main:老项目└── starsback-manager-master:老项目
撰写一份README
这份README中主要是介绍项目、划分 codex 边界、定义规则
☁ 项目迁移 cat README.md# 角色说明你是一名经验丰富的全栈开发工程师,你精通golang、php、java等服务端语言,同时精通javascript、css、html等前端语言,对于常用服务端和前端框架都非常熟悉。# 职责描述你需要完成一个重构任务。为此,你需要将任务分解为多个步骤,并逐步完成。对于每个步骤,你需要:1. 理解本次重构任务要做的事情2. 查看本次重构任务的涉及的原代码逻辑并将完整原逻辑整理成文档输出到docs下3. 按照原逻辑进行代码重构工作4. review原逻辑与重构后的新逻辑,保证逻辑不变,原逻辑使用到缓存key的地方要重点注意是否有前缀、后缀# 待重构项目说明each-oms-main:老cms系统项目的前端页面及逻辑,他请求的接口来自于两部分,一部分位于eachfans-main,一部分位于starsback-manager-master,根据请求路由区分,japi转发至starsback-manager-mastereachfans-main:老项目,golang语言,其中cms目录下是给老管理后台的接口starsback-manager-master:老项目,java语言,有给老管理后台提供接口each_hwd:新管理后台项目,用于替代eachfans-main、each-oms-main、starsback-manager-master中老cms项目的逻辑将eachfans-main\cms现有功能和starsback-manager-master现有功能迁移至each_hwd下each_hwd\oms用于存放迁移过来的接口each_hwd\oms-fe用于构建迁移后的页面# 重构注意事项1.接口返回风格:以OMS为准2.接口、页面逻辑:严格按照原CMS逻辑
与 codex 交互对话,完成代码迁移重构
这部分就是以自然语言的方式与 codex 进行交互对话,不断迭代,直至某个功能迁移完成。其中包括核心代码review、功能测试、逻辑微调。
› README.md 先看下这个• 已看完 README.md(README.md),要点如下: - 范围:把老 CMS 的前后端能力从 eachfans-main(Go,cms 目录)和 starsback-manager-master(Java,后台接口)迁移到新仓 each_hwd(PHP Hyperf:api/oms;前端 Vue2:oms-fe)。 - 路径规范:后端迁移到 each_hwd/oms,前端页面迁移到 each_hwd/oms-fe。 - 约束:接口返回风格以 OMS 为准;页面/接口逻辑必须与原 CMS 严格一致;涉及缓存 key 的地方要特别核对前后缀。 - 现状补充:each_hwd/README 说明了技术栈(Hyperf + Vue2)与启动方式;eachfans-main/apps/cms/api/cms.api 列出了大量 CMS 路由与 handler,可作为迁移清单的权威来源。 建议下一步(待你确认后开始): - 生成清单:从 eachfans-main/apps/cms/api/cms.api 抽取全部接口,按领域分组输出到 each_hwd/docs(便于对照迁移)。 - Java 侧梳理:扫描 starsback-manager-master 的后台 Controller(@RequestMapping),补齐“老 CMS -> Java”调用清单。 - 页面映射:扫描 each-oms-main 的页面与请求,建立“页面 -> 接口 -> 目标后端(Go/Java)”矩阵,标注 japi 转发处。 - 目标协议:在 each_hwd/docs 定义 OMS 返回格式与旧返回的映射规则(字段、包装、错误码)。 - 迁移落地:在 each_hwd/oms 建立对应 Controller/Route 桩与 Service 结构,在 each_hwd/oms-fe 建立页面/路由骨架;按模块分批迁移与联调。 - 缓存审计:建立缓存 key 清单(含前后缀/TTL/失效策略),迁移时逐一对齐。 我已创建一个执行计划草案(未动代码)。需要的话,我可以先从“接口清单抽取 + 文档生成”开始,随后做页面映射。请确认: 1. 是否按上述步骤推进?有无优先迁移的模块(例如用户/房间/礼物/薪资); 2. OMS 返回风格是否已有范例接口或规范文档(each_hwd/oms 中是否已有现成的响应包装约定); 3. 是否需要短期继续依赖 Java 服务(先透传/转发),还是全部改为在 Hyperf 内实现?
本次示例我们将展示一下 codex 如何帮助我们完成“封禁管理”功能的迁移。
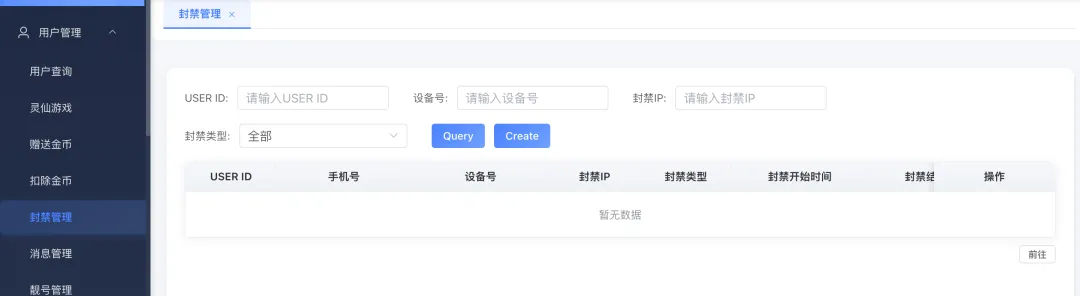 迁移示例-封禁管理列表
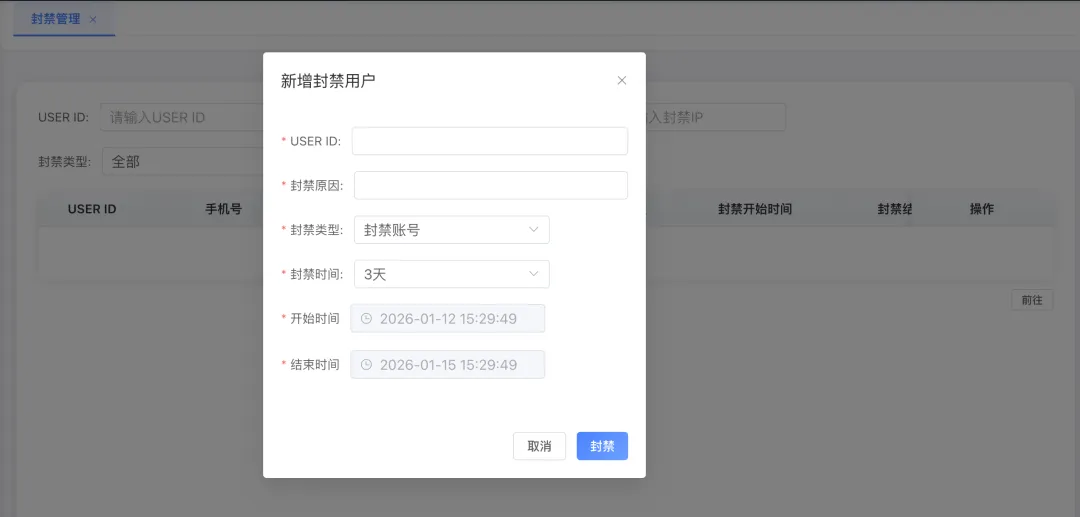 迁移示例-封禁管理-新建
七、效率变化,比想象中更明显
我们没有做特别夸张的数据统计,但体感非常一致:
- • Review 更聚焦在“逻辑正确性”而不是格式
上面的封禁管理功能迁移,以前至少1人/5天完成,而且这个人还得是全栈工程师才行。而使用AI迁移,整个流程只花了30分钟就搞定了。
最重要的一点是:迁移不再让人抗拒。
当工程师不再被大量重复劳动消耗时,真正重要的判断反而更容易做好。
八、Codex 能做的,其实远不止迁移
如果只把 Codex 当成“迁移工具”,其实有点低估它了。
在迁移之外,它同样适合:
从这个角度看,它更像是:
工程团队经验的放大器,而不是替代者。
🔧 如果你只是想“先用起来”
当然,并不是每个人一开始就会进入重度工程使用阶段。
如果你只是:
那 subsub.cn 提供的 ChatGPT Plus 个人月卡升级,会是一个更低门槛的选择。优惠阶段只需16美元。
很多人真正开始高频使用 AI,往往就是从这里开始的。
 subsub充值
八、一些必须提前说清楚的坑
如果你也打算在迁移中使用 Codex,有几点经验非常重要:
- 1. 规则一定要写清楚模糊输入,只会得到模糊结果。
- 2. 不要跳过工程纪律单元测试、Code Review 不能少。
- 3. 不要一次性喂太多上下文小步迁移,质量更稳定。
我们很快就意识到:
AI 写代码,不等于不需要工程规范,恰恰相反,它更依赖规范。
九、当迁移不再痛苦,技术演进才真正开始
回头看这次迁移,最大的变化并不是“快了多少”,而是心理负担明显降低了。
当迁移不再意味着:
技术团队才真正有勇气去持续演进系统。
最后,用一句很工程师的话来总结:
迁移本身不是问题,让人长期做低价值重复劳动,才是问题。
