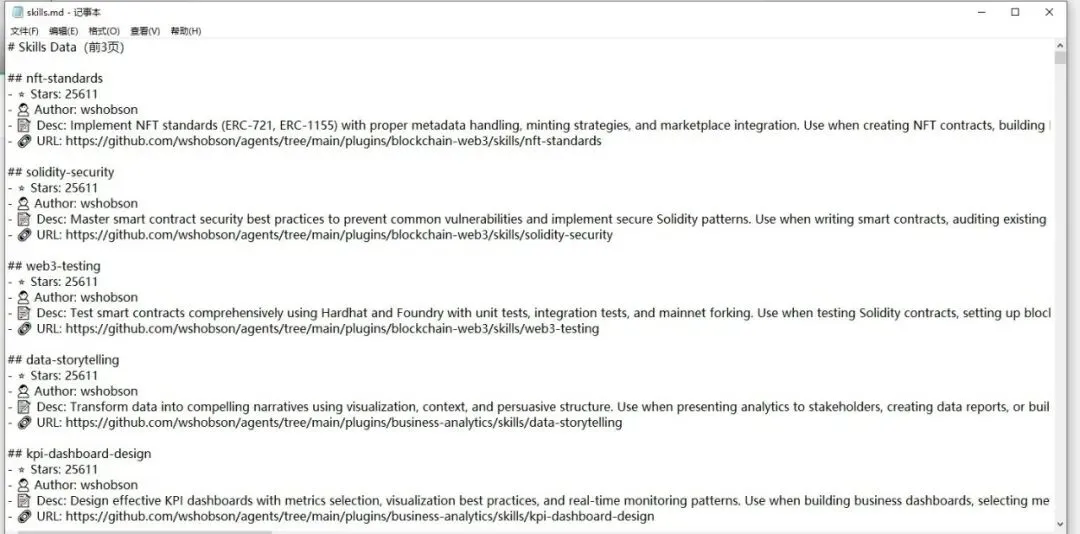
import asyncioimport jsonfrom pyppeteer import launch# ===================== 配置项(可按需修改) =====================# 本地Edge浏览器的实际安装路径EDGE_PATH = r"C:\Program Files (x86)\Microsoft\Edge\Application\msedge.exe"# 爬取范围(起始页/结束页)START_PAGE = 1END_PAGE = 666# 每页请求条数LIMIT = 100# 请求超时时间(毫秒)REQUEST_TIMEOUT = 30000# 浏览器启动超时时间(毫秒)BROWSER_TIMEOUT = 120000# 每页爬取间隔(秒)SLEEP_SEC =0.1# 输出文件路径OUTPUT_FILE = "skills.md"# ===================== 核心爬取逻辑 =====================async def crawl_single_page(browser, page_num): """ 爬取单个页面的数据 :param browser: 浏览器实例 :param page_num: 要爬取的页码 :return: 该页爬取到的数据条数 """ # 1. 创建新标签页(每次爬取都新建,避免缓存/会话干扰) page = await browser.newPage() # 2. 移除浏览器自动化标识(反反爬核心) await page.evaluateOnNewDocument(""" Object.defineProperty(navigator, 'webdriver', { get: () => undefined }); """) page_data_count = 0 # 记录当前页爬取的数据条数 try: # 3. 定义响应拦截器:捕获API返回的原始JSON数据 api_response = None def capture_api_response(res): nonlocal api_response # 仅捕获当前页码的API响应,避免干扰 if f"page={page_num}" in res.url and res.status == 200: api_response = res page.on("response", capture_api_response) # 4. 构造API请求地址并发起请求 api_url = ( f"https://skillsmp.com/api/skills" f"?page={page_num}&limit={LIMIT}" f"&sortBy=stars&marketplaceOnly=false&source=home" ) await page.goto( api_url, waitUntil="domcontentloaded", # 仅等待DOM加载完成,提升效率 timeout=REQUEST_TIMEOUT ) # 5. 解析并保存数据 if api_response: # 读取原始JSON响应文本 json_str = await api_response.text() # 解析JSON数据 data = json.loads(json_str) skills = data.get("skills", []) if skills: page_data_count = len(skills) # 追加写入Markdown文件 with open(OUTPUT_FILE, "a", encoding="utf-8") as f: for skill in skills: f.write(f"## {skill.get('name', '未知技能名')}\n") f.write(f"- ⭐ 星级: {skill.get('stars', 0)}\n") f.write(f"- 👤 作者: {skill.get('author', '未知作者')}\n") f.write(f"- 📝 描述: {skill.get('description', '无描述')}\n") f.write(f"- 🔗 GitHub链接: {skill.get('githubUrl', '无链接')}\n\n") print(f"✅ 第{page_num}页爬取成功:{page_data_count}条数据") else: print(f"ℹ️ 第{page_num}页无有效数据") else: print(f"❌ 第{page_num}页未捕获到API响应") except Exception as e: print(f"❌ 第{page_num}页爬取出错:{str(e)[:80]}") # 6. 爬取完成后立即关闭当前标签页(核心需求) await page.close() print(f"🔒 第{page_num}页标签页已关闭\n") return page_data_countasync def main(): """主函数:初始化浏览器+循环爬取所有页面""" # 1. 初始化输出文件(清空原有内容) with open(OUTPUT_FILE, "w", encoding="utf-8") as f: f.write("# SkillsMP 技能数据汇总\n") f.write(f"爬取范围:第{START_PAGE}-{END_PAGE}页 | 爬取时间:{asyncio.get_event_loop().time()}\n\n") # 2. 启动本地Edge浏览器(配置反反爬+超时) print("🚀 启动Edge浏览器...") browser = await launch( executablePath=EDGE_PATH, # 指定本地Edge路径 headless=False, # 显示浏览器窗口(调试用,改为True则静默) args=[ "--no-sandbox", # 关闭沙箱模式(Windows可省略,Linux必需) "--disable-blink-features=AutomationControlled" # 移除自动化特征 ], ignoreDefaultArgs=["--enable-automation"], # 禁用自动化提示 defaultViewport=None, # 使用浏览器默认视口大小 timeout=BROWSER_TIMEOUT # 浏览器启动超时 ) # 3. 循环爬取指定范围的页面 total_data_count = 0 # 记录总爬取数据条数 for page_num in range(START_PAGE, END_PAGE + 1): print(f"📌 开始爬取第{page_num}页(共{END_PAGE}页)...") # 爬取当前页并累加数据条数 page_count = await crawl_single_page(browser, page_num) total_data_count += page_count # 每页爬取后等待指定时间(反反爬) await asyncio.sleep(SLEEP_SEC) # 4. 爬取完成后关闭浏览器 print("🔚 所有页面爬取完成,关闭浏览器...") try: await asyncio.wait_for(browser.close(), timeout=10.0) except asyncio.TimeoutError: print("⚠️ 浏览器关闭超时,强制终止") # 5. 输出爬取结果汇总 print(f"\n🎉 爬取完成!") print(f"📊 汇总:共爬取{END_PAGE - START_PAGE + 1}页,累计{total_data_count}条数据") print(f"💾 数据已保存至:{OUTPUT_FILE}")# ===================== 程序入口 =====================if __name__ == "__main__": # 解决Windows系统asyncio事件循环兼容问题 asyncio.set_event_loop_policy(asyncio.WindowsSelectorEventLoopPolicy()) # 创建并运行事件循环 loop = asyncio.new_event_loop() asyncio.set_event_loop(loop) try: loop.run_until_complete(main()) finally: loop.close() # 确保事件循环正常关闭