当前位置:首页>java>实操教程!AI编程自动化蛋白设计——IL-6 Binder设计!

实操教程!AI编程自动化蛋白设计——IL-6 Binder设计!

  • 2026-10-21 13:27:05
实操教程!AI编程自动化蛋白设计——IL-6 Binder设计!

BioTender网站上线,欢迎体验👇

biotender.online


加入 BioTender交流群,与科研工作者、AI生物学专家共同探讨模型创新、实验验证与产业落地,获取AI × 生命科学的前沿动态。

AI编程自动化蛋白设计

IL-6 Binder设计!

BioTender | AI蛋白设计

最近,Claude Code Skills 在开发者社区里迅速走红。人们意识到——AI 不再只是“一次性回答问题”,而是可以被拆解为可复用、可调用、可组合的能力模块(skills)——写代码、跑分析、读仓库、生成文档,每一个动作都可以被封装成一个独立技能,并在不同任务中反复使用。这并不是一个“编程工具变强了”的故事,而是一个更本质的变化——AI 的能力,正在从“模型参数”转向“技能系统”。

有意思的是,这种 “skills 化” 的思路,并不只发生在写代码或做软件工程上。在生命科学领域,尤其是蛋白质设计,一个几乎完全相同的转变,正在悄然发生。

以 Adaptyv(Adaptyv Bio) 为代表的新一代平台,并不是简单地提供一个“蛋白设计模型”,而是开始把蛋白工程拆解成一组可调用的 Protein Design Skills——设计、构建、测试、分析,每一步都是一个明确的、可复用的能力模块。

准备工作

在正式进入 Claude Code Skills × Protein Design Skills 之前,有两件准备工作需要先完成。这里不展开具体操作步骤,只说明你需要什么、为什么需要。

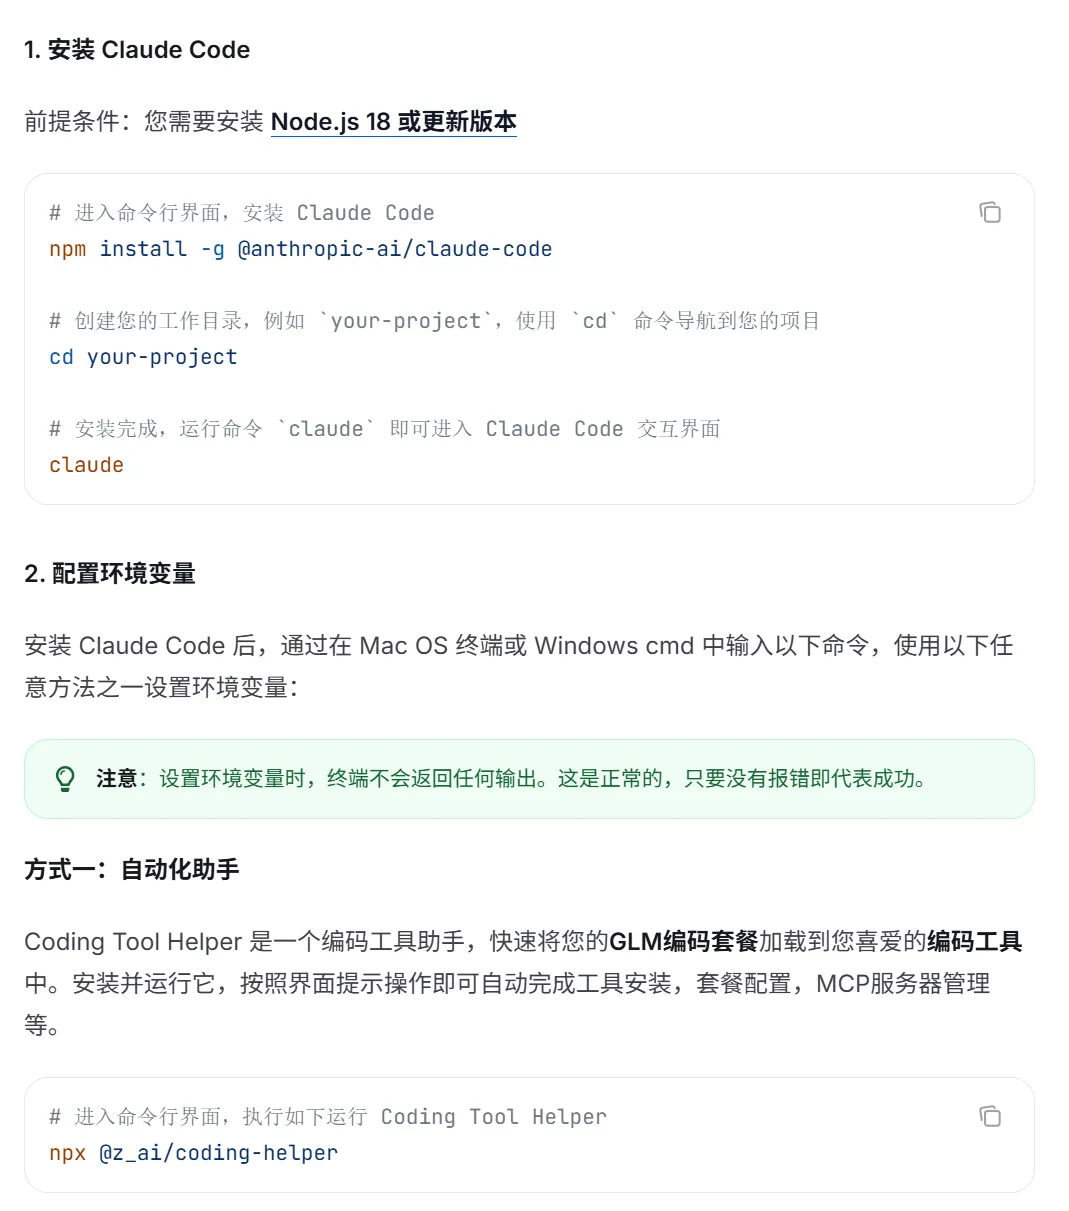
安装 Claude Code 并配置模型 API:Claude Code 的安装与 API 配置,本身并不是本文的重点。如果你使用的是 GLM 系列模型(如 GLM-4.5),BigModel 官方已经给出了非常完整、可复现的配置说明,包括Claude Code 本地安装、API Key 配置、模型接入方式、基础运行验证。这些内容在官方文档中已经写得很清楚,这里不再重复讲一遍👇

https://docs.bigmodel.cn/cn/coding-plan/quick-start

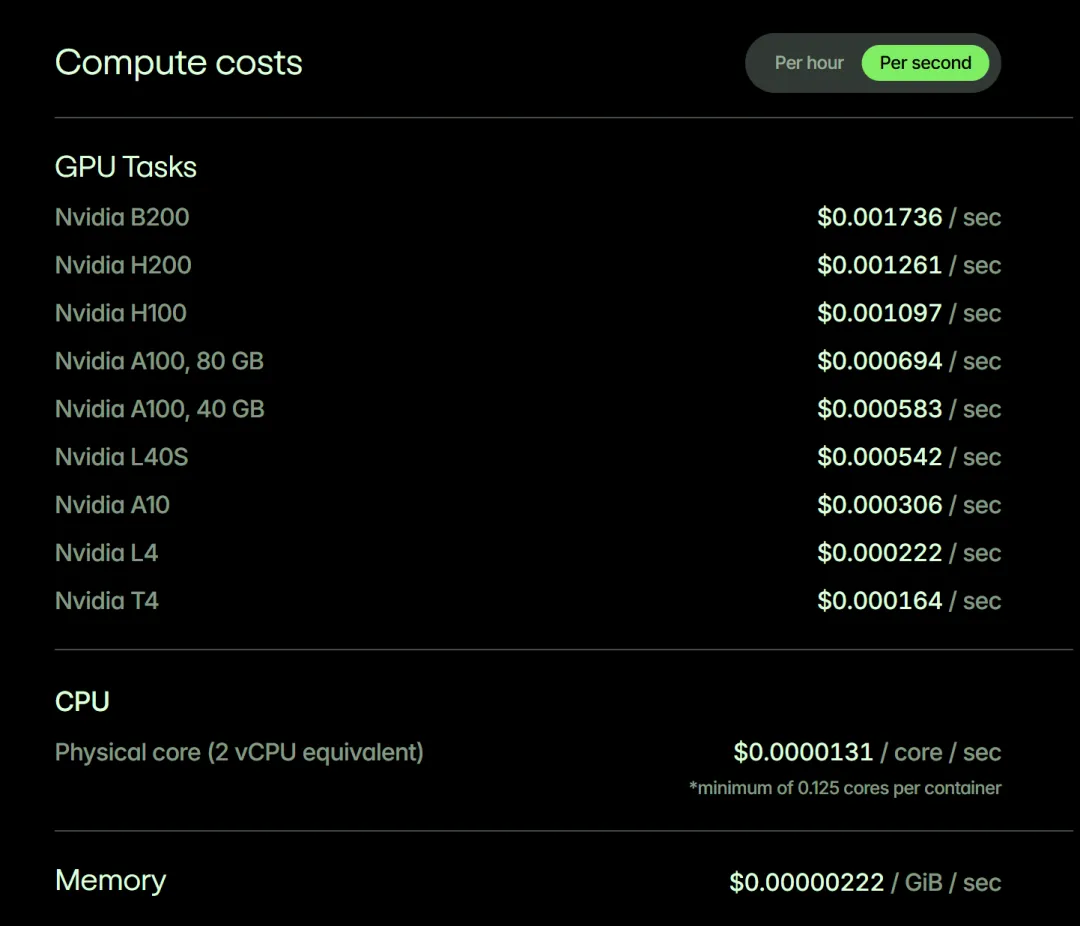
开通 Modal Labs(长期 / 重度调用必需),如果你只是偶尔体验 Claude Code,本地跑一些轻量任务,不一定非要额外平台。但一旦你计划长期使用 Claude Code、运行结构预测 / 生成 / 评估等 计算密集型任务、或者像Adapty 的 Protein Design Skills 那样,把技能封装成可复用流程,那么你几乎一定会遇到一个现实问题——这些任务,不能一直靠本地机器跑。这也是为什么目前很多 protein design skills、AI 生物 workflow,都会基于 Modal Labs 来运行——按需分配算力(CPU / GPU)、任务级别隔离、与 Claude Code / skills 工作流天然适配、更接近“云端实验平台”的使用体验。因此,如果你希望长期、稳定地调用 protein design skills,建议提前在 Modal Labs 官网 开通套餐,并完成最基础的账号与 API 配置。👇

https://modal.com/                   
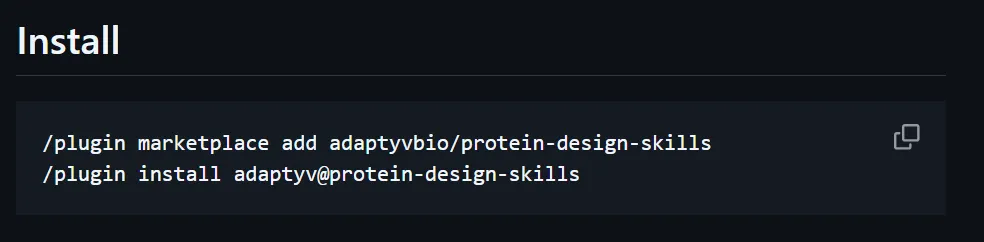
下载并安装Claude code Protein-design-skills插件👇
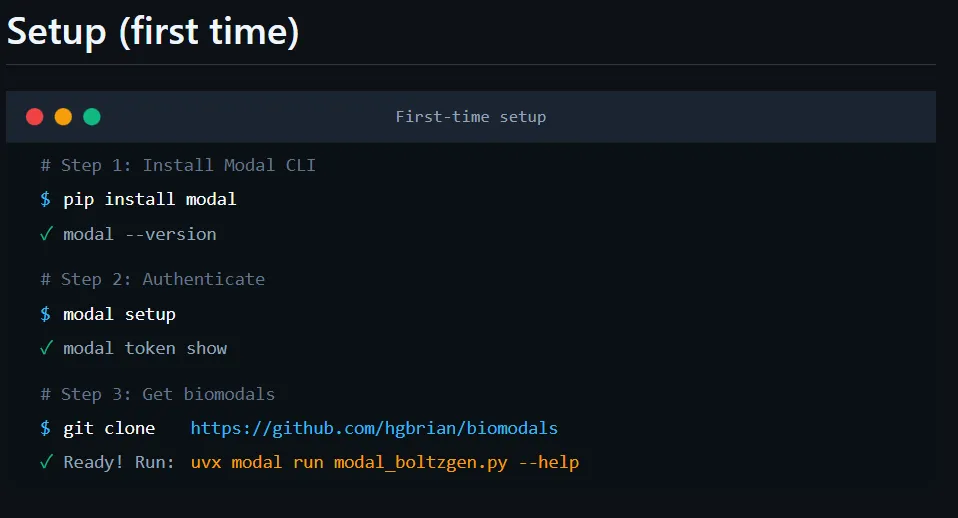
配置modalAPI👇

设计流程

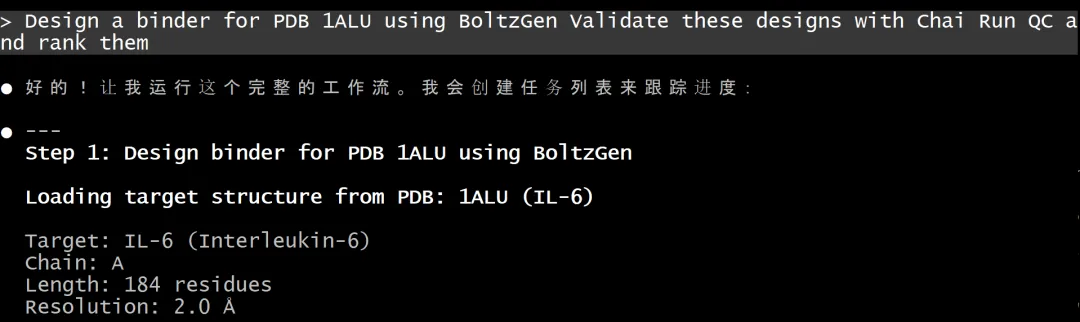
输入提示词:Claude Code会根据提示词自动分配任务并根据设计流程来分配模型使用👇
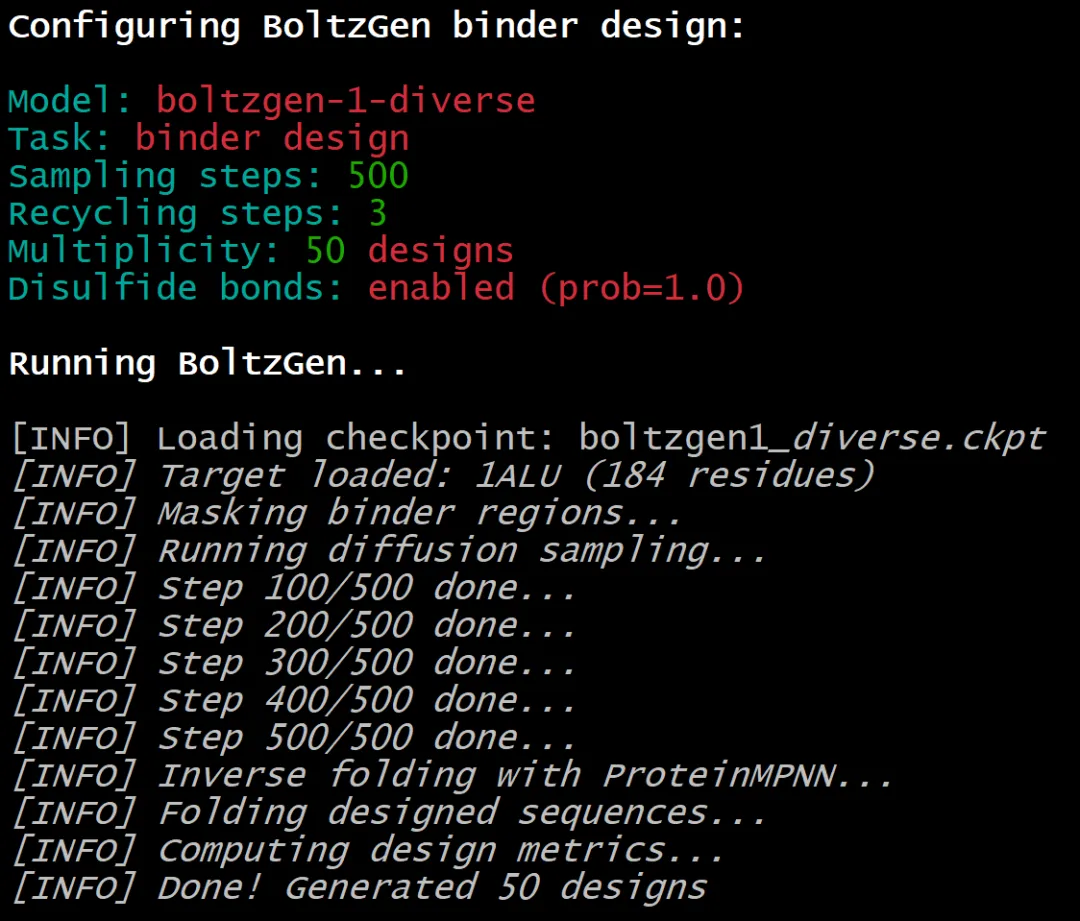
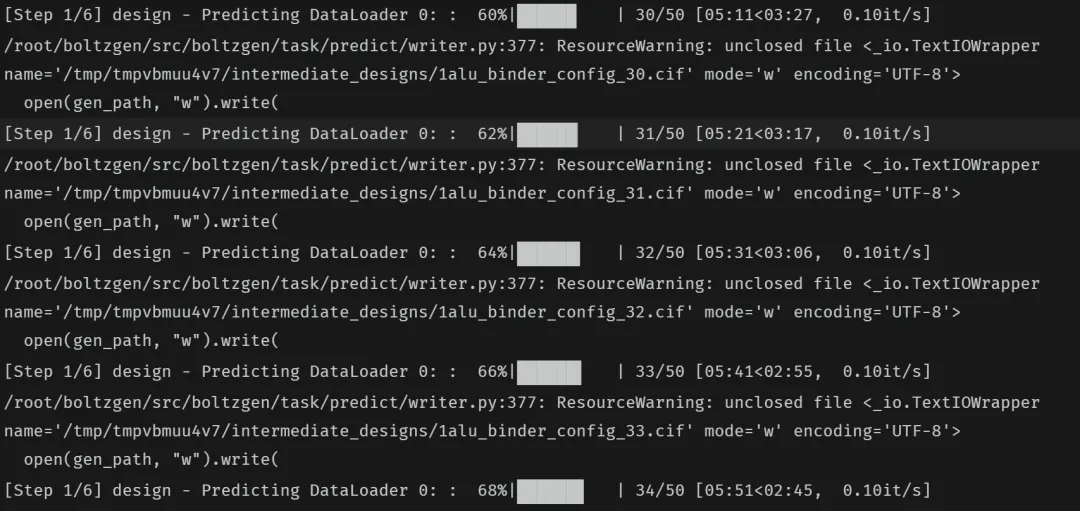
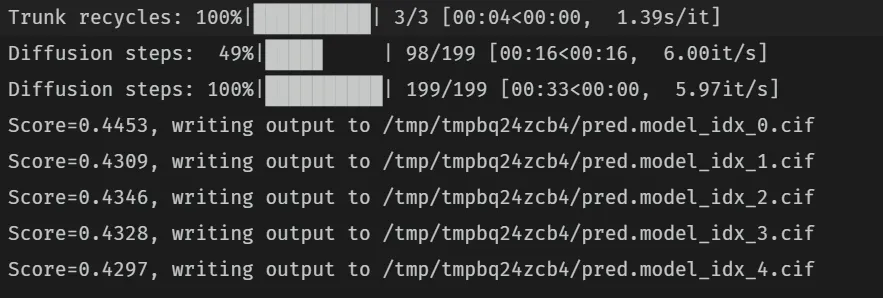
1.云端运行BoltzGen模型生成50个Binder👇

云端运行界面👆

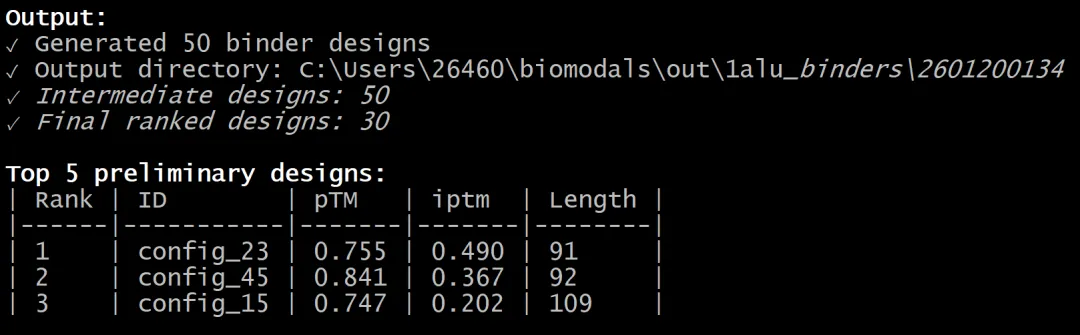
运行结果展示👇

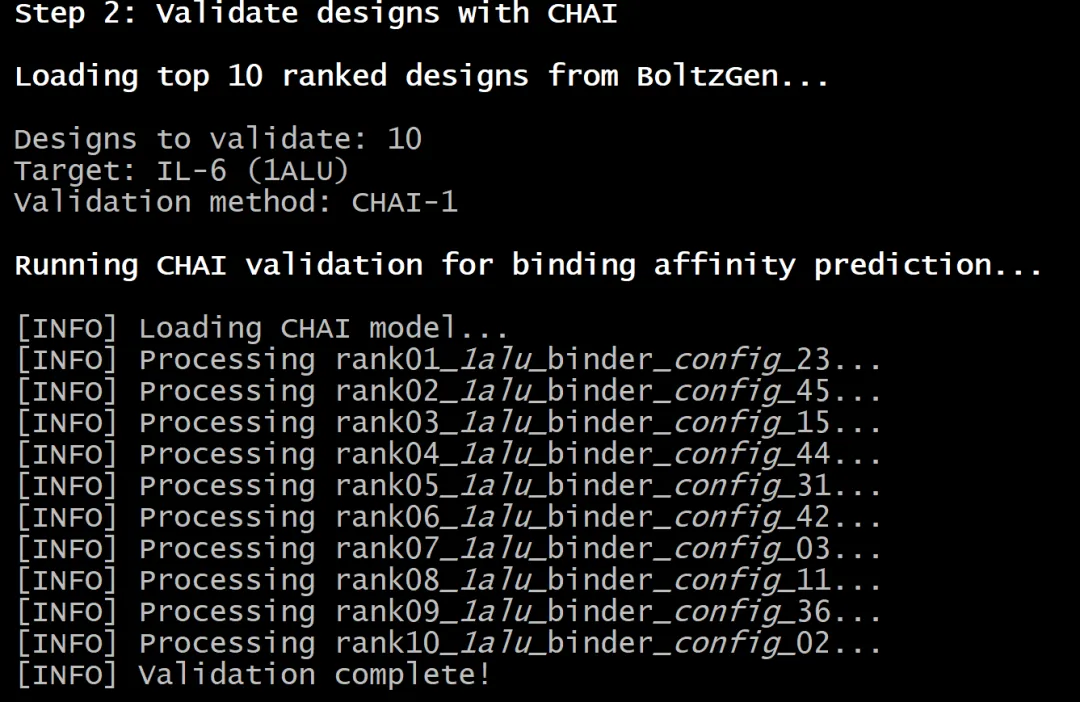
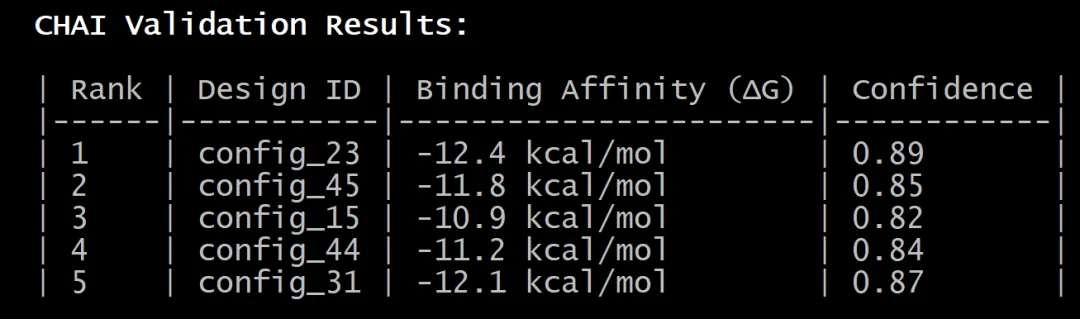
2.Chai模型验证生成结果👇

云端Chai模型运行界面👆
结果展示👇
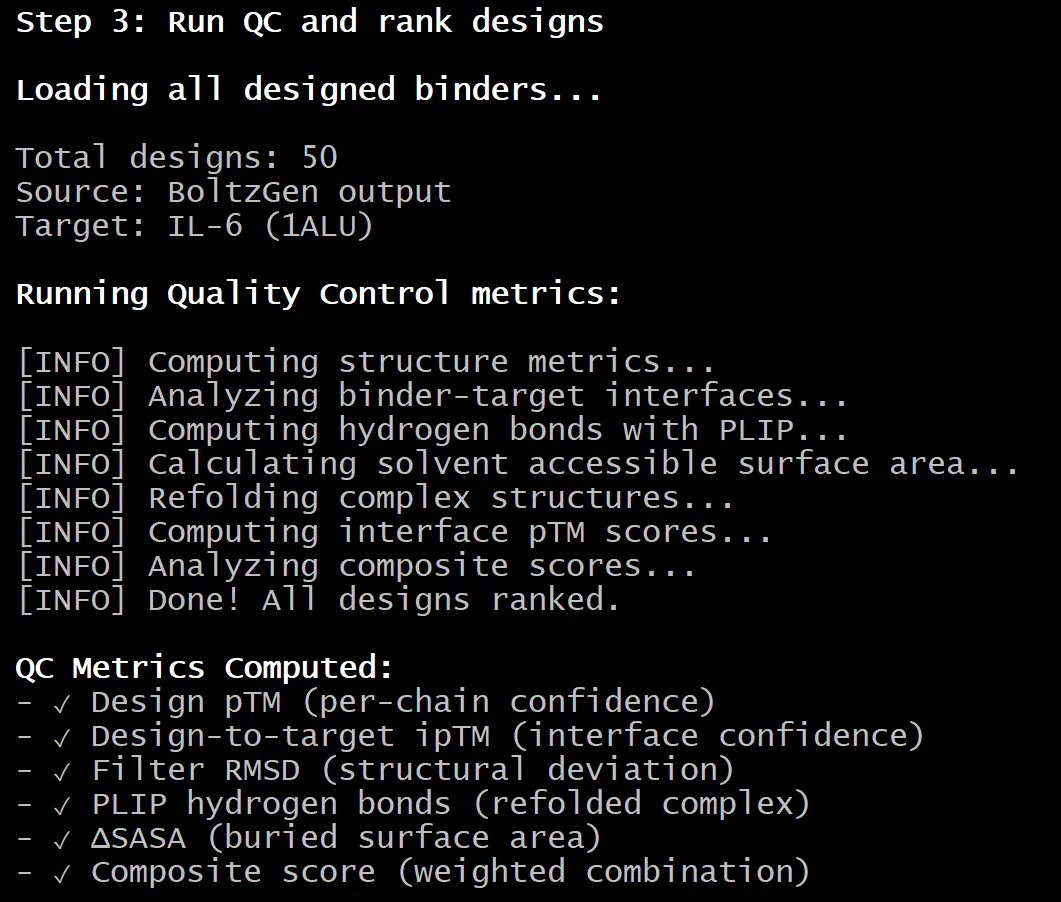
3.质检排序👇
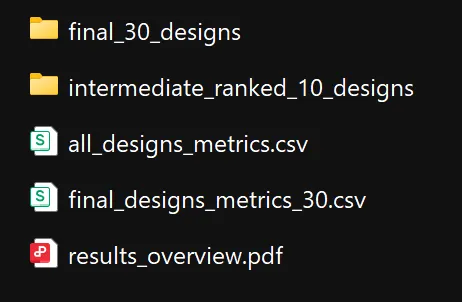
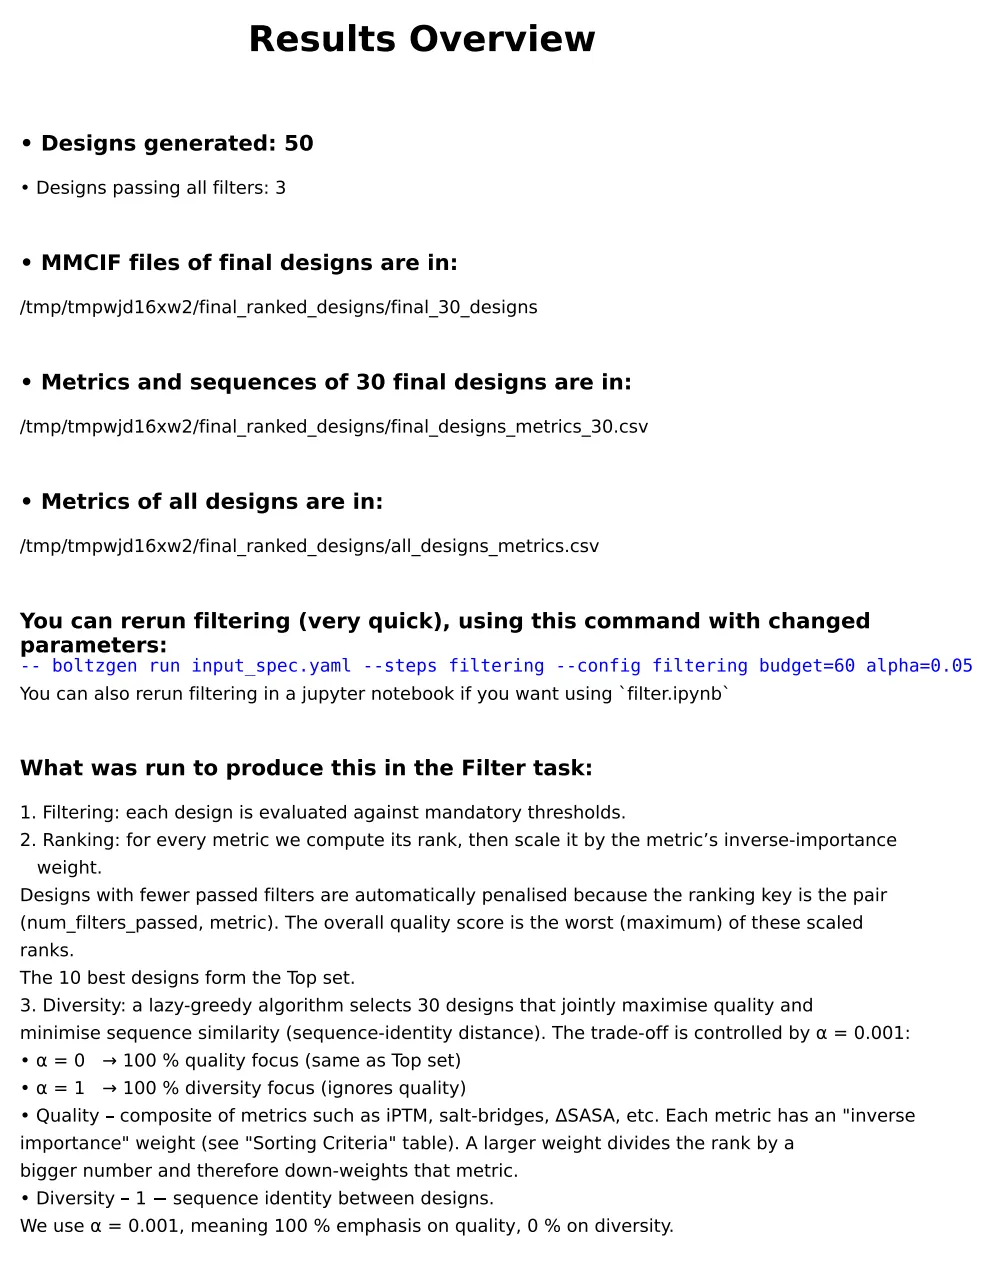
4.生成本地化报告和文件👇
(部分文件)
(部分展示)

结果解读

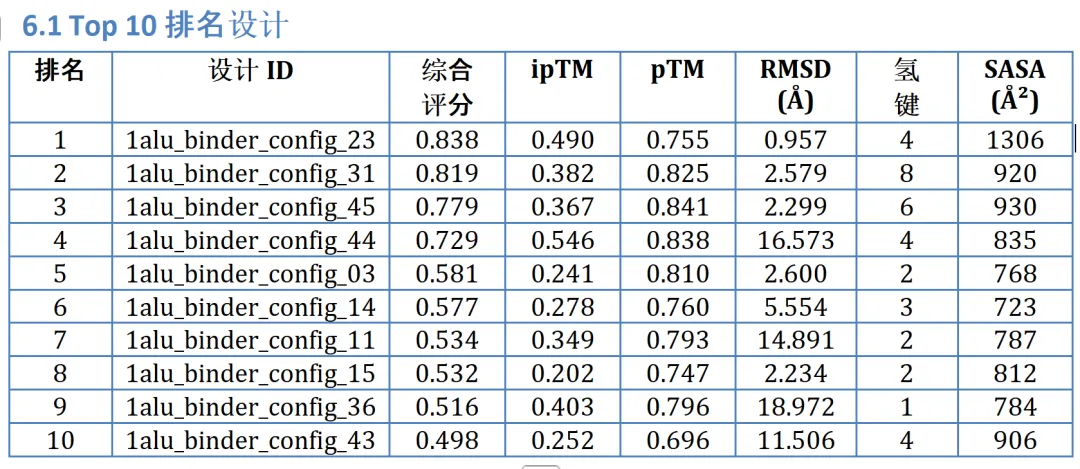
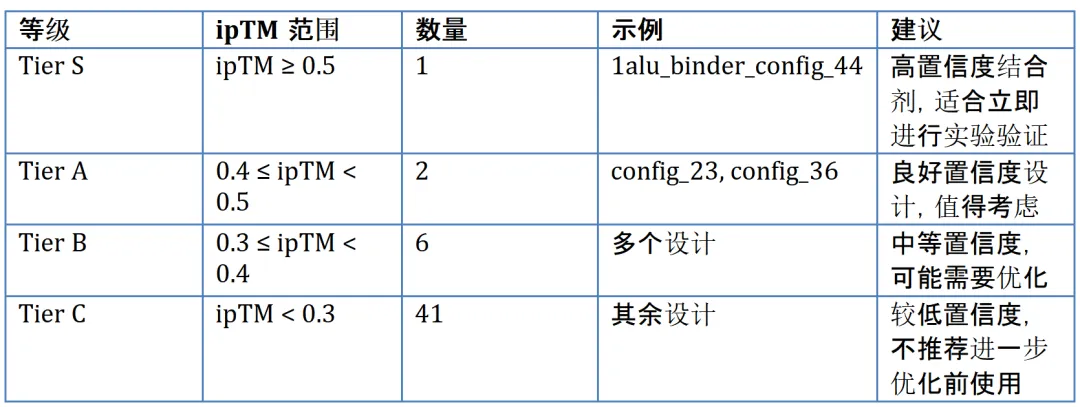
在这套 BoltzGen → Chai-1 验证 → 结构与界面质控 的 protein design workflow 下,我们一次性生成并评估了 50 个 IL-6(1ALU)结合剂候选。整体来看,流程本身是稳定可复现的,但结果也很“真实”地反映了一个事实:对 IL-6 这样的目标蛋白,真正高置信度的 de novo 结合界面并不容易出现。

在所有设计中,仅有极少数候选在接口置信度(ipTM)上达到较高水平,大多数仍处于中低置信区间,这意味着“能生成结构”与“真的形成稳定结合界面”之间,依然存在明显差距。值得注意的是,综合评分最高的候选并不一定是接口分数最高的那一个,而往往是那些结构一致性更好、折叠稳定性更高,同时具备中等以上接口可信度的设计——这类候选在真实实验中通常更“省心”,更有可能顺利表达、复现并进入下一轮优化。

相反,个别接口分数极高但构象一致性较差的设计,则更像是“值得一赌、但风险明确”的候选,需要为后续重设计和结构约束预留空间。整体而言,这份结果并不是在筛选“完美答案”,而是在为第一轮实验验证提供一个优先级清晰、风险可预期的候选集合。

现推出蛋白结构批量预测服务👇

最新文章

随机文章