当前位置:首页>java>Science|谁在用AI写代码?生成式AI的全球扩散与影响

Science|谁在用AI写代码?生成式AI的全球扩散与影响

  • 2026-09-13 11:28:52
Science|谁在用AI写代码?生成式AI的全球扩散与影响

Who is using AI to code? Global diffusion and impact of generative AI

成果简介

近期,维也纳复杂科学中心Simone Daniotti研究员联合乌得勒支大学、布达佩斯考文纽斯大学和林茨跨学科转型大学的研究团队在《Science》期刊发表重要研究成果,首次通过机器学习方法大规模量化了生成式AI在软件开发领域的实际采用率和生产力影响。

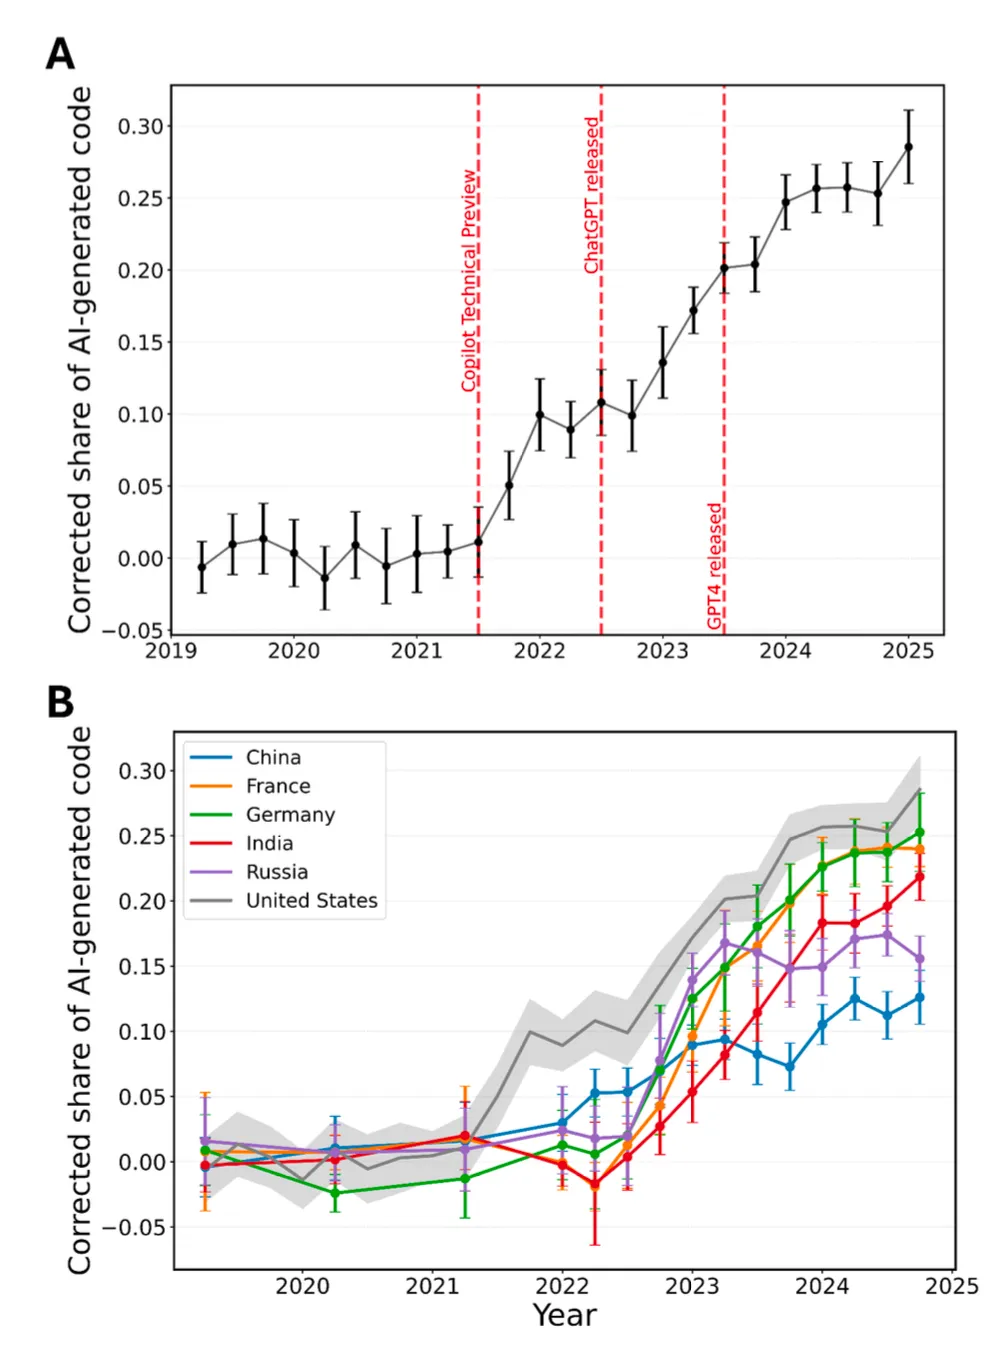
研究团队训练了一个神经网络分类器,用于识别GitHub上超过3100万次代码提交中的AI生成内容,覆盖160,097名软件开发者。结果显示,到2024年底,美国约29%的Python函数由AI生成,德国和法国紧随其后(23-24%),印度快速追赶(20%),而中国和俄罗斯仍处于较低水平。

更引人注目的是,研究发现AI采用带来的生产力提升高度不均衡:资深开发者的季度代码产出增加约6.2%,并更容易探索新的技术领域;而职业早期的开发者虽然使用AI更频繁,却未能获得显著的生产力收益。这一发现对理解AI时代的技能差距和职业发展路径具有重要启示。

引言

生成式AI被认为将大幅提升生产力、革新工作方式。ChatGPT、Claude等工具已经广泛可及,直接辅助人类思维,并有望成为能够解决各类问题的通用技术。实验和准实验证据确实表明,生成式AI可以提高多种岗位的个体生产力。

然而,宏观层面的影响仍不明朗。对GDP和就业的总体估算往往较为保守,而采用率的显著异质性可能导致经济分化。历史经验表明,蒸汽机、发电机、计算机等通用技术的宏观生产力效应需要很长时间才能显现。

这项研究的重要意义在于:

  • 首次实现AI使用强度的大规模客观测量:不同于依赖自我报告的调查(可能存在低报偏差),研究通过机器学习分类器直接从代码中识别AI生成内容,量化了个体层面的AI使用强度

  • 揭示了AI采用的全球格局与国别差异:覆盖美国、中国、德国、法国、印度、俄罗斯六个软件开发大国,首次实现了跨国AI采用率的直接可比测量

  • 发现了生产力收益的"马太效应":资深开发者从AI中获益更多,而新手开发者未能获得显著收益,这对AI时代的技能培养和职业发展路径具有深远影响

研究方法

数据收集:覆盖六国的大规模代码库

研究团队构建了一个大规模数据集,收集了GitHub上Python开源项目的代码贡献:

  • 美国:100,097名开发者的全部代码提交,递归克隆所有相关项目目录

  • 其他五国:中国、法国、德国、印度、俄罗斯各每年随机抽样2,000名开发者(共60,000名)

  • 时间跨度:2019年初至2024年底

  • 数据规模:超过3100万次代码提交,提取约500万个Python函数

分类器设计:识别AI生成代码的"指纹"

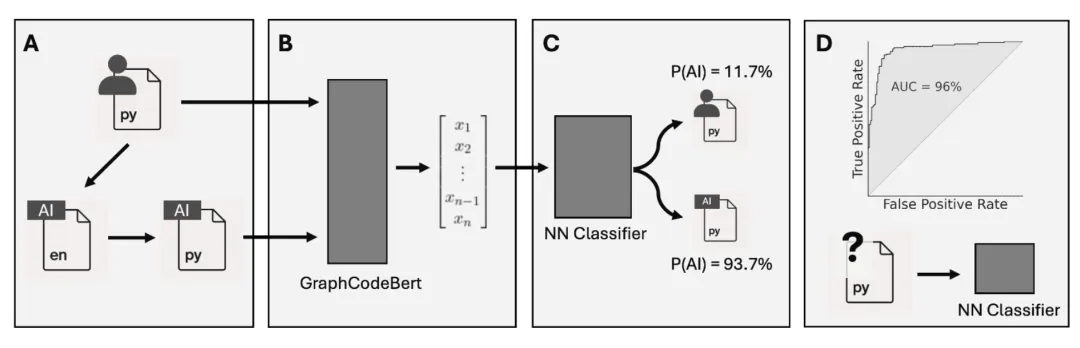
研究的核心挑战是如何可靠地区分人类编写与AI生成的代码。团队采用了一种创新的两步训练数据生成方法:

首先,收集确定由人类编写的代码作为"真值"——2018年的函数(早于强大的生成式AI模型发布),以及后续年份HumanEval数据集中的人类代码。由于编程风格随时间演变,仅用早期代码不足以应对。

然后,为每个人类函数生成对应的AI版本:用一个大语言模型将函数描述为英文说明(包括输入输出类型),再将该说明输入另一个大语言模型生成函数。使用两个不同的模型避免了人类代码与其转录之间产生不必要的强相关,同时确保AI生成的训练数据在功能上与原始人类代码接近。

特征提取与分类

研究采用GraphCodeBert——一个预训练的代码语言模型——将每个函数嵌入高维向量空间。该模型同时利用代码的词元(tokens)、注释和变量数据流图,捕捉代码的语义和结构特征。嵌入向量随后输入神经网络分类器,判断代码是人类还是AI生成。

分类器在样本外测试中表现优异:ROC AUC得分达到0.96,真阳性率平均为0.95。补充测试表明,分类器对数据收集结束后发布的新模型生成的代码、以及真实人机交互中产生的代码同样有效。

图文导读

AI采用率与关键技术发布高度同步

美国开发者的AI采用轨迹呈现出与重大AI发布事件高度同步的阶跃式增长。在GitHub Copilot技术预览版发布(2021年)、ChatGPT公开发布(2022年底)、以及GPT-4等第二代大语言模型发布(2023年)后,AI生成代码的比例都出现了显著跳升。

到2024年底,美国约29%的Python函数由AI生成或在AI大量辅助下完成。这一估计与微软和亚马逊公开报告的内部AI代码采用率高度一致,表明尽管研究聚焦于开源Python代码,结论可能具有更广泛的代表性。

Fig. 1 | 基于Python函数的人类/AI代码分类流程

美国领先但优势正在收窄

六国对比揭示了AI采用的全球格局:美国取得了早期领先地位并一直保持至今,到2024年底AI生成代码比例约为29%;德国和法国紧随其后,约为23-24%;印度在初期滞后后快速追赶,达到约20%;而中国和俄罗斯仍处于较低的采用水平。

中俄两国的较低采用率可能与供给侧因素(OpenAI、Anthropic等服务商的访问限制)和需求侧因素(审查限制本地使用,尽管许多用户通过VPN连接)有关。然而,其他主要国家正在迅速追赶,美国的先发优势正在被侵蚀。

Fig. 2 | AI生成Python函数比例的时间演变

新手用得多,老手获益大

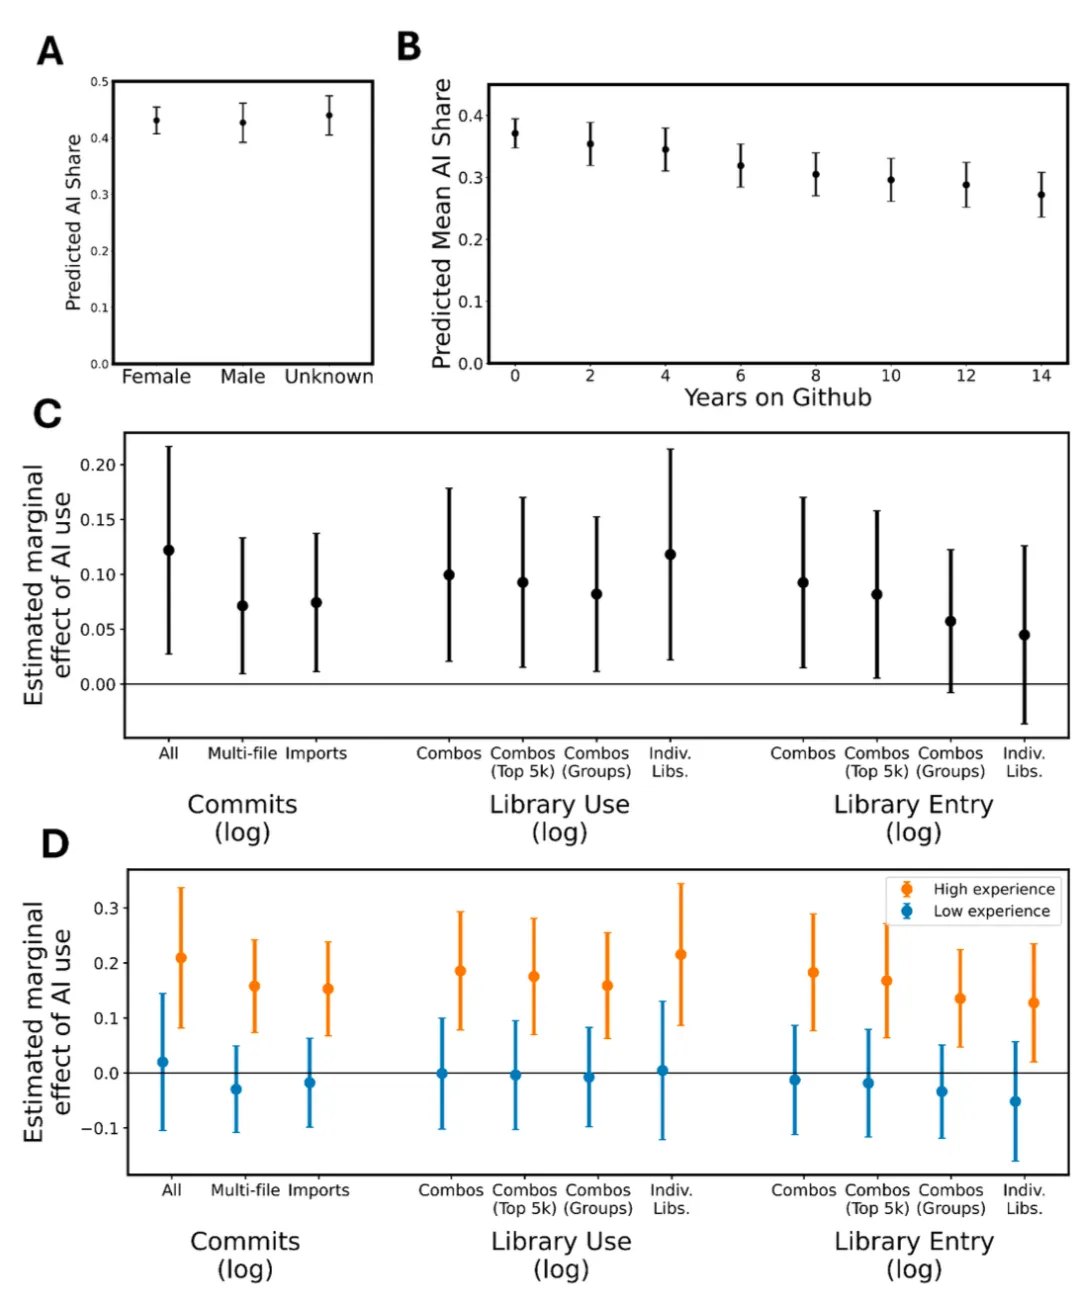
AI采用率与开发者经验呈负相关:刚加入GitHub平台的新开发者约37%的代码由AI生成,而最资深的开发者这一比例仅为27%。然而,基于名字推断性别的分析未发现男女开发者之间的显著差异。

研究采用用户和季度双向固定效应的回归模型评估AI对生产力的影响——比较同一开发者在不同时间点、控制全经济趋势后的产出变化。结果显示,从0%到29%的AI使用率(2024年底美国平均水平)与季度代码提交量增加3.6%相关,这一效应在所有提交、多文件提交(涉及跨脚本依赖)和引入新库的提交中均保持一致。

然而,这些生产力收益几乎完全由资深开发者驱动:对于他们,29%的AI采用率意味着6.2%的产出增加;而职业早期的开发者则未观察到统计显著的效应。

Fig. 3 | AI采用与效应的异质性分布

AI助力技术能力拓展

除了提高活动率,AI采用还与更多的技术探索相关。使用AI的开发者更可能在代码中引入新的库和库组合——过去研究将这种行为解释为创新的标志。由于不同的库通常聚焦于特定功能类型(如可视化、自然语言处理、网页交互、数据库操作等),这表明生成式AI帮助开发者将能力拓展到软件开发的新领域。

在2024年底美国平均29%的AI使用率下,模型预测开发者会多实现2.7%的新库组合。这一效应在仅使用5000个最常见库或将库归类为124个粗分类后依然稳健,排除了AI引入冷门"垃圾库"的解释。

同样,这些探索收益也集中于资深开发者,而新手开发者未能获得同等收益。

小结

这项研究通过机器学习分类器大规模量化了生成式AI在软件开发中的采用与影响。主要发现包括:

建立了AI采用的全球基准:到2024年底,美国约29%的Python函数由AI生成,德法紧随(23-24%),印度快速追赶(20%),中俄仍滞后。AI采用率的跳升与Copilot、ChatGPT、GPT-4等关键发布高度同步。

量化了AI的生产力效应:29%的AI采用率与3.6%的季度代码产出增加相关。基于任务调查和工资统计,研究估算美国每年编程相关劳动成本为6370-10630亿美元,AI编程助手创造的年度价值约为230-380亿美元(保守估计),若采用实验研究的更高效应值则可达380-1670亿美元。

揭示了收益分配的"马太效应":资深开发者从AI中获益显著(6.2%产出增加、更多技术探索),而职业早期开发者虽然使用AI更频繁却未获得显著收益。这可能反映了资深开发者更快地解读和发现AI生成代码中的错误的能力,对未来职业发展路径和技能培养具有重要启示。

与AI的潜在结合点

AI生成代码检测的持续演进

该研究构建的分类器依赖GraphCodeBert提取代码特征。随着生成式AI模型的快速迭代,检测方法需要持续更新。对抗性训练框架可以模拟"检测器-生成器"的军备竞赛,通过生成对抗网络(GAN)让检测器学习识别最难区分的AI代码。元学习方法可以使检测器快速适应新模型:在多个已知模型上预训练后,仅需少量新模型样本即可微调。此外,代码风格的时间漂移是一个挑战——人类编程风格本身也在受AI影响而演变。持续学习(Continual Learning)技术可以在不忘记旧知识的前提下适应新的分布,避免灾难性遗忘。多模态特征融合——结合代码文本、抽象语法树、数据流图、甚至开发者的提交历史——可以提供更鲁棒的检测信号。

开发者生产力的因果推断与个性化干预

该研究使用双向固定效应模型估计AI的生产力效应,但面临测量误差导致的向下偏差。工具变量方法可以利用AI工具的外生可得性变化(如Copilot的分阶段推出)作为工具,获得更一致的因果估计。异质性处理效应(HTE)模型——如因果森林、BART、或基于深度学习的CATE估计器——可以识别哪些开发者特征预测了更大的AI收益,为个性化培训和工具推荐提供依据。强化学习可以优化AI编程助手的介入时机和方式:学习何时主动建议代码、何时等待提问、对哪类任务提供何种粒度的帮助,以最大化开发者的长期学习和生产力。

跨国AI采用差异的预测与政策模拟

该研究发现了显著的跨国AI采用差异,但未深入探讨其决定因素。结构方程模型或因果图模型可以分解供给侧因素(API可得性、定价、语言支持)和需求侧因素(数字基础设施、技能储备、制度环境)的相对贡献。技术扩散模型——如Bass模型或传染病模型——可以刻画AI采用的S型曲线,预测不同国家的"拐点"时间。基于Agent的模型(ABM)可以模拟政策干预的效果:如果某国放开AI服务访问限制、或推出AI技能培训补贴,采用率和生产力会如何演变?图神经网络可以建模开发者社交网络中的同伴效应,识别"超级传播者"——那些采用AI后影响周围开发者采用决策的关键节点。

代码质量与长期影响的多维评估

该研究聚焦于代码产出数量(提交次数),但代码质量同样关键。自然语言处理技术可以分析提交信息、代码评审评论、Issue讨论,评估代码的可维护性、可读性和bug倾向。静态分析工具结合机器学习可以预测代码的缺陷密度、技术债务和安全漏洞风险。时间序列分析可以追踪AI采用后项目的长期健康指标:Issue解决速度、PR合并率、贡献者留存率、代码流失率等。知识图谱可以建模开发者的技能演化轨迹,评估AI是否真正帮助新手"升级"还是让他们"跳过"了关键学习阶段,这对理解AI时代的人才培养至关重要。
DOI:10.1126/science.adz9311

本文版权归原作者所有,本文旨在分享优秀科研成果,文章推送时未能及时与原作者取得联系,若来源标注错误或侵犯到您的权益烦请告知,我们将立即删除。更多详情和引用,请参考原文,点击文章底部(阅读原文)。

微信号丨AI4EarthScience

商务联系丨AI4EarthScience

最新文章

随机文章