发表于1991.12,《新浪潮》,1991年第6期。一、前言
在人事信息系统中,利用代码取代文字操作,既可以提高系统的使用效率,又减少了存储空间,已成为计算机化的人事管理系统发展的必然趋势。当然,使用代码也有不尽人意之处。笔者近几年在研制《青海省科技人员信息管理系统》的过程中,对使用代码的优、缺点以及代码编制中应考虑的问题,着意进行了分析和探讨,下面就此谈谈自己的看法。
二、使用代码的优点
1、减少存储空间:一般情况下代码化的人事管理信息系统存储空间只有文字系统的20%-40%左右。
2、提高统计、检索速度:我们现已在有十万条记录的科技人员数据库中实现检索一秒钟,统计一张横栏×纵栏=11×8600的表格只需十二分钟(AST 386、Foxbase2.1)。
3、加快编辑速度,减少错误数据。
4、可以实现任意条件的数据处理,这是文字系统所无法做到的。
三、使用代码的缺点及解决方法
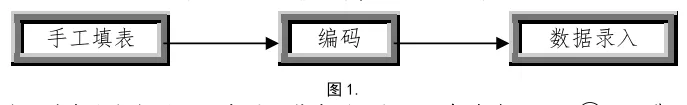
在现今全国绝大多数人事管理信息系统中,其输入操作过程如图1示。
在这手工填表和数据录入一般是不能免的,但编码却存在问题:
①编码费工费时。就以我省建人才库为例,当时动员了全省各州、地、市,各厅局近千人,对十万科技人员表格进行突击编码,配代码手册一套(四本),这种做法增加了基层的工作负担,也加大了财政支出。
②编码难免出错。由于编码人员的临时性,以及代码的不标准化,在编码过程中错误时有发生,虽然我省制定了检查制度,但这一问题并未能从根本上得到解决。
③由于录入人员对代码一般没有深入的理解,因此在录入过程中也会出错,虽然可以在程序中检查所输数据的合理性,但却降低了系统的响应速度。由此,我们可以得出这样的结论:编码已到了非改不可的地步。
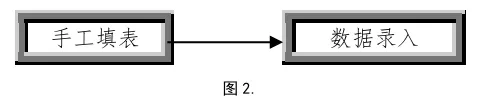
省去编码的输入操作过程如图2示,实现的方法有两种。
1、直接录入文字,存储代码:随着“五笔字型”等专业性汉字输入方法的推出,汉字输入已不再是汉字处理的难点,因此该方法就是由录入员直接录入手工填写的各种内容,程序自动识别其代码,然后存储代码,以避免编码。但程序设计中较难实现所录文字的准确自动代码识别,加之对录入员操作水平要求较高,不易推广。
2、分级提示代码,存储代码:这是我们已实现的,本文重点介绍的方法。下面以录入籍贯为列,说明其原理。
进入籍贯项录入后,程序首先显示两位省、自治区、直辖市代码。
11-北京市
12-天津市
...
...
65-新疆
71-台湾
录入员根据表中所填内容,选择省码(例11-北京),程序则接着显示该省、自治区、直辖市的两位地区代码。
01-北京市区
02-北京市县
选择地区项后,程序最后显示两位该地区所有的县代码(例01-北京市区)。
01-北京市东城区
02-北京市西城区
...
...
09-北京市门头沟区
10-北京市燕山区
接着选择县码,这样,经过三步就将籍贯代码输入完毕。既不用编码,又减轻了录入员的工作强度,并且程序也容易实现。
在我们这个系统中,除学校、籍贯外,绝大部分代码只需一至两步就可以完成录入,在AT及以上档次机器上用Foxbase均可得到满意的响应速度。
3、代码高频先见技术。利用代码分级提示法录入时,由于屏幕显示范围限制,不可能在一屏上将所有代码全部输出,有可能出现常用代码在第二及以后屏的情况,势必增加翻屏次数,降低录入效率。
在着手解决这一问题时,汉字输入中的高频字先见技术给了我们很大的启示,由此在代码分级提示法中发展出“代码高频先见技术”。实现这一技术的关键有两个:一是在代码显示时,根据代码的权重值按从大到小的次序排序输出;二是在代码被选择后,将其权重值累进加一,以决定该代码下次显示的位置。因此,在原有代码库中还需增加一权重值字段,初始状态将所有代码的权重值均赋值为1,然后各代码根据被选次数,自动变换输出位置,以实现高频代码先见。
四、代码的编制
目前,国内人事管理信息系统中主要使用的代码标准有《人事信息代码汇编》(国家标准局信息分类编码研究所)、《全国成人高等院校、中等专业学校代码》(国家标准局信息分类编码研究所)、《科技人员信息管理系统补充代码》(国家科委人才资源研究所)等,各省市也有一些暂行代码。不过由于代码定义标准不一致,在实际应用中还存在不少问题,突出的有:
1、代码不适应于计算机使用:人事系统的代码主要是用于计算机处理,因此在代码编制时要充分考虑计算机的特点,使代码易于处理、便于理解。
2、减少冗余,精练代码:如原学校代码中,用两位码表示学校的类别。
31-大学
32-中专
35-成人高校
37-军队院校
39-曾设或国外院校
而实际上用一位码就可以表达情楚。缩短一位码对一个大系统来说(如有十万条记录),将会减少可观的存储空间(100KB),提高速度。
3、代码应是区段码,而不能是区间码:如原行业码中以0开头,即有农业又有工业,代码之间没有明确的分界线,数据统计就不容易实现快速分类。
010-农业
...
...
070-农、林、牧、渔、水利服务业
080-工业
...
...
4、代码编制时应考虑空填值的定义:在人事信息系统中,我们规定当学历低于中专时,其毕业学校空填。但在统计、检索时,空填项则不好处理。因此在代码编制时应考虑这种情况,对应空填项用特殊码代替,以实现系统的统一处理。
5、在程序设计中应建立代码与数据库的匹配关系:代码编好以后,并非一成不变,如籍贯(行政区划)每年国家均有变化。为了避免代码更新后,数据库不匹配性,应在修改代码的同时,修改数据库中对应原码的数据为新码,这样就保持了代码和数据的一致性。
随着人事管理信息系统在各单位、各系统的使用,代码的标准化问题已成为制约人事管理信息系统发展的一大障碍。为了推动全国人事管理信息系统的建设和应用软件的交流,国家应尽快制订人事系统的各种代码标准。
下面所附是实现代码分级提示及高频先见的程序:
use zdmk5 index zdmk51
seek dm1*dm1是籍贯在代码库中的标识码
copy to d:1 while left(code,1)=dm1*得省码
dm2=1
store '' to a1,a2,a3
do while dm2<=3
do case
case dm2=2
use zdmk5 index zdmk52
seek dm1+a1
copy to d:1 while left(code,3)=dm1+a1*得地区码
case dm2=3
use zdmk5 index zdmk53
seek dm1+a1+a2
copy to d:1 while left(code,5)=dm1+a1+a2*得县码
endcase
use d:1
sort on num/d,code to d:11
use d:11*按权重值从大到下排序
do while .not.eof()
set color to 6+/1
@ 3,44 clear to 23,78
dm3=0
do while dm3<20.AND.(.not.eof())
dm4=iif(dm2=1,subs(code,2,2),iif(dm2=2,subs(code,4,2),subs(code,6,2)))
@ 3+dm3,44 say dm4 *显示代码
@ 3+dm3,47 say ltrim(trim(name))
dm3=dm3+1
skip
enddo
do while .t.
@ 23,44 say '↑-上页↓-下页回车-选中'
dm5=inkey(0)
if eof()
if dm5=5.or.dm5=13
exit
endif
else
if dm5=5.or.dm5=13.or.dm5=24
exit
endif
endif
enddo
do case
case dm5=5*向上翻屏
skip -(20+dm3)
loop
case dm5=24*向下翻屏
loop
case dm5=13*输入代码
dm6=str(dm2,1)
@ 1,11*(dm2-1) say '第'+dm6+'项' get a&dm6
read
exit
endcase
enddo
dm2=dm2+1
enddo
use zdmk5 index zdmk5
seek dm1+trim(a1)
repl num with num+1*省码权重值加一
if len(trim(a2))<>0
seek dm1+trim(a1)+trim(a2)
repl num with num+1*地区码权重值加一
if len(trim(a3))<>0
seek dm1+trim(a1)+trim(a2)+trim(a3)
repl num with num+1*县码权重值加一
endif
endif
use
代码库ZDMK5的结构包括三个字段:CODE(代码值)、NAME(代码名)、NUM(代码权重值);ZDMK5有四个索引库:ZDMK5(全部内容索引)、ZDMK51(省码索引)、ZDMK52(地区码索引)、ZDMK53(县码索引);A1、A2、A3三个变量分别存放所录的省码、地区码、县码值。