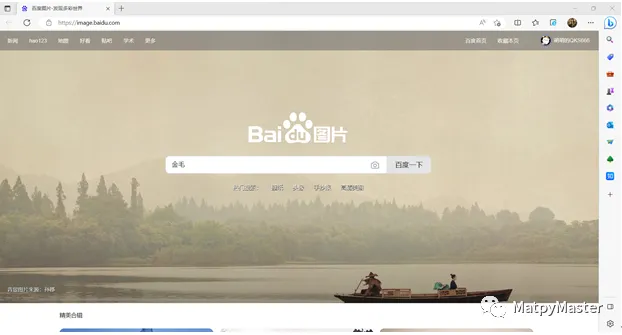
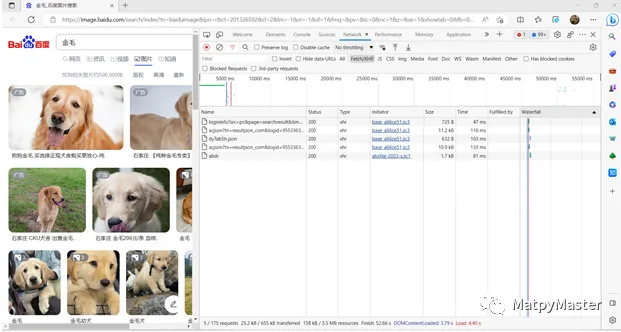
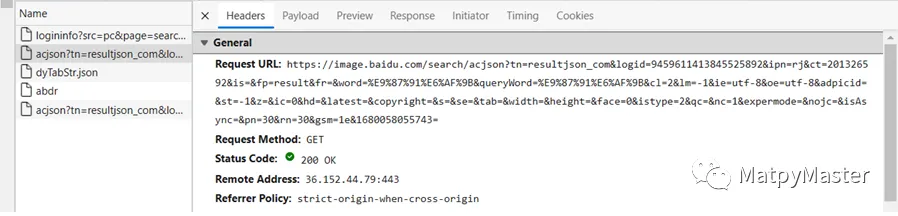
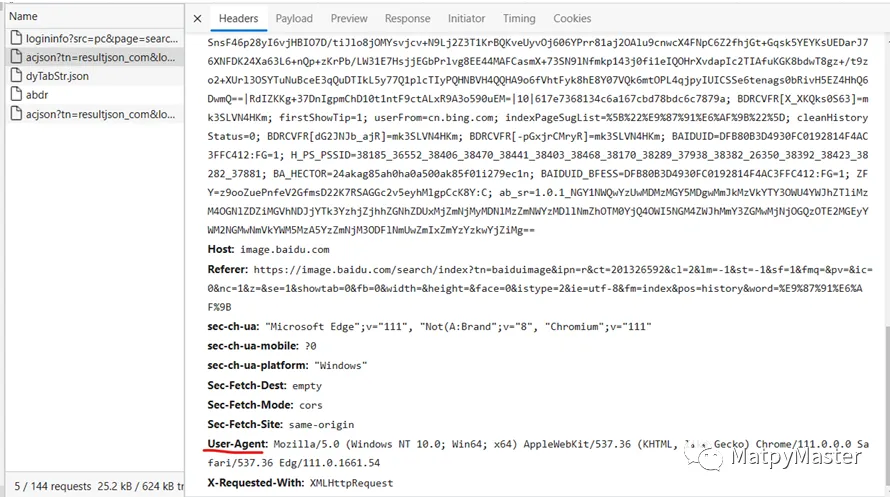
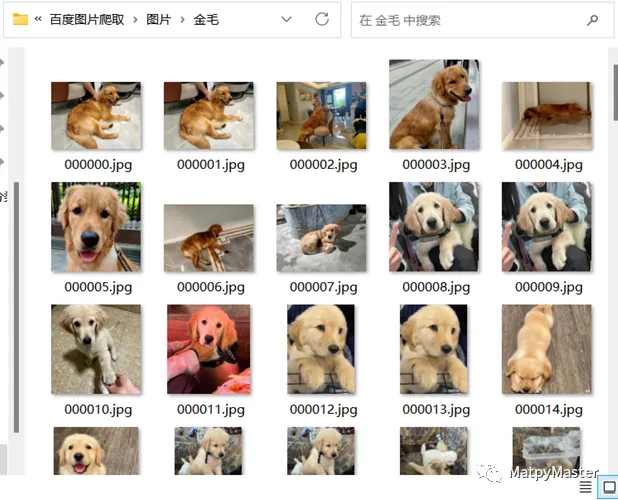
# -*- coding: utf-8 -*-"""Created on Wed Mar 29 10:17:50 2023@author: MatpyMaster"""import requestsimport osimport redefget_images_from_baidu(keyword, page_num, save_dir): header = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.108 Safari/537.36'}# 请求的 url url = 'https://image.baidu.com/search/acjson?' n = 0for pn inrange(0, 30 * page_num, 30):# 请求参数 param = {'tn': 'resultjson_com','logid': '7603311155072595725','ipn': 'rj','ct': 201326592,'is': '','fp': 'result','queryWord': keyword,'cl': 2,'lm': -1,'ie': 'utf-8','oe': 'utf-8','adpicid': '','st': -1,'z': '','ic': '','hd': '','latest': '','copyright': '','word': keyword,'s': '','se': '','tab': '','width': '','height': '','face': 0,'istype': 2,'qc': '','nc': '1','fr': '','expermode': '','force': '','cg': '', # 这个参数没公开,但是不可少'pn': pn, # 显示:30-60-90'rn': '30', # 每页显示 30 条'gsm': '1e','1618827096642': '' } request = requests.get(url=url, headers=header, params=param)if request.status_code == 200:print('Request success.') request.encoding = 'utf-8'# 正则方式提取图片链接 html = request.text image_url_list = re.findall('"thumbURL":"(.*?)",', html, re.S)ifnot os.path.exists(save_dir): os.makedirs(save_dir)for image_url in image_url_list: image_data = requests.get(url=image_url, headers=header).contentwithopen(os.path.join(save_dir, f'{n:06d}.jpg'), 'wb') as fp: fp.write(image_data) n = n + 1if __name__ == "__main__": keyword = '金毛' page_num = 1 page_num = int(page_num) save_dir = '.\\图片\\'+keyword get_images_from_baidu(keyword, page_num, save_dir)
 10个月宝宝每天需要喝多少奶粉?