聊聊我们用了十几年没换过的 Linux C++ 多线程异步编程框架
- 2026-09-19 00:29:06
说出来可能有点意外,我们正在使用的 Linux C++ 多线程异步编程框架,
其实在十几年前就定下来了。
没有协程,没有 io_uring,没有任何「现代异步」的东西。
但它就这么一直跑着,稳定,框架层面没出过什么事。
我最近重新梳理了一遍这套东西,觉得值得写出来聊聊。
本质上来讲就是:
I/O 密集型(网络 I/O、磁盘 I/O)的线程(等待的时间比较多),
跟 CPU 密集型的线程(干事的时间比较多),
要分开。
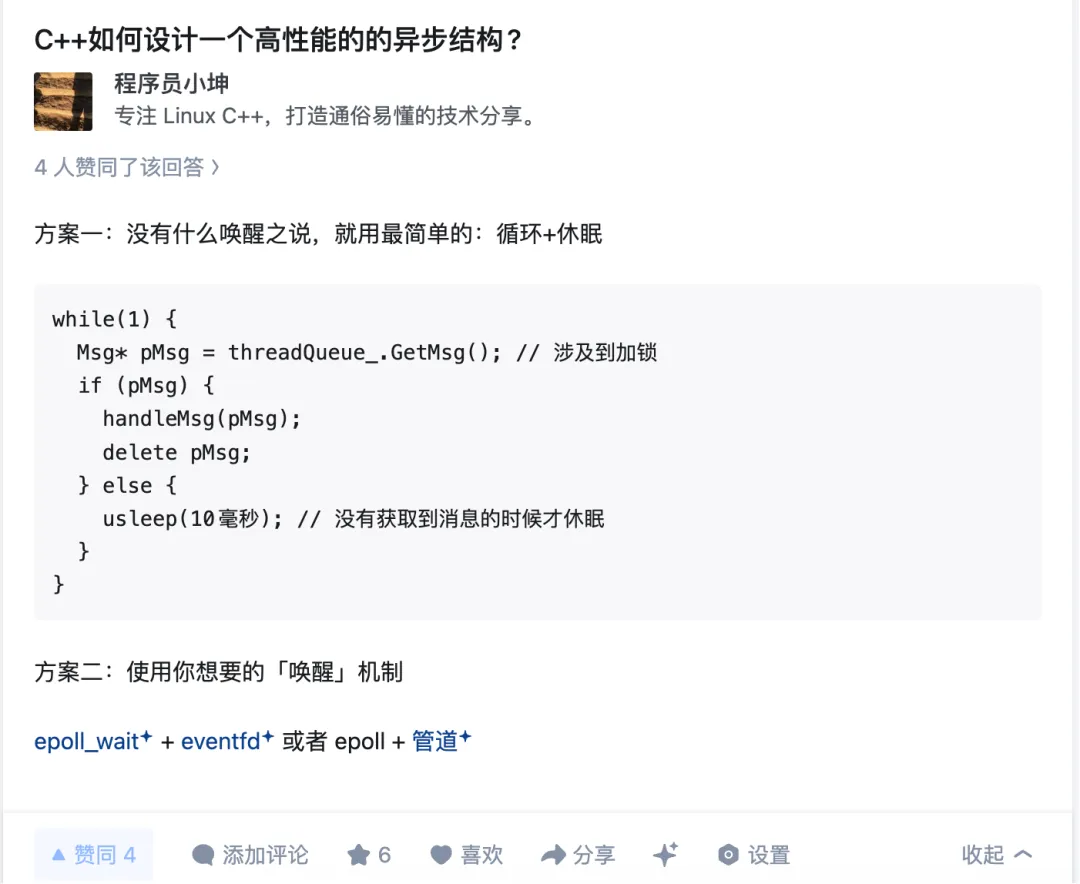
最早的方案:while(1) + sleep
最早我们工作线程是这么写的:
while (1) { Msg* pMsg = threadQueue_.GetMsg();if (pMsg) { handleMsg(pMsg);delete pMsg; } else { usleep(7000); // 休眠 7 毫秒 }}看起来没什么问题,但其实这里面有个比较矛盾的地方:
sleep 时间太短,会导致 CPU 一直空转,CPU使用率飙高。
sleep 时间太长,消息来了,线程还在休眠中,响应就慢。
这两件事你没办法同时满足。
7 毫秒是当时调出来的一个凑合值,不是最优解,就是「CPU 不太高,延迟也不太离谱」的一个折中。
网络线程是不敢用 sleep 的,请求来了你还在睡那还搞啥,所以网络线程从一开始就用了 epoll。
但问题是:网络线程收到请求之后,要把消息扔给工作线程处理。
工作线程还是在 sleep,最坏情况就是等一整个 sleep 周期才能响应,
这个响应延迟还是存在问题。
后来改成了 epoll + pipe 唤醒
sleep 的问题其实很明显:没有消息的时候,你不知道要等多久,所以只能傻等、固定等一个时间。
那如果有人能在消息来的时候主动叫醒你呢?
这就是 epoll + pipe 的思路。
每个工作线程底层挂一个 epoll 实例,平时阻塞在 epoll_wait 上,什么都不干,也不占 CPU。
其他线程往这个线程的队列里放消息的时候,同时往它的管道里写一个字节。
epoll 感知到管道可读,线程被唤醒,去队列里取消息,处理,完事。
某个业务线程,作为生产者:
第一步,new 一个消息,放进目标线程的队列(要加锁)
第二步,往目标线程的 pipe 管道写 1 字节
目标线程,作为消费者:
epoll_wait 返回 → 读 pipe(清掉信号) → 取消息 → 处理
这个方案其实也相当成熟,memcached 的多线程模型用的就是这个思路,
主线程收到连接,通过 pipe 通知工作线程来处理。
我们就按照这个思路改的,去掉了 sleep 之后,响应延迟明显下来了,工作线程也不再空转了。
这套我们一直用到现在。
现在这套还能继续优化吗?
能,但说实话没太大动力,现在挺好的。
如果真要继续做,方向大概有这么几个:
换掉 pipe,用 eventfd
pipe 要两个 fd,一个读一个写。
Linux 内核提供了一个叫 eventfd 的东西,
专门用来做这种「通知唤醒」,一个 fd 就够了,更轻量。
int efd = eventfd(0, EFD_NONBLOCK | EFD_CLOEXEC);// 唤醒uint64_t val = 1;write(efd, &val, sizeof(val));// 消费uint64_t val;read(efd, &val, sizeof(val));再把消息队列换成无锁队列
我们现在用的是一个加了锁的std::queue,放消息的时候加锁,放完释放。
整个框架里就这一个地方有锁,粒度已经很小了。
如果并发压力极高,可以换成无锁队列,把这最后一点竞争也去掉。
再加上会话池,避免热点路径频繁申请释放内存
现在会话是按需创建销毁的,请求量大的时候,
热点路径上,内存持续分配回收,会有不少开销。
提前建个对象池复用,能减少这块压力。
这些都是可选的,不是非做不可。
整个进程的线程是怎么分工的
一个进程里,大概是这样划分的:
网络线程负责监听端口、收发数据,
业务线程做 CPU 密集型的计算,
Redis 线程池专门执行 Redis 命令,MySQL 线程池专门跑 SQL,这些采用的都是阻塞式的接口。
都是 epoll + pipe 这套。
业务线程不直接操作 Redis,而是把请求封装成消息,扔给 Redis 专属线程,它执行完再把结果传回来。
操作 MySQL 也一样。
所有的等待都被关在了专属线程里,业务线程只管处理,不管等。
我觉得这是这套异步框架,能稳定跑这么多年的真正原因。
小结
回头看这套东西的演进,其实不复杂。
但对于还未打通任督二脉的初学者来说,可能还是有点吃力。
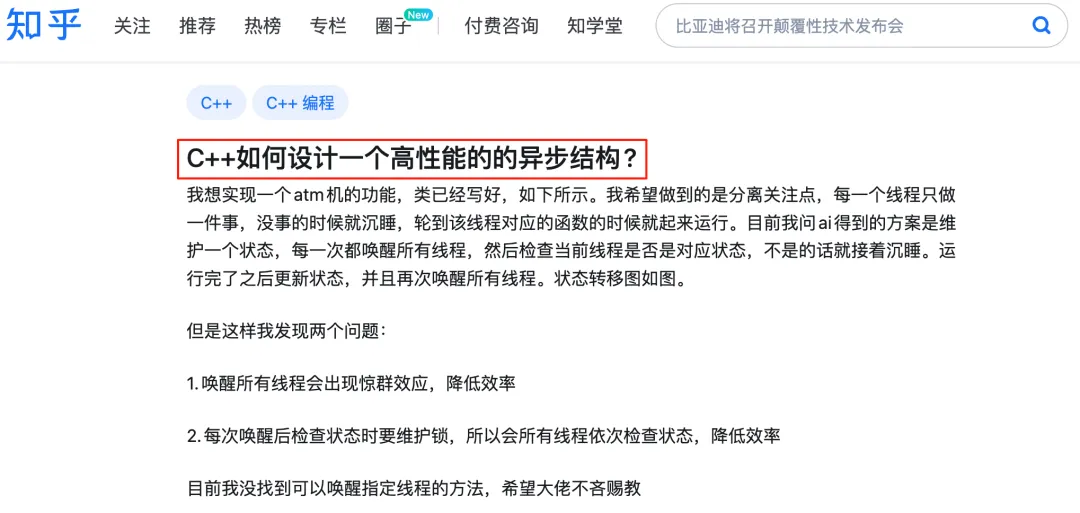
前一段时间在知乎,就看到这么一个问题「C++ 如何设计高性能异步结构」。
我当时给的回答,就是上面那些的简化版。
有人可能觉得,会不会太简单了。
简单一点不好么。
我们真实环境就是这么跑的。
希望对你有参考。
往期推荐:
