python大模型(千问)使用之图片生成
- 2026-09-10 05:33:03
这几天抽空在看阿里的千问的视觉模型,根据官网解释,有视觉理解(基于图片的分析)、图片生成(文字转图片)、视频生成(图片生成视频)三种分类
个人觉的感觉图片和视频生成的挺好玩的(图片生成),于是注册了一个账户(新账户3个月试用期)
图片生成的模型也有好几个:千问图片(qwen-image-2.0)、万象(目前是wan2.6-T2)
今天用python和千问做了一个简单的集成,可以根据输入的内容(提示词)生成一张图片,话不多说,直接上代码吧
#python和千问的继承工具是dashscope,可以通过pip安装
from http import HTTPStatus
from urllib.parse import urlparse, unquote
from pathlib import PurePosixPath
import requests
from dashscope import ImageSynthesis
import os
import sys
import dashscope
dashscope.base_http_api_url = 'https://dashscope.aliyuncs.com/api/v1'
#api_key,这个就不展示了
api_key = "sk-XXXXXXXXXXXXXXX"
#这是调用的主题方法,根据传入的提示词,调用qwen-image-plus模型
#我这里只打印出来返回值图片的url,并提示用户下载
def getpromptimg(prompt):
print('----同步调用,请等待任务执行----')
rsp = ImageSynthesis.call(api_key=api_key,
model="qwen-image-plus", # 当前仅qwen-image-plus、qwen-image模型支持异步接口
prompt=prompt,
negative_prompt=" ",
n=1,
size='1664*928',
prompt_extend=True,
watermark=False)
rt_str=''
if rsp.status_code == HTTPStatus.OK:
v_ct=1
rt_str='根据您的提示'+prompt+'",我们生成如下地址图片,请自行下载:\n'
for result in rsp.output.results:
rt_str=rt_str+str(v_ct)+':'+result.url+'\n'
v_ct=v_ct+1;
else:
rt_str='同步调用失败,message: '+rsp.message
return rt_str
#描述的简单check,要求长度大于10
def checklen(v_str):
v_len=len(v_str)
if v_len == 0:
print('提示词长度输入错误,请输入至少10个字')
return False
else:
return True
#主调度方法,提供一个交互的窗口
def main(args):
print('--------大模型应用:图片生成工具---------')
print('Usage: \n1、根据提示词生成图片')
print('2、补充中')
print('注:系统仅供娱乐使用,不承担责任')
while True:
print('--------------------------------')
v_use=input("请输入序号(0退出):")
if v_use=='1':
v_str = input("请输入提示词(用于生成图片):")
if checklen(v_str):
print(getpromptimg(v_str))
elif v_use=='0':
print('即将退出...')
break
else:
print('输入错误!请输入菜单序号')
print('\n')
return 0
if __name__ == '__main__':
sys.exit(main(sys.argv[1:]))
ok,大概就这样了,时间有限,还没没怎么润色,奔着先把逻辑跑通的思路哈....
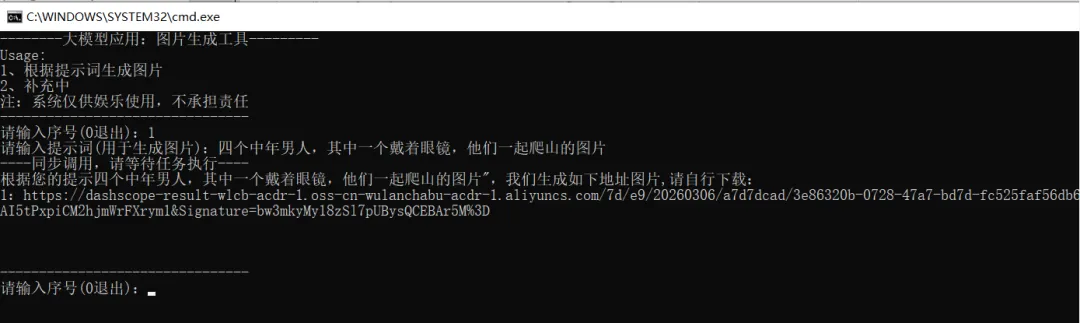
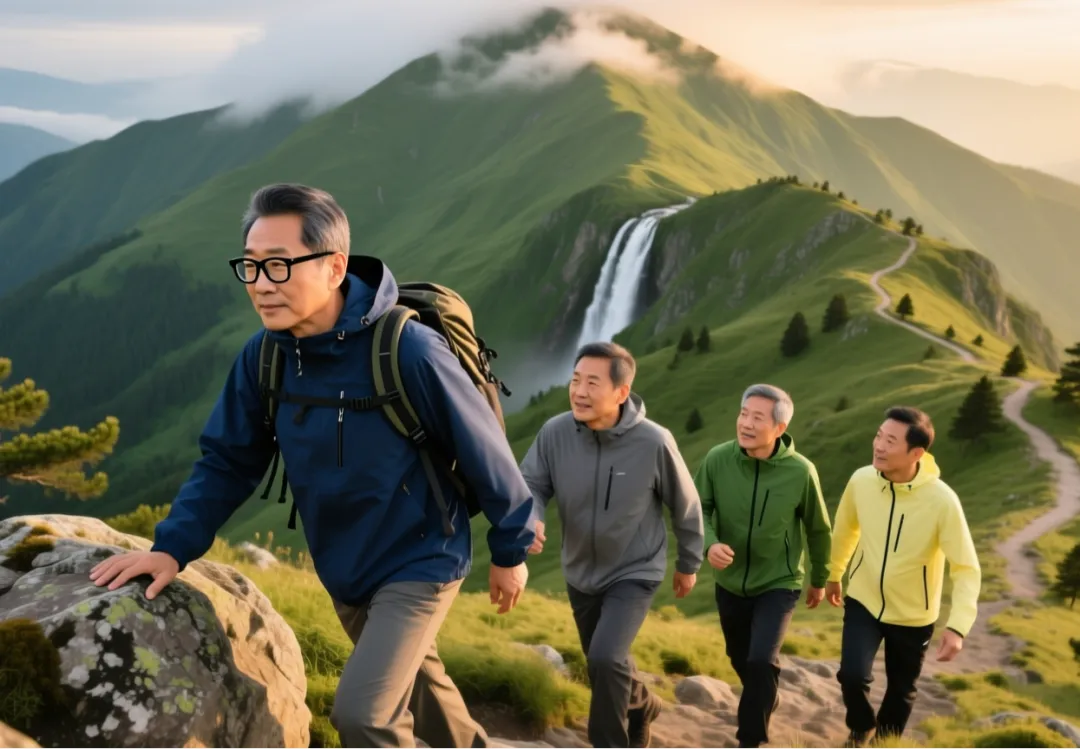
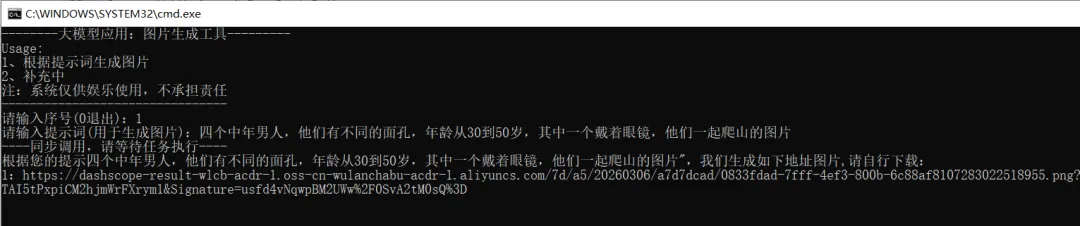
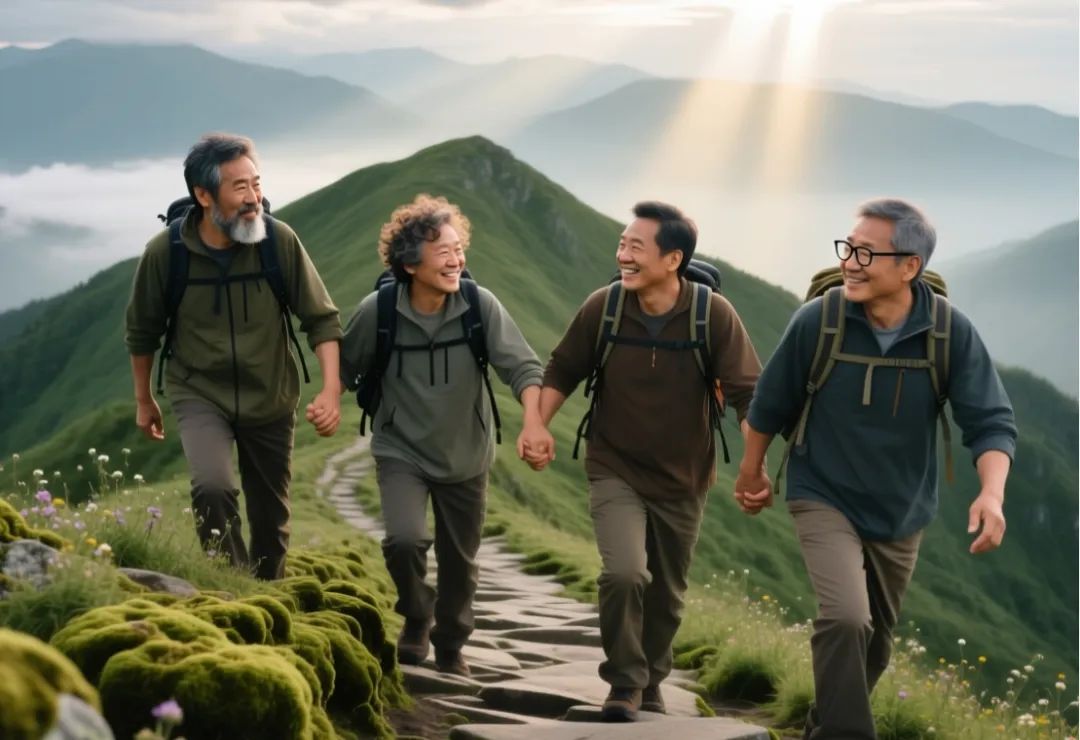
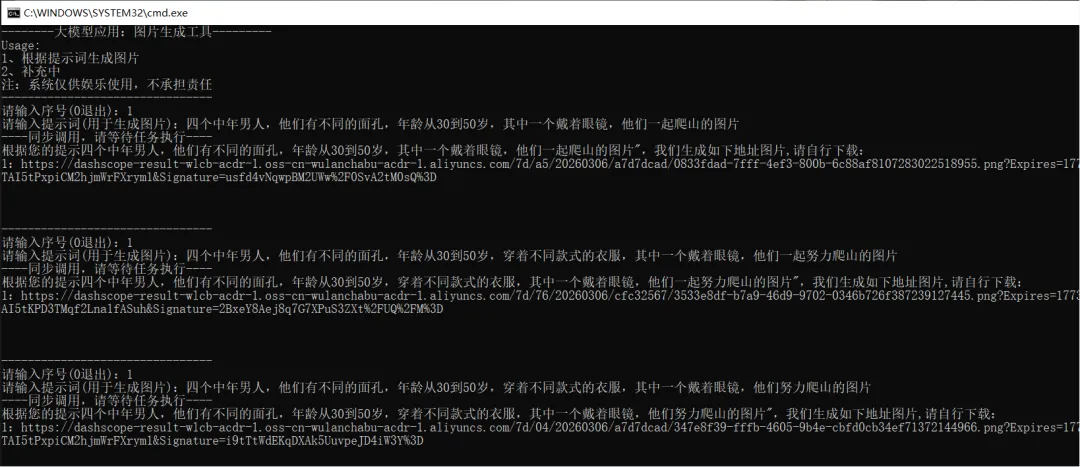
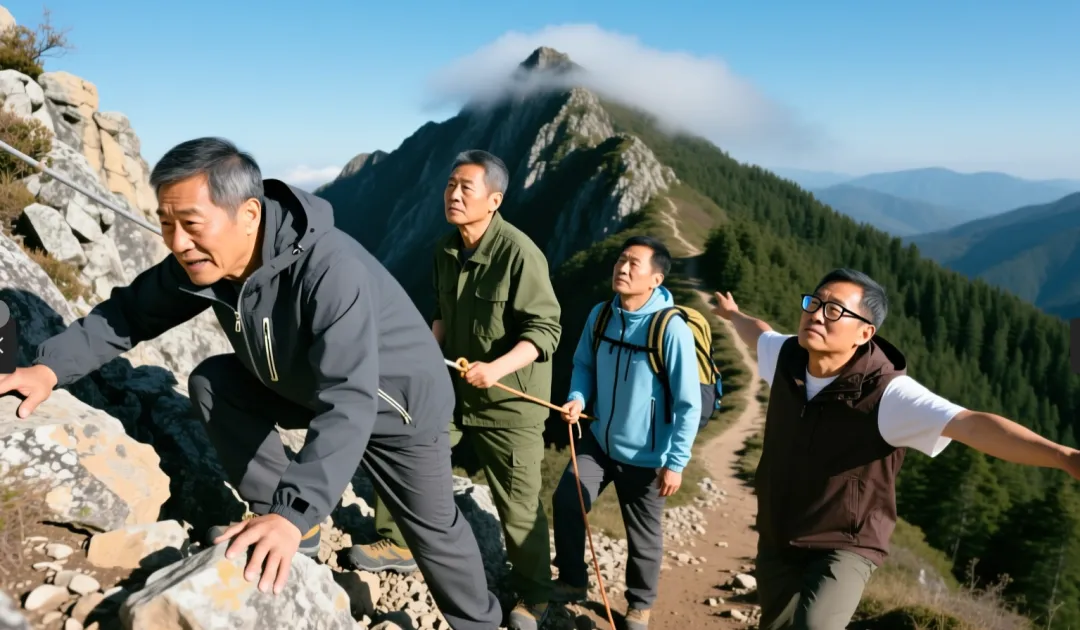
我们运行测试一下