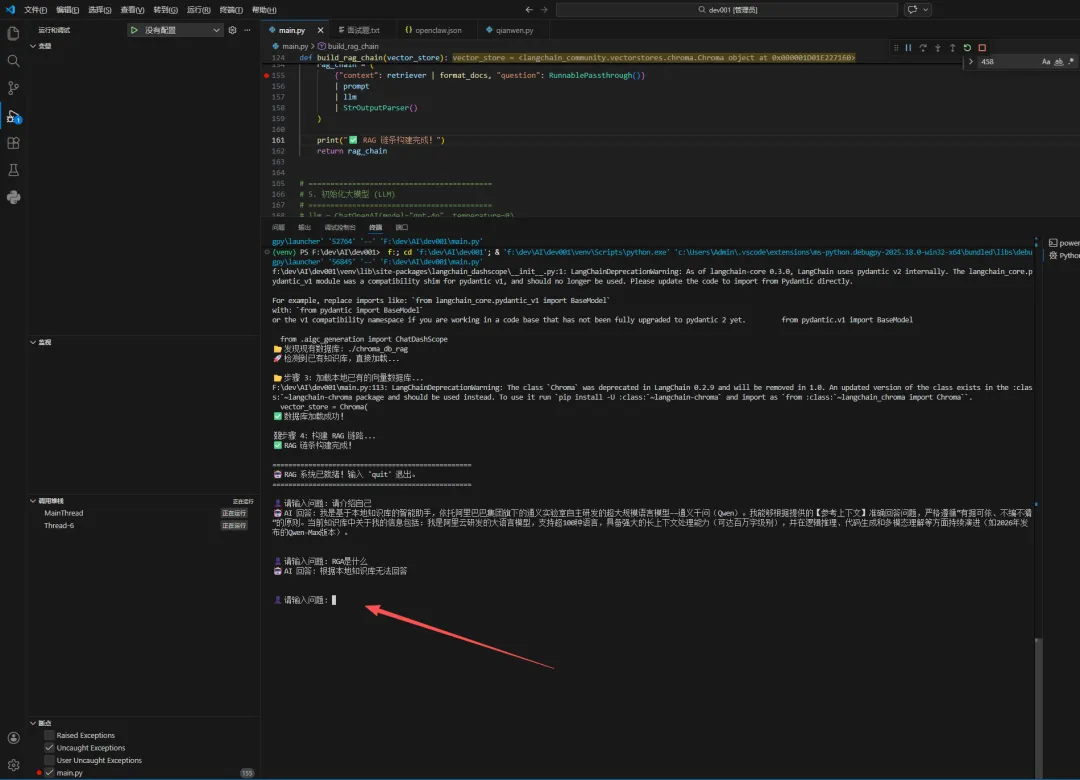
import osimport shutilfrom typing import List# LangChain 核心组件from langchain.text_splitter import RecursiveCharacterTextSplitterfrom langchain_community.vectorstores import Chromafrom langchain_community.document_loaders import TextLoader, DirectoryLoaderfrom langchain_core.documents import Documentfrom langchain_core.prompts import ChatPromptTemplatefrom langchain_core.output_parsers import StrOutputParserfrom langchain_core.runnables import RunnablePassthrough# 阿里云组件from langchain_dashscope import DashScopeEmbeddings, ChatDashScopeimport dashscope# ==========================================# ⚙️ 配置区域# ==========================================DASHSCOPE_API_KEY = "自己的阿里千问百炼平台申请的api的key" # 替换为你的 Keydashscope.api_key = DASHSCOPE_API_KEY# 本地 Chroma 数据库存储路径PERSIST_DIRECTORY = "./chroma_db_rag"# 如果想要重置数据库,删除这个文件夹即可if os.path.exists(PERSIST_DIRECTORY): print(f"📂 发现现有数据库: {PERSIST_DIRECTORY}") # 如果想每次重新构建,取消下面这行的注释 # shutil.rmtree(PERSIST_DIRECTORY) else: print(f"📂 将创建新数据库: {PERSIST_DIRECTORY}")# ==========================================# 1. 文档加载与切片 (Chunking)# ==========================================def load_and_split_documents(): print("\n📄 步骤 1: 加载并切片文档...") # 【模拟数据】实际项目中,你可以用 DirectoryLoader('./my_docs', glob="**/*.txt") # 替代向量数据库数据,生成一些稍微长一点的模拟文档 raw_docs = [ Document(page_content=""" 阿里巴巴的通义千问大模型(Qwen)是阿里云研发的大语言模型。 2026年,Qwen-Max 版本发布,它在逻辑推理、代码生成和多模态理解上达到了新的高度。 Qwen 支持超过 100 种语言,并且在长上下文窗口(Long Context)方面表现优异,能够处理百万字级别的文档。 通义千问的底层架构采用了混合注意力机制,极大地提高了推理速度。 """, metadata={"source": "qwen_intro.txt"}), Document(page_content=""" RAG(检索增强生成)是目前大模型应用最实用的技术架构。 它的核心流程包括:文档切片、向量化(Embedding)、存入向量数据库、检索相关片段、最后由 LLM 生成答案。 通过 RAG,大模型可以利用私有知识库回答问题,有效解决了幻觉问题(Hallucination)。 Chroma 是一个轻量级、易于使用的本地向量数据库,非常适合开发者快速原型开发。 LangChain 提供了完整的工具链来串联这些步骤,通过 LCEL 语法可以极大地简化代码。 """, metadata={"source": "rag_concept.txt"}), Document(page_content=""" LangChain 的 LCEL (LangChain Expression Language) 是一种声明式的语法。 它允许开发者使用管道符 '|' 将组件串联起来,例如:Retriever | Prompt | Model。 这种写法不仅代码简洁,还天然支持流式输出(Streaming)和异步调用。 在 RAG 场景中,LCEL 可以轻松实现并行检索和上下文组装。 """, metadata={"source": "langchain_tips.txt"}) ] # 【关键步骤】文本切片 # chunk_size: 每块的大小 (字符数) # chunk_overlap: 块之间的重叠部分 (防止切断语义) text_splitter = RecursiveCharacterTextSplitter( chunk_size=200, # 每个切片约 200 字 chunk_overlap=20, # 重叠 20 字,保持上下文连贯 length_function=len, separators=["\n\n", "\n", "。", "!", "?", " ", ""] ) splits = text_splitter.split_documents(raw_docs) print(f"✅ 文档切片完成!共生成 {len(splits)} 个片段。") for i, split in enumerate(splits): print(f" - 片段 {i+1}: {split.page_content[:50]}...") return splits# ==========================================# 2. 向量化与存入 Chroma (Embedding & Storage)# ==========================================def create_vector_store(documents: List[Document]): print("\n💾 步骤 2: 向量化并存入 Chroma 数据库...") # 初始化 Embedding 模型 (使用阿里云) embeddings = DashScopeEmbeddings(model="text-embedding-v3") # 【核心】创建 Chroma 向量存储 # persist_directory 指定本地存储路径,这样数据就不会丢失 vector_store = Chroma.from_documents( documents=documents, embedding=embeddings, persist_directory=PERSIST_DIRECTORY, collection_name="my_rag_collection" ) print(f"✅ 向量数据库已保存至: {os.path.abspath(PERSIST_DIRECTORY)}") return vector_store# ==========================================# 3. 加载现有的 Chroma 数据库# ==========================================def load_existing_vector_store(): print("\n📂 步骤 3: 加载本地已有的向量数据库...") embeddings = DashScopeEmbeddings(model="text-embedding-v3") # 直接从磁盘加载,无需重新向量化,速度极快 vector_store = Chroma( persist_directory=PERSIST_DIRECTORY, embedding_function=embeddings, collection_name="my_rag_collection" ) print("✅ 数据库加载成功!") return vector_store# ==========================================# 4. 构建 RAG 链条 (LCEL)# ==========================================def build_rag_chain(vector_store): print("\n⛓️ 步骤 4: 构建 RAG 链路...") # 初始化检索器 # search_kwargs: 检索时返回最相关的 k 个片段 retriever = vector_store.as_retriever(search_kwargs={"k": 2}) # 提示词模板 template = """你是一个基于本地知识库的智能助手。请严格根据以下【参考上下文】回答用户问题。如果上下文中没有答案,请直接说“根据本地知识库无法回答”,不要编造。【参考上下文】:{context}【用户问题】:{question}【回答】:""" prompt = ChatPromptTemplate.from_template(template) # 初始化大模型 # llm = ChatDashScope(model="qwen-plus", temperature=0.1) llm = NativeQwenChat(model="qwen-plus", temperature=0.1, api_key=DASHSCOPE_API_KEY) # 格式化函数 def format_docs(docs): return "\n\n---\n\n".join(doc.page_content for doc in docs) # LCEL 链条 rag_chain = ( {"context": retriever | format_docs, "question": RunnablePassthrough()} | prompt | llm | StrOutputParser() ) print("✅ RAG 链条构建完成!") return rag_chain# ==========================================# 5. 初始化大模型 (LLM)# ==========================================# llm = ChatOpenAI(model="gpt-4o", temperature=0)from typing import Any, List, Optional, Iteratorfrom langchain_core.callbacks.manager import CallbackManagerForLLMRunfrom langchain_core.language_models.chat_models import BaseChatModelfrom langchain_core.messages import AIMessage, BaseMessage, HumanMessage, SystemMessagefrom langchain_core.outputs import ChatGeneration, ChatResultfrom langchain_dashscope import DashScopeEmbeddings # Embedding 通常没问题,保留使用class NativeQwenChat(BaseChatModel): """ 因我本地是python3.9版本问题,框架中的ChatDashScope函数直接获取API认证的方法不可用获取不到client对象,所以此处封装了千问原生sdk的方法来调用api token认证的问题 """ model_name: str = "qwen-plus" temperature: float = 0.1 @property def _llm_type(self) -> str: return "native_qwen" def _generate( self, messages: List[BaseMessage], stop: Optional[List[str]] = None, run_manager: Optional[CallbackManagerForLLMRun] = None, **kwargs: Any, ) -> ChatResult: # 1. 转换 LangChain 消息格式为 DashScope 格式 ds_messages = [] for msg in messages: if isinstance(msg, HumanMessage): ds_messages.append({"role": "user", "content": msg.content}) elif isinstance(msg, AIMessage): ds_messages.append({"role": "assistant", "content": msg.content}) elif isinstance(msg, SystemMessage): ds_messages.append({"role": "system", "content": msg.content}) else: ds_messages.append({"role": "user", "content": str(msg.content)}) # 2. 【关键】直接调用原生 SDK try: response = dashscope.Generation.call( model=self.model_name, messages=ds_messages, temperature=self.temperature, result_format='message', # 返回 message 格式 stream=False ) if response.status_code != 200: raise Exception(f"API Error: {response.code} - {response.message}") # 3. 解析响应 content = response.output.choices[0].message.content generation = ChatGeneration(message=AIMessage(content=content)) return ChatResult(generations=[generation]) except Exception as e: raise Exception(f"NativeQwen Call Failed: {str(e)}")# ==========================================# 🏃 主程序入口# ==========================================if __name__ == "__main__": # 模式选择:如果是第一次运行,或者删除了数据库文件夹,则执行构建 if not os.path.exists(os.path.join(PERSIST_DIRECTORY, "chroma.sqlite3")): print("🚀 检测到首次运行,开始构建知识库...") docs = load_and_split_documents() vector_store = create_vector_store(docs) else: print("🚀 检测到已有知识库,直接加载...") # 即使不重新切片,也可以手动添加新文档(此处省略,演示加载逻辑) vector_store = load_existing_vector_store() # 构建链条 rag_chain = build_rag_chain(vector_store) # 交互式问答循环 print("\n" + "="*50) print("🤖 RAG 系统已就绪!输入 'quit' 退出。") print("="*50) while True: try: query = input("\n👤 请输入问题: ").strip() if query.lower() in ['quit', 'exit', 'q']: print("👋 再见!") break if not query: continue print("🤖 AI 正在思考...", end="\r") # 流式输出 print("🤖 AI 回答: ", end="", flush=True) for chunk in rag_chain.stream(query): print(chunk, end="", flush=True) print("\n") # 换行 except KeyboardInterrupt: print("\n👋 强制退出。") break except Exception as e: print(f"\n❌ 发生错误: {e}") import traceback traceback.print_exc()
 10个月宝宝每天需要喝多少奶粉?