前面一章,我们已经把常见字符串方法整体过了一遍。 你已经知道,字符串不是只能拿来打印,它还可以拆、可以拼、可以替换、可以清洗。
但在真实开发里,还有一类操作出现得特别频繁:
判断一段文本里有没有某个内容 判断它是不是以某个内容开头 判断它是不是以某个内容结尾 找到某个关键词第一次出现的位置
这些动作听起来很普通,但实际用得非常多。
比如:
判断文件是不是 pdf 判断网址是不是以 https 开头 判断邮箱里有没有 @ 判断日志里有没有 error 判断一条消息是不是命令开头 找到某个关键词在文本里的位置
这些需求,本质上都属于同一类:
查找与判断
这一章我们就把字符串里最常用的这几个动作彻底讲清楚。 真正掌握以后,你会发现,很多文本处理题,本质上都绕不开这几个基础操作。
一、为什么查找与判断这么重要
因为程序面对真实文本时,第一步常常不是修改,而是先确认。
先确认有没有 先确认是不是 先确认在什么位置 然后再决定下一步做什么
比如用户上传一个文件,你得先判断后缀。 比如一条日志进来,你得先判断有没有报错关键词。 比如收到一个网址,你得先判断是不是合法链接开头。 比如读到一段文本,你得先找到某个标记在哪里。
所以查找与判断,其实就是文本处理里的第一道门。
你连门都没进,后面的拆分、替换、提取自然也做不顺。
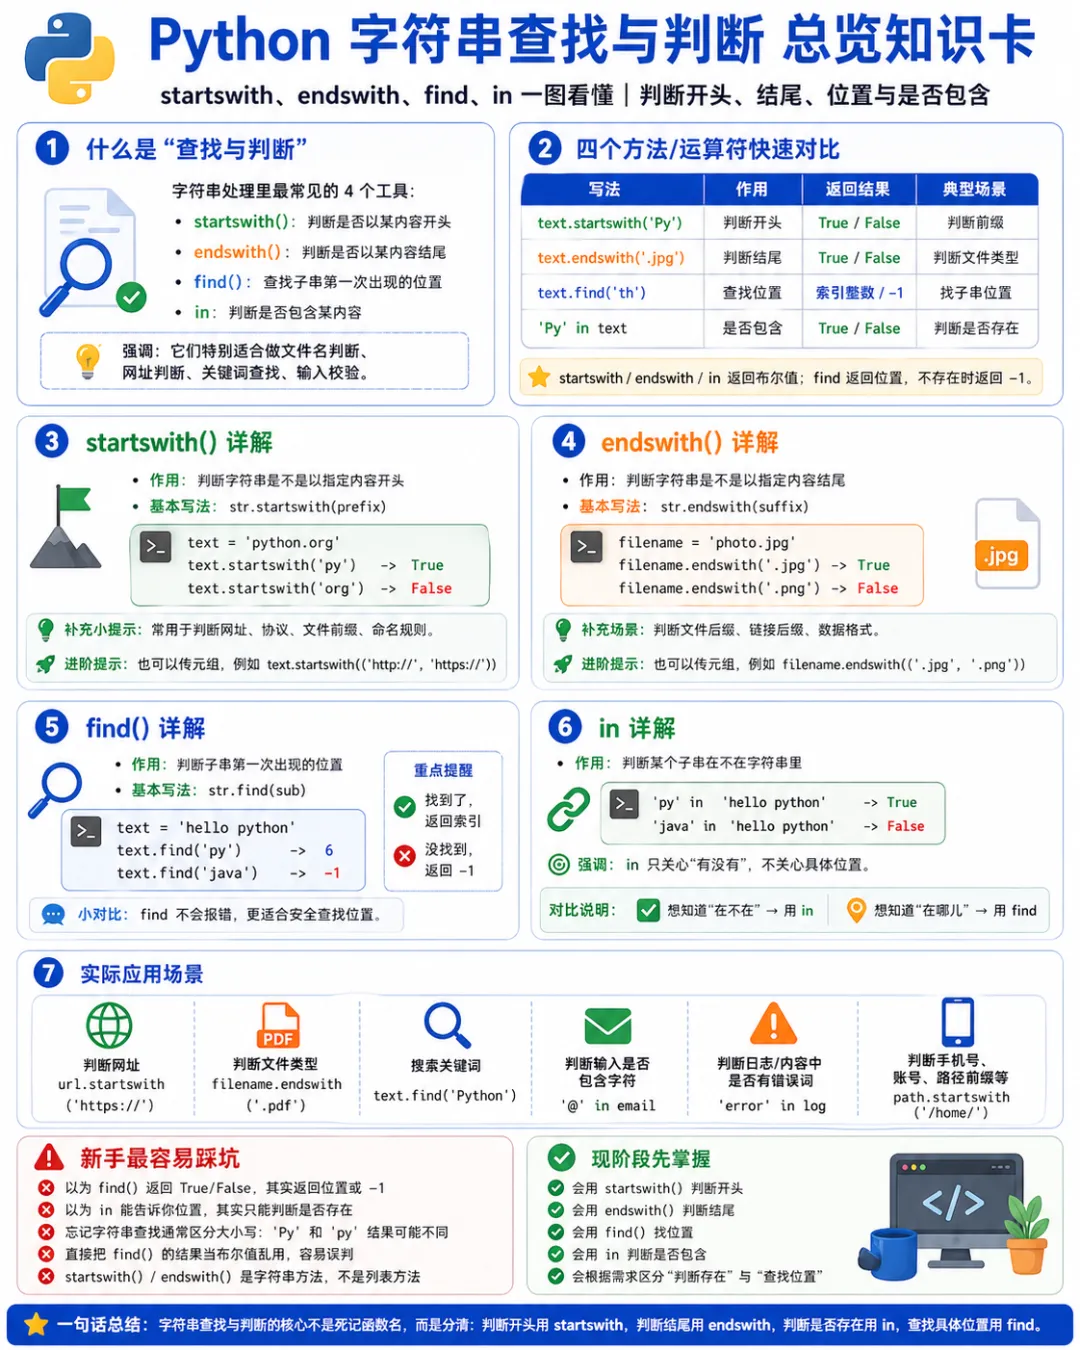
二、先认识最常用的四个工具
这一章的主角主要有四个:
startswith()endswith()find()in
你先不用急着背。 我们先用最直白的话把它们的用途说清楚。
startswith()判断字符串是不是以某个内容开头
endswith()判断字符串是不是以某个内容结尾
find()查找某个内容第一次出现的位置
in判断某个内容在不在字符串里
你会发现,这四个工具里,有的是偏判断,有的是偏定位。 它们经常搭配着用。
三、startswith():判断是不是以某个内容开头
先看最简单的例子:
url = 'https://example.com'print(url.startswith('https://'))
输出:
True
意思很直接:
这个字符串,确实是以 https:// 开头的
再看一个反例:
url = 'http://example.com'print(url.startswith('https://'))
输出:
False
因为它不是以 https:// 开头。
这个方法特别适合做开头规则判断。
比如:
判断网址协议 判断文件名前缀 判断用户输入是不是命令 判断一条文本是不是以某个关键词起头
它最大的优点就是:
语义非常清楚
你一看代码就知道,这里在判断开头,而不是去硬切片比较。
四、为什么 startswith() 往往比切片更自然
比如判断文件名是不是以 data_ 开头。
你当然可以这样写:
filename = 'data_report.txt'print(filename[:5] == 'data_')
这能跑,也没错。
但如果写成:
filename = 'data_report.txt'print(filename.startswith('data_'))
是不是明显更顺眼。
因为后者直接把你的意图说出来了:
我在判断它是不是以 data_ 开头
而不是让别人先看切片,再猜你的意思。
所以一个非常实用的经验是:
凡是判断开头,优先想到 startswith()而不是自己先切片再比
五、startswith() 在真实场景里有多常见
非常常见。
比如判断命令输入:
cmd = '/help'print(cmd.startswith('/'))
如果是 True,说明这可能是一条命令。
比如判断日志级别:
log = 'ERROR: 文件读取失败'print(log.startswith('ERROR'))
比如判断某个文件是否属于某类命名规则:
filename = 'img_001.png'print(filename.startswith('img_'))
这些都特别接近实际开发。
你以后做文件处理、命令行工具、日志分析、爬虫过滤时,经常会看到这种写法。
六、startswith() 还能一次判断多个开头
这点很多新手一开始不知道,但很好用。
比如你想判断一个文件是不是图片文件名,而且前缀可能是 img_ 或 photo_:
filename = 'photo_001.png'print(filename.startswith(('img_', 'photo_')))
输出:
True
注意这里传进去的是一个元组。 意思是:
只要符合其中任意一个开头,就算真
这在做多规则匹配时特别方便。 你不用写一长串 or。
比如判断一个网址是不是 http 或 https:
url = 'http://example.com'print(url.startswith(('http://', 'https://')))
这类写法在实战里很常见。
七、endswith():判断是不是以某个内容结尾
这个和 startswith() 是一对。
看例子:
filename = 'report.pdf'print(filename.endswith('.pdf'))
输出:
True
意思很清楚:
这个文件名,确实是以 .pdf 结尾的
再看:
filename = 'report.txt'print(filename.endswith('.pdf'))
输出:
False
它最常见的用途,就是判断后缀。
比如:
文件扩展名判断 网址后缀判断 路径结尾判断 用户名格式判断 文本标点结尾判断
八、endswith() 为什么在文件处理里特别常见
因为文件类型判断实在太高频了。
比如判断是不是图片:
filename = 'cat.jpg'print(filename.endswith('.jpg'))
判断是不是 Excel 文件:
filename = 'sales.xlsx'print(filename.endswith('.xlsx'))
判断是不是 Python 脚本:
filename = 'main.py'print(filename.endswith('.py'))
你会发现,后缀这件事如果自己切片也能做,但 endswith() 更直接、更稳。
比如你手动切片:
filename[-4:] == '.pdf'
虽然行,但可读性还是不如:
filename.endswith('.pdf')
特别是后缀长度不固定时,后者明显更舒服。
九、endswith() 也支持多个候选结尾
这点和 startswith() 一样。
比如你想判断一个文件是不是图片格式,可能是 .jpg、.png、.gif:
filename = 'avatar.png'print(filename.endswith(('.jpg', '.png', '.gif')))
输出:
True
这在文件筛选、批量处理、目录遍历时特别常见。
比如你后面处理一堆文件时,经常会写这种逻辑:
if filename.endswith(('.jpg', '.png')): print('这是图片文件')
一旦知道这个写法,代码会简洁很多。
十、startswith() 和 endswith() 的本质是什么
它们本质上都是做真假判断。
结果只有两个可能:
TrueFalse
所以它们特别适合放在 if 判断里。
比如:
filename = 'report.pdf'if filename.endswith('.pdf'): print('可以按 PDF 文件处理')else: print('不是 PDF 文件')
再比如:
url = 'https://example.com'if url.startswith('https://'): print('安全链接')
这也是为什么这两个方法特别适合拿来做规则过滤。
因为它们不是告诉你位置,而是直接告诉你:
是不是
十一、find():查找某个内容第一次出现的位置
前面两个方法更偏判断。find() 则更偏定位。
看例子:
text = 'I love Python'print(text.find('Python'))
输出:
7
意思是:
Python 这段内容,第一次从索引 7 开始出现
如果我们把这句话的位置标一下:
I _ l o v e _ P y t h o n0123456789101112
你就会更容易明白为什么返回的是 7。
所以 find() 的核心价值是:
帮你找到某段内容第一次出现的起始位置
十二、find() 找不到时会返回什么
这个点一定要记住。
如果找不到,它不会报错,而是返回:
-1
看例子:
text = 'I love Python'print(text.find('Java'))
输出:
-1
这说明 Java 不在这段文本里。
这个设计非常实用。 因为你可以根据返回值判断下一步怎么做,而不是程序直接崩掉。
比如:
text = 'I love Python'pos = text.find('Python')if pos != -1: print('找到了,位置是', pos)else: print('没找到')
这类写法很常见。
十三、find() 和 in 有什么区别
这也是很多新手容易混淆的点。
先看 in:
text = 'I love Python'print('Python'in text)
输出:
True
它只告诉你:
在不在
再看 find():
print(text.find('Python'))
输出:
7
它告诉你:
在,而且从哪开始
所以区别很简单:
in 更适合做真假判断find() 更适合做位置定位
如果你只想知道有没有,用 in 更直接。 如果你还想知道在哪,用 find() 更合适。
十四、什么时候优先用 in
当你只关心有没有的时候。
比如判断文本里有没有关键词:
text = '欢迎学习 Python'print('Python'in text)
判断邮箱里有没有 @:
email = 'tom@example.com'print('@'in email)
判断日志里有没有 error:
log = '2026-03-26 error: file not found'print('error'in log)
这些需求,本质上都不关心位置,只关心存不存在。 那 in 就非常合适。
它的好处就是简单、直观、好记。
十五、什么时候优先用 find()
当你除了想知道有没有,还想进一步处理位置时。
比如你想找到 @ 在邮箱里的位置:
email = 'tom@example.com'print(email.find('@'))
比如你想从某个标记位置开始切片:
text = 'name=tom'pos = text.find('=')print(pos)print(text[pos + 1:])
输出:
4tom
这里就很典型。
先用 find() 定位 再用切片取后面的内容
这就是字符串处理里非常常见的一套组合拳。
十六、in 的语法为什么特别像自然语言
比如:
'Python'in text
你几乎可以直接把它读成:
Python 在不在 text 里面
这就是它为什么那么受欢迎。
因为不光短,而且语义非常自然。
Python 这门语言有一个很大的特点,就是很多写法读起来就像说人话。in 就是一个很典型的例子。
所以以后你遇到成员判断,不只是字符串,列表、字典、集合里也会大量看到 in。
只是这一章,我们先聚焦在字符串里。
十七、in 在字符串里判断的是什么
它判断的是:
某段子串是否存在于原字符串中
看例子:
text = 'I love Python'print('love'in text)
输出:
True
说明 love 这整段就在里面。
再看:
print('thon'in text)
输出:
True
因为 Python 里本来就包含 thon 这段子串。
再看:
print('Java'in text)
输出:
False
这说明,in 判断的不是单个字符专属,它既能判断字符,也能判断一整段子串。
十八、not in:判断某段内容不在里面
既然有 in,自然也就有 not in。
比如:
text = 'I love Python'print('Java'notin text)
输出:
True
因为 Java 的确不在里面。
这在过滤逻辑里也很常见。
比如:
filename = 'report.pdf'if'.exe'notin filename: print('不是可执行文件')
再比如:
comment = '这门课真不错'if'广告'notin comment: print('不是广告内容')
读起来也非常自然。
十九、find() 还能从指定位置开始找
这点很实用。
比如:
text = 'abcabcabc'print(text.find('abc'))
输出:
0
因为第一次出现就是从 0 开始。
但如果你想从后面继续找,就可以指定开始位置:
print(text.find('abc', 1))
输出:
3
意思是:
从索引 1 开始往后找,第一次找到的位置是 3
再看:
print(text.find('abc', 4))
输出:
6
这个在什么场景里有用?
比如你想找第二次出现的位置, 或者跳过前面的匹配结果继续往后找。
二十、find() 还能指定结束范围
除了起始位置,还可以写结束位置。
text = 'abcabcabc'print(text.find('abc', 0, 5))
这里的意思是:
只在索引 0 到 5 这个范围内找
这样可以限制搜索区域。
虽然新手阶段最常用的是:
find(内容)
或者:
find(内容, 开始位置)
但你知道它还能控制范围,后面处理复杂文本时会更从容。
二十一、实际场景一:判断文件类型
这个太经典了。
比如一批文件名:
filename = 'photo.jpg'
你想判断是不是图片:
if filename.endswith(('.jpg', '.png', '.gif')): print('图片文件')else: print('不是图片文件')
这比手动切片判断舒服太多。
特别是后缀种类一多,endswith() 的优势就很明显。
二十二、实际场景二:判断网址是否合法开头
比如:
url = 'https://www.example.com'
你想快速筛掉明显不合法的网址:
if url.startswith(('http://', 'https://')): print('看起来像网址')else: print('格式不对')
这种逻辑在爬虫、接口请求、表单校验里都很常见。
你会发现,startswith() 本质上就是规则过滤器。
二十三、实际场景三:判断邮箱格式里有没有 @
比如:
email = 'tom@example.com'
最粗略的判断方式之一就是:
if'@'in email: print('至少包含 @')else: print('格式明显不对')
当然,真正严格的邮箱校验没这么简单。 但入门阶段你先体会这个思路就够了:
很多格式判断,第一步就是看某个关键符号在不在。
而 in 正是做这件事的最自然工具。
二十四、实际场景四:从路径里找最后一个斜杠之后的内容
比如:
path = '/home/user/report.txt'
如果你想取出文件名,前提之一就是先知道最后的分隔符在哪里。 虽然这一章主讲的是 find(),严格说处理最后一个位置还有别的方法更顺手,后面会慢慢接触到。 但你现在要先建立一个意识:
文本提取往往分两步走。
第一步,先查找标记位置。 第二步,再切片拿内容。
比如这个思路在很多题里都适用:
找到 =找到 :找到 @找到 -找到 /
然后基于这个位置再做切片。
二十五、实际场景五:过滤日志里的错误信息
假设有这样一批日志:
log1 = 'INFO: 程序启动成功'log2 = 'ERROR: 文件读取失败'log3 = 'WARNING: 内存不足'
如果你只想看错误日志:
if log2.startswith('ERROR'): print('这是错误日志')
或者你想更宽松一点,只要包含 ERROR 就算:
if'ERROR'in log2: print('检测到错误')
你看,同样是判断,选择哪个方法,取决于你判断的是:
开头规则 还是只要包含就行
这就是方法之间最实际的区别。
二十六、find() 和切片经常组合使用
这点一定要专门感受一下。
比如你有这样一行配置:
text = 'name=zhangsan'
你想拿到等号后面的值。
最自然的步骤就是:
先找 = 在哪 再从后面切出来
代码:
text = 'name=zhangsan'pos = text.find('=')value = text[pos + 1:]print(pos)print(value)
输出:
4zhangsan
这就是很典型的字符串处理思路。
查找负责定位 切片负责提取
很多文本题其实都是这个套路。
二十七、最容易犯的几个错
先说第一个。
很多人会把 find() 返回的 0 误以为是假。
比如:
text = 'Python is good'pos = text.find('Python')print(pos)
输出是:
0
这不是没找到。 这是找到了,而且就在开头。
所以判断 find() 结果时,别写得太随意。 最稳的是明确判断:
if pos != -1: print('找到了')
第二个错,是把 in 和 find() 混着用。
如果只要真假,优先 in。 如果要位置,优先 find()。
第三个错,是以为 startswith() 和 endswith() 能判断中间内容。 不能。 它们只管开头和结尾。
第四个错,是大小写问题。
比如:
text = 'Python'print('python'in text)
输出是:
False
因为大小写不一样。
字符串判断默认是区分大小写的,这一点一定要记住。
二十八、大小写不同怎么办
如果你想忽略大小写再判断,通常要先统一大小写。
比如:
text = 'Python'print('python'in text.lower())
输出:
True
再比如判断文件后缀时,有的人会传 .JPG,有的人会传 .jpg。
那你就可以先统一转成小写:
filename = 'PHOTO.JPG'if filename.lower().endswith('.jpg'): print('这是 jpg 文件')
这在真实开发里非常重要。 因为很多脏数据、用户输入,大小写都不统一。
二十九、别把这些方法当成死知识,要把它们放进动作里理解
你真正要记住的,不是四个名字,而是四种动作。
判断开头 用 startswith()
判断结尾 用 endswith()
判断在不在 用 in
查找位置 用 find()
只要你把它们和动作绑定起来,后面遇到题目时就会自然很多。
看到文件后缀,脑子里蹦出 endswith()看到网址协议,脑子里蹦出 startswith()看到关键词过滤,脑子里蹦出 in看到要提取某个标记后面的内容,脑子里蹦出 find() 加切片
这才算真正学会。
三十、练习题:这一章一定要自己写一遍
下面这些练习非常有代表性,建议你自己先敲。
1. 判断 https://openai.com 是否以 https:// 开头
url = 'https://openai.com'print(url.startswith('https://'))
2. 判断 report.pdf 是否以 .pdf 结尾
filename = 'report.pdf'print(filename.endswith('.pdf'))
3. 判断 tom@example.com 中是否包含 @
email = 'tom@example.com'print('@'in email)
4. 查找 Python 在 I love Python 中第一次出现的位置
text = 'I love Python'print(text.find('Python'))
5. 判断 Java 是否不在 I love Python 中
text = 'I love Python'print('Java'notin text)
6. 判断 PHOTO.JPG 是否是 jpg 文件,忽略大小写
filename = 'PHOTO.JPG'print(filename.lower().endswith('.jpg'))
7. 找出 name=zhangsan 里等号的位置,并取出后面的值
text = 'name=zhangsan'pos = text.find('=')print(pos)print(text[pos + 1:])
你把这些题自己敲顺了,这一章的核心就基本吃透了。
三十一、本章小结
这一章你要带走的,不只是四个函数名,而是一整套字符串查找与判断思路。
startswith() 用来判断开头。endswith() 用来判断结尾。in 用来判断某段内容在不在。find() 用来定位某段内容第一次出现的位置。 找不到时,find() 返回 -1。 而字符串判断默认区分大小写,必要时要先统一大小写再处理。
更重要的是,你要开始形成一种处理文本的基本流程:
先判断 再定位 再切片 再提取
很多字符串问题,尤其是那些看起来有点像业务的小题,最后都会回到这条主线上。
下一章我们继续讲 字符串格式化入门:从 % 到 format。 到那一章,你会开始学习怎么把变量、数字、文本更优雅地塞进一段完整的话里,让输出不只是能跑,而且更整齐、更专业。
 10个月宝宝每天需要喝多少奶粉?