Linux 内核漏洞又上热榜,嵌入式设备别只问“补丁在哪”,先跑这份应急清单
2026-05 中旬,Linux 内核安全又密集上了一波新闻。
Red Hat 在 2026-05-16 发布 RHSB-2026-004,讨论 CVE-2026-46333 对 Linux 内核权限检查绕过的影响;同一阶段,Dirty Frag/Fragnesia、Copy Fail 相关漏洞也在安全社区和厂商公告里被反复提到。
如果你做的是服务器,动作可能很直接:看发行版公告、更新内核、重启。
但嵌入式设备没这么轻松。
网关、工业控制器、边缘 AI 盒子、车载终端、机器人控制器,很多已经发到现场。你不能只问“补丁在哪”,还要问:哪些设备受影响?现场能不能重启?OTA 会不会变砖?回滚有没有验证?临时缓解会不会影响业务?
今天这篇不复现漏洞,也不讲攻击细节。我们按工程应急来,把嵌入式 Linux 设备遇到内核 CVE 后该怎么处理捋一遍。
先别急着找补丁,先判断这台设备有没有暴露面
看到内核漏洞,很多团队第一反应是“赶紧升级内核”。
这个方向没错,但顺序不能乱。
在嵌入式产品里,第一步应该是判断暴露面:
- 是否需要 shell、SSH、串口、Web 终端或容器入口;
- 设备是否允许第三方插件、脚本、模型包、规则包运行;
- 是否开启对应内核功能、文件系统、网络协议、驱动模块;
同一个 CVE,在不同产品上的优先级可能完全不同。
如果你的设备没有普通用户登录入口,没有容器,没有插件执行环境,漏洞可能仍然要修,但应急优先级和临时缓解手段会不一样。
如果你的设备开放 SSH,Web 后台还能上传脚本,或者容器里跑了第三方应用,那就要严肃得多。
第一步:把现场设备版本盘清楚
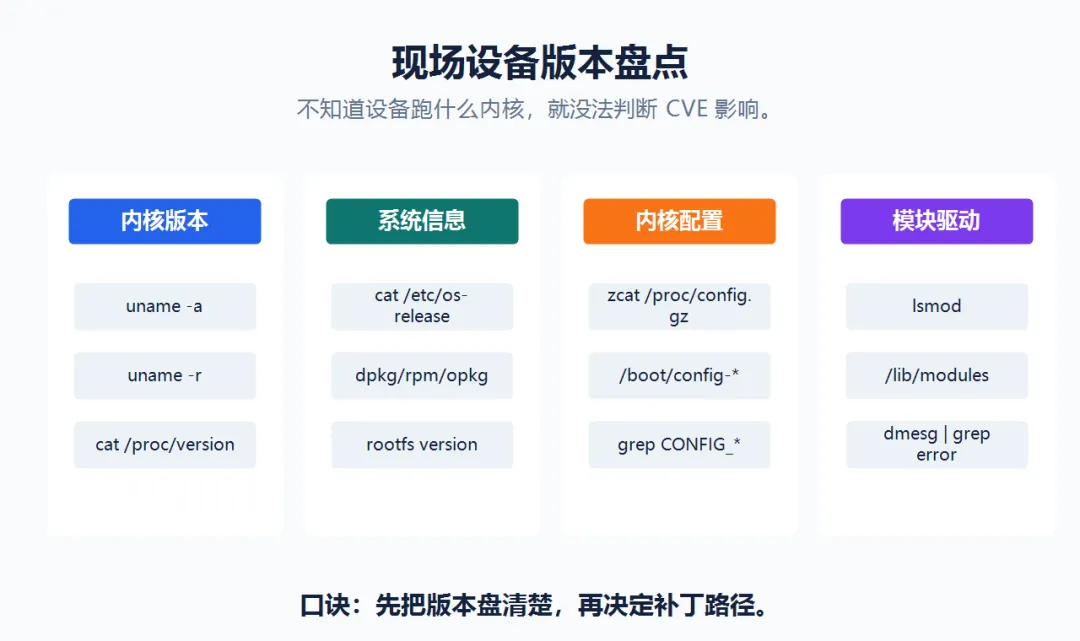
很多团队补丁慢,不是因为不会编内核,而是因为不知道现场到底跑着什么。
先做版本盘点。
在设备上至少收集这些信息:
uname -a
uname -r
cat /etc/os-release 2>/dev/null || true
cat /proc/version
如果系统保留了内核配置:
zcat /proc/config.gz | grep -E 'USER_NS|SECCOMP|BPF|AF_ALG|OVERLAY_FS'
如果 /proc/config.gz 不存在,试试:
ls /boot
cat /boot/config-$(uname -r) 2>/dev/null | grep -E 'USER_NS|SECCOMP|BPF|AF_ALG|OVERLAY_FS'
再看内核模块:
lsmod
find /lib/modules/$(uname -r) -type f | head
不同根文件系统的包管理器不一样,也可以顺手查:
# Debian/Ubuntu 系
dpkg -l | grep -E 'linux-image|linux-modules' || true

# RPM 系
rpm -qa | grep -E '^kernel|linux' || true

# OpenWrt/Yocto 常见 opkg
opkg list-installed | grep -E 'kernel|kmod' || true
这些命令看起来普通,但应急时非常救命。
因为你要先回答三个问题:
没有这三件事,后面全是猜。
第二步:给设备分层,不要一刀切
嵌入式设备通常不是一类。
同一个产品线里,可能有:
建议分成三层:
高风险:
中风险:
低风险:
这样做不是为了拖延升级,而是为了决定先救哪一批设备。
安全应急最怕平均用力。高风险设备先做临时缓解和灰度升级,低风险设备可以进入常规维护窗口。
第三步:临时缓解要写清楚“代价”
有些漏洞短期内没法立刻升级内核。
可能是:
这时候就要做临时缓解。
但缓解不是随手关一个开关。你要写清楚它解决什么、影响什么、怎么回退。
比如本地提权类漏洞,常见缓解方向包括:
- 收紧
ptrace、user namespace、BPF 等高风险能力;
示例配置可以这样检查:
# 看普通用户和 shell
cat /etc/passwd

# 看 SSH 是否允许密码登录和 root 登录
grep -E 'PasswordAuthentication|PermitRootLogin' /etc/ssh/sshd_config

# 看 ptrace 限制
cat /proc/sys/kernel/yama/ptrace_scope 2>/dev/null || true

# 看 user namespace 是否开放
cat /proc/sys/kernel/unprivileged_userns_clone 2>/dev/null || true
临时调高 ptrace_scope 的例子:
sysctl -w kernel.yama.ptrace_scope=2
如果系统支持 unprivileged_userns_clone,也可以检查是否需要关闭:
sysctl -w kernel.unprivileged_userns_clone=0
注意,这些只是示例,不是万能药。
某些设备依赖容器、调试、运行时沙箱或特定应用权限,贸然关闭会影响业务。所以每一条缓解都要配一条验证项:
缓解措施:关闭普通用户 SSH 密码登录
影响范围:远程维护方式变化
验证方法:运维密钥登录正常,Web 后台正常,业务进程不受影响
回退方法:恢复原 sshd_config 并重启 sshd
这才是工程上能交付的应急动作。
第四步:Yocto/Buildroot 项目要找到“内核从哪来”
很多嵌入式 Linux 项目不是直接 apt upgrade。
你可能用的是 Yocto、Buildroot、OpenWrt、厂商 SDK,甚至是供应商给的一套老 BSP。
所以补内核前,先找到内核来源。
Yocto 项目里,常见线索包括:
grep -R "PREFERRED_PROVIDER_virtual/kernel" -n conf meta-* 2>/dev/null
grep -R "linux-" -n meta-*/*/recipes-kernel 2>/dev/null | head
grep -R "SRCREV" -n meta-*/*/recipes-kernel/linux 2>/dev/null | head
你要确认:
- 用的是
linux-yocto,还是厂商 linux-imx、linux-ti、linux-stm32mp 一类; - 补丁是放在 recipe 里,还是放在厂商 layer 里;
- defconfig 和设备树是否跟着内核一起维护。
Buildroot 项目里,常见线索是:
grep -E "BR2_LINUX_KERNEL" .config
grep -R "BR2_LINUX_KERNEL_CUSTOM_VERSION_VALUE" -n .
find board -type f | grep -E 'linux|defconfig|patch'
如果用的是厂商 SDK,要找:
不要只把内核源码换成新版本就完事。
嵌入式内核里经常有厂商补丁、驱动补丁、设备树、外设时序、GPU/NPU/Wi-Fi 模块依赖。补安全漏洞要尽量在当前维护分支上回合补丁,或者升级到供应商确认过的版本。
第五步:验证不只看能不能启动
内核安全更新最容易犯的错是:设备能启动,就算通过。
这远远不够。
至少要做四类验证。
第一类:版本验证。
uname -a
uname -r
cat /proc/version
确认启动的是新内核,不是只更新了 rootfs。
第二类:模块验证。
lsmod
dmesg | grep -i -E 'fail|error|firmware|module'
find /lib/modules/$(uname -r) -type f | wc -l
很多现场事故不是内核起不来,而是某个外部模块版本不匹配。
第三类:业务验证。
按设备类型列用例:
第四类:安全验证。
# SSH 配置是否符合预期
ss -tlnp
grep -E 'PermitRootLogin|PasswordAuthentication' /etc/ssh/sshd_config 2>/dev/null

# 高风险入口是否关闭
ps aux
mount
如果设备有容器,还要检查:
docker ps 2>/dev/null || true
docker inspect <container> 2>/dev/null | grep -E 'Privileged|PidMode|NetworkMode'
当然,产品不一定用 Docker。这里重点是:有隔离环境,就要检查隔离边界有没有因为升级或临时缓解发生变化。
第六步:OTA 必须有回滚,不然安全更新会变成生产事故
嵌入式设备最怕“补丁是对的,升级过程把设备弄死了”。
尤其是内核更新。
如果你的产品支持 A/B 分区,建议至少确认:
- bootloader 能从 A/B 两个 slot 启动;
- 设备启动后是否能写入 boot success 标志;
一个简化的状态流可以是:
下载更新包
写入 inactive slot
校验 hash/signature
设置 boot target = new slot
重启
业务健康检查通过
标记 new slot 为 good
失败则回滚 old slot
如果没有 A/B,只能原地更新,也要更谨慎:
安全补丁很重要,但把设备批量升级成不可用,也是一种事故。
最后给一份发布前检查表
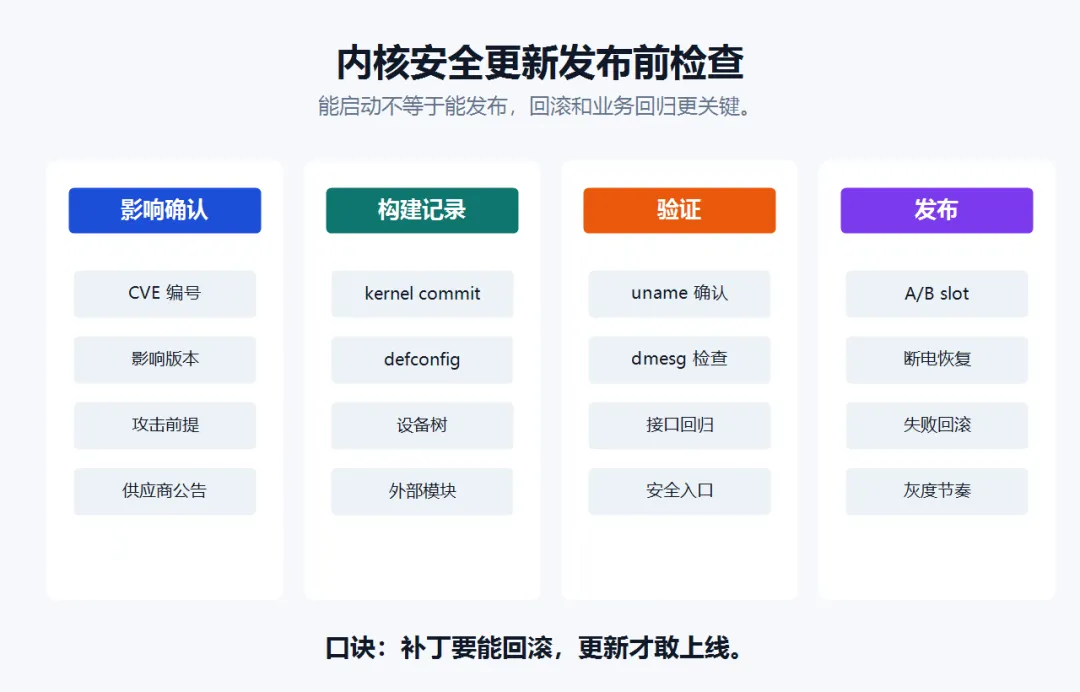
嵌入式 Linux 内核 CVE 应急,可以按这份表收尾:
漏洞情报确认
CVE 编号、影响版本、攻击前提、供应商公告、补丁来源都记录清楚。
设备资产盘点
现场设备型号、内核版本、BSP 分支、rootfs 版本、联网状态、运维入口都有清单。
暴露面判断
是否有 SSH、Web 后台、容器、插件、脚本、普通用户、调试口。
临时缓解方案
每条缓解都写清楚影响范围、验证方法和回退方法。
内核构建记录
Yocto/Buildroot/SDK 的源码 commit、补丁、defconfig、设备树、外部模块版本都留档。
OTA 和回滚验证
A/B 切换、断电恢复、失败回滚、业务健康检查、升级日志都跑过。
业务回归
网络、存储、串口、CAN、I2C、SPI、GPIO、摄像头、看门狗、低功耗按产品类型验证。
发布节奏
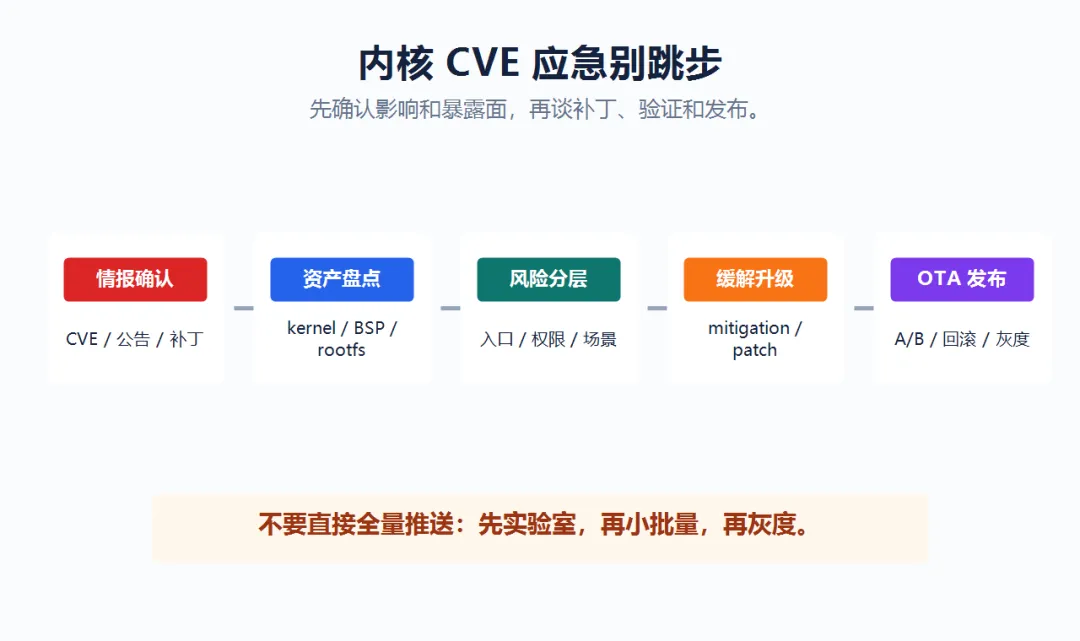
先实验室,再小批量,再灰度,再全量。不要直接把安全更新推到所有现场设备。
小站观点
嵌入式 Linux 的安全更新,最难的不是“知道有漏洞”,也不是“找到补丁”。
真正难的是把补丁变成现场可交付的更新:版本要盘清,风险要分层,临时缓解不能误伤业务,内核和模块要匹配,OTA 要能回滚,发布节奏要稳。
很多设备寿命比开发团队想象得长。今天的内核安全应急流程,其实也是在补产品生命周期管理这门课。
你们项目现在有没有完整记录:每一批现场设备跑的内核版本、BSP 分支、OTA slot、回滚状态?如果没有,下一次 CVE 来的时候,最先卡住的可能不是技术,而是这张表。