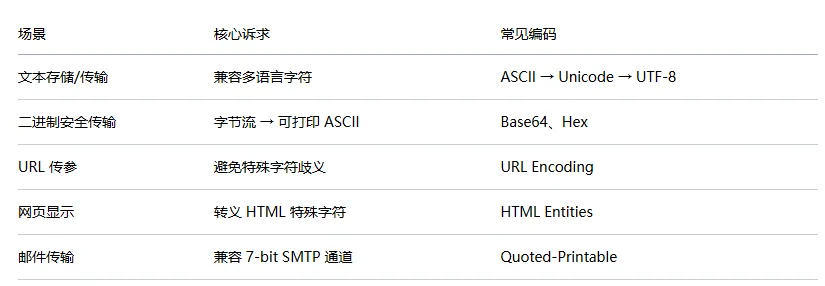
为什么需要编码?计算机只认识 0 和 1,所有文本、图片、音视频最终都要变成字节序列才能存储和传输。编码(Encode)就是把人类可读的信息转换成字节序列,解码(Decode)则是逆过程。不同场景对编码有不同的诉求:
1. ASCII 与 Unicode
1.1 ASCII
最早的字符编码,用 7 位二进制表示 128 个字符(英文字母、数字、标点、控制符)。
ASCII 编码与解码
text = "Hello"# 编码:字符串 → 字节序列encoded = text.encode("ascii")print(encoded) # b'Hello'print(list(encoded)) # [72, 101, 108, 108, 111]# 解码:字节序列 → 字符串decoded = encoded.decode("ascii")print(decoded) # Hello
局限:ASCII 只能表示英文,中文、日文、Emoji 等都无法覆盖。
1.2 Unicode 与 UTF-8
Unicode 是字符集(给每个字符分配唯一编号),UTF-8 是编码方式(把编号转换成字节序列)。
UTF-8 编码规则:
text = "编码 Encoding 🚀"# 编码encoded = text.encode("utf-8")print(encoded)# b'\xe7\xbc\x96\xe7\xa0\x81 Encoding \xf0\x9f\x9a\x80'# 查看每个字符占用的字节数for char in "A中🚀": b = char.encode("utf-8") print(f"'{char}' → {len(b)} 字节 → {b.hex()}")# 'A' → 1 字节 → 41# '中' → 3 字节 → e4b8ad# '🚀' → 4 字节 → f09f9a80
# 解码
decoded = encoded.decode("utf-8")print(decoded) # 编码 Encoding 🚀```
1.3 乱码的本质
乱码就是用错误的编码方式去解码字节序列:
# 用 UTF-8 编码中文
raw = "你好".encode("utf-8") # b'\xe4\xbd\xa0\xe5\xa5\xbd'# 正确解码print(raw.decode("utf-8")) # 你好# 错误解码 → 乱码print(raw.decode("latin-1")) # ä½ å¥½(乱码)print(raw.decode("gbk")) # 浣犲ソ(乱码,GBK 把 3 字节按 2 字节拆解)
2. Base64
Base64 把任意二进制数据转换成 64 个可打印 ASCII 字符(`A-Z a-z 0-9 + /`),常用于在文本协议(HTTP、JSON、邮件)中传输二进制数据。
原理:每 3 字节(24 bit)拆成 4 组,每组 6 bit,映射到 Base64 字符表。
原始: 01001000 01100101 01101100 (3字节 = 24 bit)
拆分: 010010 000110 010101 101100 (4组 × 6 bit)
映射: SG Vs → "SGVs"
# ── 基本用法 ──
import base64text = "Hello, 编码世界!"encoded = base64.b64encode(text.encode("utf-8"))print(encoded) # b'SGVsbG8sIOe8oeeahOS4lueVjO+8mg=='decoded = base64.b64decode(encoded).decode("utf-8")print(decoded) # Hello, 编码世界!
# ── URL Safe Base64 ──
# 标准Base64中的 + / 在URL中有特殊含义,URL Safe用 - _ 替换
data = b"\xfb\xff"standard = base64.b64encode(data) # b'+/8='url_safe = base64.urlsafe_b64encode(data) # b'-_8='print(f"标准: {standard}, URL Safe: {url_safe}")
# ── Base64 编码图片 ──
import struct# 模拟一个小的 PNG 文件头png_header = b'\x89PNG\r\n\x1a\n'b64_png = base64.b64encode(png_header).decode("ascii")print(f"data:image/png;base64,{b64_png}")# data:image/png;base64,iVBORw0KGgo=
注意:Base64 编码后体积膨胀约 **33%**(3 字节变 4 字节),不适合大文件传输。
3. Hex 编码(十六进制)
把每个字节直接表示为两个十六进制字符(`0-9 a-f`),编码后体积翻倍但完全可读,常用于哈希值、密钥、MAC 地址的展示。
# ── bytes ↔ hex 字符串 ──
data = b"\x00\xff\x41\x42"hex_str = data.hex()print(hex_str) # 00ff4142restored = bytes.fromhex(hex_str)print(restored) # b'\x00\xffAB'
# ── 常见场景:哈希值展示 ──
import hashlibdigest = hashlib.sha256(b"hello").digest()print(digest.hex())#2cf24dba5fb0a30e26e83b2ac5b9e29e1b161e5c1fa7425e73043362938b9824# ── 格式化输出 ──mac = b"\x08\x00\x27\x5c\x8a\x3f"mac_str = ":".join(f"{b:02x}" for b in mac)print(mac_str) # 08:00:27:5c:8a:3f# ── 大整数编码(如 RSA 模数)──n = 0x00ff4142print(n.to_bytes(4, "big").hex()) # 0000ff4142
4. URL Encoding(百分号编码)
URL 中只能包含 ASCII 字符的子集,特殊字符和非 ASCII 字符需要用 `%XX` 编码。
from urllib.parse import quote, unquote, urlencode, parse_qs# ── 基本编码 ──# 中文和特殊字符都会被编码url = "https://example.com/search?q=Python 编码&lang=zh"encoded = quote(url, safe="")print(encoded)#ttps%3A%2F%2Fexample.com%2Fsearch%3Fq%3DPython%20%E7%BC%96%E7%A0%81%26lang%3Dzhdecoded = unquote(encoded)print(decoded) # https://example.com/search?q=Python 编码&lang=zh
# ── 只编码查询参数(推荐做法)──
# safe="/" 保留路径分隔符
print(quote("Python 编码", safe=""))# Python%20%E7%BC%96%E7%A0%81# ── 构建查询字符串 ──params = {"q": "Python 编码", "lang": "zh", "page": 1}query_string = urlencode(params)print(query_string)# q=Python+%E7%BC%96%E7%A0%81&lang=zh&page=1# ── 解析查询字符串 ──parsed = parse_qs(query_string)print(parsed) # {'q': ['Python 编码'], 'lang': ['zh'], 'page': ['1']}
**编码规则速查**:
5. HTML Entity Encoding
网页中 `<`、`>`、`&` 等字符有特殊含义,需要转义为 HTML 实体,防止 XSS 注入和渲染错误。
import html# ── 转义 ──raw_html = '<script>alert("XSS & HTML")</script>'escaped = html.escape(raw_html)print(escaped)# <script>alert("XSS & HTML")</script># ── 反转义 ──original = html.unescape(escaped)print(original) # <script>alert("XSS & HTML")</script># ── 常见实体 ──entities = { "<": "<", ">": ">", "&": "&", '"': """, "'": "'",}for char, entity in entities.items(): print(f"'{char}' → '{entity}'")
实际应用:在 Web 框架的模板引擎中,默认会对变量输出做 HTML 转义,防止 XSS 攻击。
6. Quoted-Printable
邮件系统(SMTP)传统上只支持 7-bit ASCII,Quoted-Printable 编码让非 ASCII 字符用=XX表示,ASCII 可打印字符保持原样,适合大部分是英文、少量非 ASCII 的内容。
import quopri# ── 编码 ──text = "Hello 编码世界, this is a test."encoded = quopri.encodestring(text.encode("utf-8"))print(encoded)# b'Hello =E7=BC=96=E7=A0=81=E4=B8=96=E7=95=8C, this is a test.'
# ── 解码 ──
decoded = quopri.decodestring(encoded).decode("utf-8")print(decoded) # Hello 编码世界, this is a test.
对比 Base64:QP 保持英文可读,Base64 全部变成不可读
import base64print(base64.b64encode(text.encode("utf-8")))# b'SGVsbG8g57yQ56CB5LiW55WM77yI...
7. 完整对比
各种编码方式对比演示
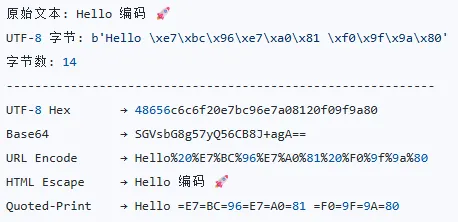
import base64import quopriimport htmlfrom urllib.parse import quoteoriginal = "Hello 编码 🚀"results = { "UTF-8 Hex": original.encode("utf-8").hex(), "Base64": base64.b64encode(original.encode("utf-8")).decode(), "URL Encode": quote(original, safe=""), "HTML Escape": html.escape(original), "Quoted-Print": quopri.encodestring(original.encode("utf-8")).decode(),}print(f"原始文本: {original}")print(f"UTF-8 字节: {original.encode('utf-8')}")print(f"字节数: {len(original.encode('utf-8'))}")print("-" * 60)for name, encoded in results.items(): print(f"{name:15s} → {encoded}")
输出:
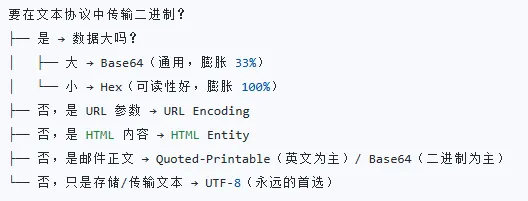
编码选型决策
要在文本协议中传输二进制?
核心原则:
编码不是加密。所有上述编码方式都是公开标准,任何人都能解码。编码的目的是兼容性(让数据能安全通过不同通道),不是保密性。如果需要保密,请使用 AES、RSA 等加密算法。