RAG 是 AI 应用技术中的一项关键技术,全称 Retrieval-Augmented Generation(检索增强生成)。它的核心思想很简单:不让大模型“闭门造车”,而是先去资料库里查一查,再把查到的内容连同问题一起交给模型回答。
本质上,RAG 就是在“检索”和“生成”之间搭了一座桥,让 AI 的回答既有大模型的表达能力,又有外部知识库的准确率。
RAG 通俗定义与核心价值
直白解释
RAG = Retrieval-Augmented Generation,检索增强生成。 核心思想一句话: 不让大模型凭空胡编(幻觉),先去私有知识库检索相关片段,再把「检索到的参考内容 + 用户问题」一起交给大模型作答。
解决两大痛点:
- 企业私有文档、内部资料无法喂进模型,RAG 实现外挂知识库问答。
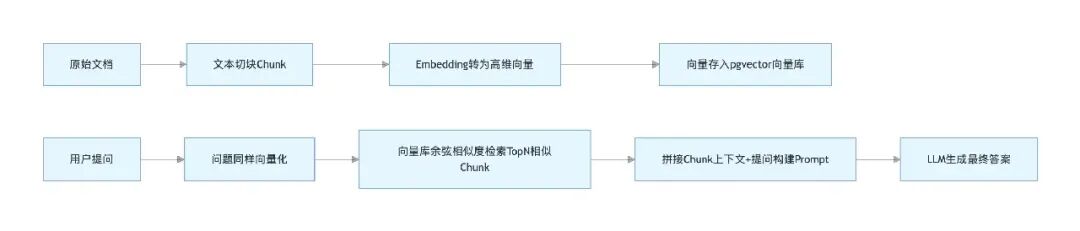
标准6步完整流程
RAG里的高中数学知识
向量是什么?
向量就是既有大小,又有方向的量。比如高速路上“120 km/h 向北”的速度、火箭起飞时“20 m/s² 沿飞行方向”的加速度,都是向量。
如果只说“120 km/h”“20 m/s²”,没说方向,那就是标量。在数学里,向量还可以是一组数,用来表示位置、状态甚至语义,不一定非得画成一根箭头。
相似度计算:余弦相似度
判断两个向量是否代表相近语义,依靠余弦夹角公式:
pgvector 向量数据库本质就是批量快速做海量向量的余弦相似度近似检索,普通关系型数据库无法高效完成高维向量近邻搜索,这也是向量库存在的意义。
一句话大白话:把文字变成空间中的点,离得近 = 意思差不多。
环境准备
学习 rag 之前需要准备好 python 环境,还有向量数据库。这里 python 我使用 python3.11.7, 向量数据库选择 postgresql(装pgvector插件)。
pyenv 安装 Python
pyenv install 3.11.7
pyenv local 3.11.7
python -m venv .venv
source .venv/bin/activate
PostgreSQL + pgvector
直接安装官方维护的 pg 镜像,即pgvector/pgvector:pg16
docker run -d \
  --name pg-vector \
  -p 5432:5432 \
  -e POSTGRES_PASSWORD=password \
  -e POSTGRES_USER=postgres \
  -v pgvector_data:/opt/pg16/data \
  pgvector/pgvector:pg16
创建数据库并启用pgvector。这一步其实可以省略,因为我们使用的是pgvector/pgvector:pg16镜像,它已经装好了pgvector插件。
createdb rag_demo
psql rag_demo -c "CREATE EXTENSION IF NOT EXISTS vector;"
检索的原理
余弦相似度
RAG 的检索环节,本质是向量空间中的距离计算。常见做法是计算两个向量的余弦相似度: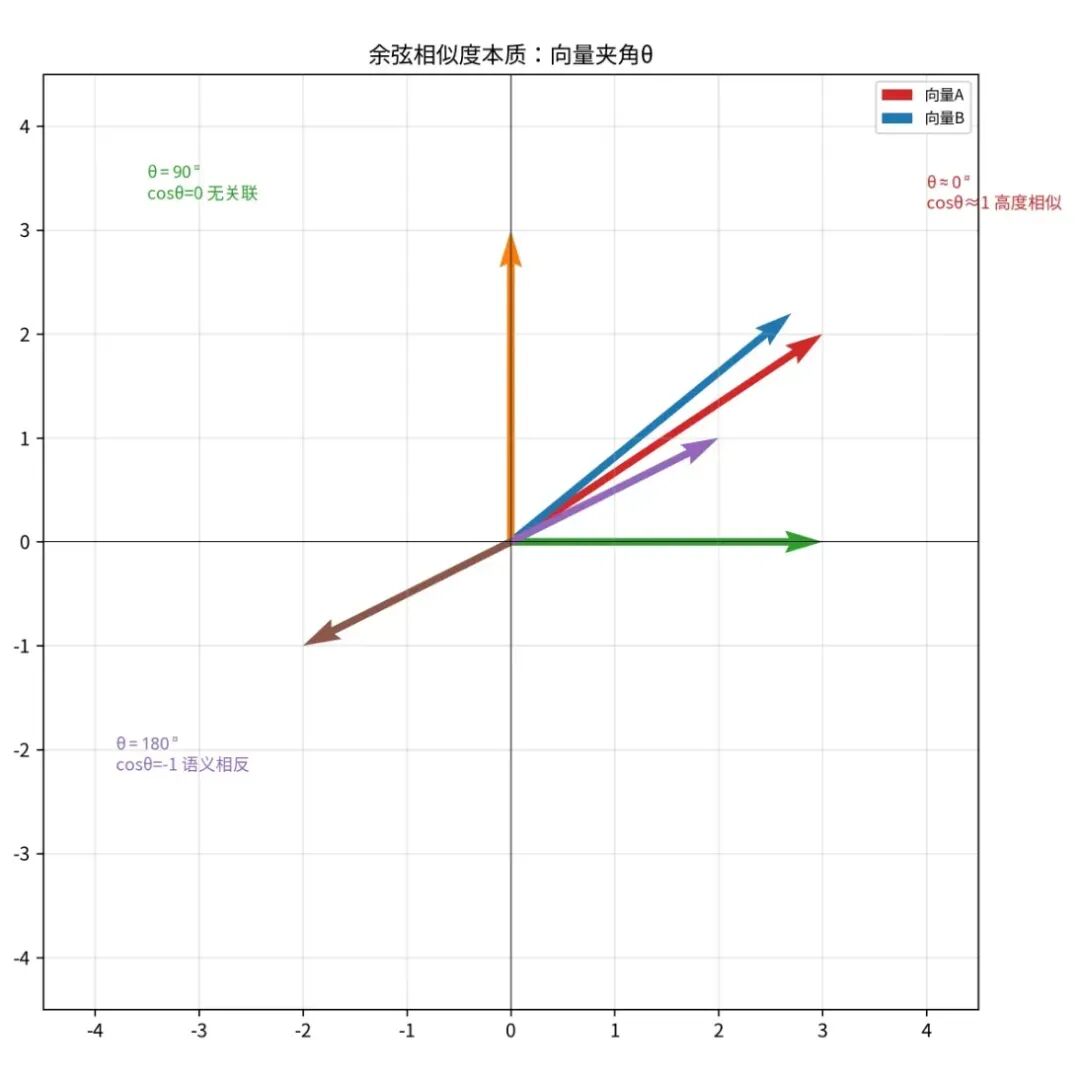
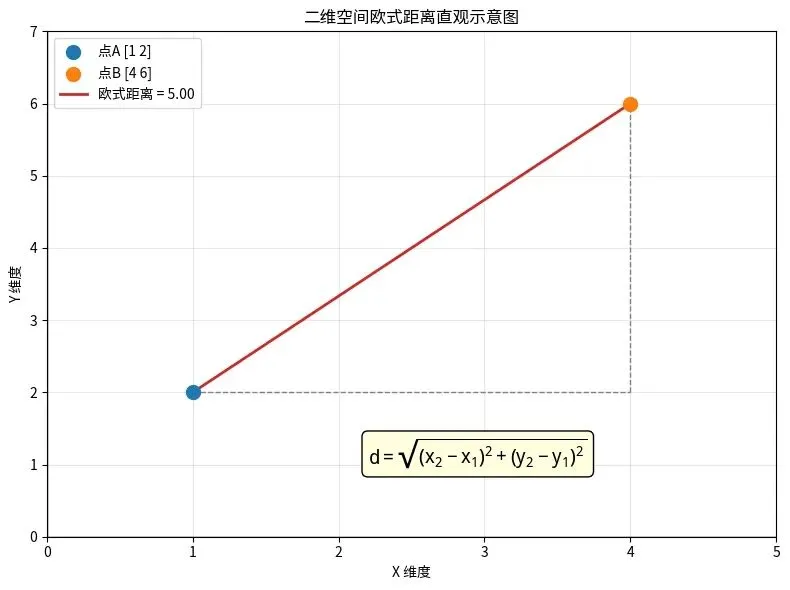
欧式距离
这其实就是高中向量的点积公式。而在 pgvector 中,<-> 使用的是 L2 欧氏距离,同样也是纯数学运算。
实操
项目结构
(.venv) ➜  ragDemo tree
.
├── README.md
├── __pycache__
│   └── main.cpython-311.pyc
├── main.py
└── requirements.txt
依赖安装
pip install -r requirements.txt
psycopg[binary]
pgvector
openai
sentence-transformers
python-dotenv
整体逻辑说明
- 使用开源 all-MiniLM-L6-v2 做本地 Embedding,无需付费接口
.env
DEEPSEEK_API_KEY=sk-your-deepseek-api-key
DEEPSEEK_BASE_URL=https://api.deepseek.com
DEEPSEEK_MODEL=deepseek-v4-flash
main.py
import os

from dotenv import load_dotenv
from openai import OpenAI
import psycopg
from pgvector.psycopg import register_vector
from sentence_transformers import SentenceTransformer

load_dotenv()

# ====================== 配置区 ======================
DB_CONFIG = {
"dbname": os.getenv("DB_NAME", "rag_demo"),
"user": os.getenv("DB_USER", "postgres"),
"password": os.getenv("DB_PASSWORD", "password"),
"host": os.getenv("DB_HOST", "localhost"),
"port": int(os.getenv("DB_PORT", "5432")),
}

EMBED_MODEL = SentenceTransformer("all-MiniLM-L6-v2")

LLM_CLIENT = OpenAI(
    base_url=os.getenv("DEEPSEEK_BASE_URL", "https://api.deepseek.com"),
    api_key=os.environ["DEEPSEEK_API_KEY"],
)
LLM_MODEL_NAME = os.getenv("DEEPSEEK_MODEL", "deepseek-chat")

KNOWLEDGE_LIST = [
"PostgreSQL 是一款功能强大的开源关系型数据库。",
"pgvector 是 PostgreSQL 的向量相似度检索扩展。",
"RAG(检索增强生成)结合检索与生成,让大模型回答更准确、更有依据。",
"Python 在人工智能和数据工程领域被广泛使用。",
"中华人民共和国成立于1949年10月1日,首都为北京。",
"长江是中国第一长河,全长约6397公里,发源于青藏高原。",
"长城是中国古代伟大的防御工程,1987年被列入世界文化遗产。",
"中国有56个民族,汉族人口约占全国总人口的91%以上。",
"北京故宫又称紫禁城,是明清两代的皇家宫殿,位于北京市中心。",
"大熊猫是中国特有的珍稀动物,主要栖息于四川、陕西和甘肃的山区。",
"中国是世界第二大经济体,制造业规模连续多年位居全球第一。",
"春节是中国最重要的传统节日,人们通常会贴春联、吃年夜饭、放鞭炮。",
"上海位于长江入海口,是中国最大的经济中心和重要国际金融城市。",
"汉字是世界上使用人数最多的文字系统,已有数千年的历史。",
]


def get_connection(*, register_vector_adapter=True):
    conn = psycopg.connect(**DB_CONFIG)
if register_vector_adapter:
        register_vector(conn)
return conn


# ====================== 1. 初始化数据库结构 ======================
def init_db():
    conn = get_connection(register_vector_adapter=False)
    cur = conn.cursor()

    cur.execute("CREATE EXTENSION IF NOT EXISTS vector;")
    conn.commit()
    register_vector(conn)

    cur.execute("""
        CREATE TABLE IF NOT EXISTS documents (
            id SERIAL PRIMARY KEY,
            content TEXT UNIQUE,
            embedding VECTOR(384)
        );
    """)
    cur.execute("""
        CREATE INDEX IF NOT EXISTS documents_embedding_idx
        ON documents USING hnsw (embedding vector_cosine_ops);
    """)

    conn.commit()
    cur.close()
    conn.close()
print("数据库初始化完成")


# ====================== 2. 向量写入数据库 ======================
def embed_and_store(texts=None):
    texts = texts or KNOWLEDGE_LIST
    conn = get_connection()
    cur = conn.cursor()

for text in texts:
        vec = EMBED_MODEL.encode(text)
        cur.execute(
"""
            INSERT INTO documents (content, embedding) VALUES (%s, %s)
            ON CONFLICT (content) DO NOTHING
            """,
            (text, vec),
        )

    conn.commit()
    cur.close()
    conn.close()
print(f"知识库向量入库完成(共 {len(texts)} 条,重复内容自动跳过)")


# ====================== 3. 根据问题检索相似文本 ======================
def retrieve_top_k(query: str, top_k=3):
    query_vec = EMBED_MODEL.encode(query)
    conn = get_connection()
    cur = conn.cursor()

    cur.execute(
"""
        SELECT content FROM documents
        ORDER BY embedding <=> %s::vector
        LIMIT %s;
        """,
        (query_vec, top_k),
    )

    res = cur.fetchall()
    cur.close()
    conn.close()
return [row[0] for row in res]


# ====================== 4. 组装 Prompt 调用大模型回答 ======================
def ask(question: str):
    context_list = retrieve_top_k(question)
    context_str = "\n".join(context_list)

    prompt = f"""
请严格根据下面参考上下文回答用户问题,上下文没有的内容不要编造:
【参考上下文】
{context_str}

【用户问题】
{question}
"""
    resp = LLM_CLIENT.chat.completions.create(
        model=LLM_MODEL_NAME,
        messages=[{"role": "user", "content": prompt}],
    )
return resp.choices[0].message.content


if __name__ == "__main__":
    init_db()
    embed_and_store()

    q = "中国有多少个民族"
    ans = ask(q)
print("回答结果:", ans)
这里特地写了一个错误的答案,验证ragDemo 程序稍后是否能召回.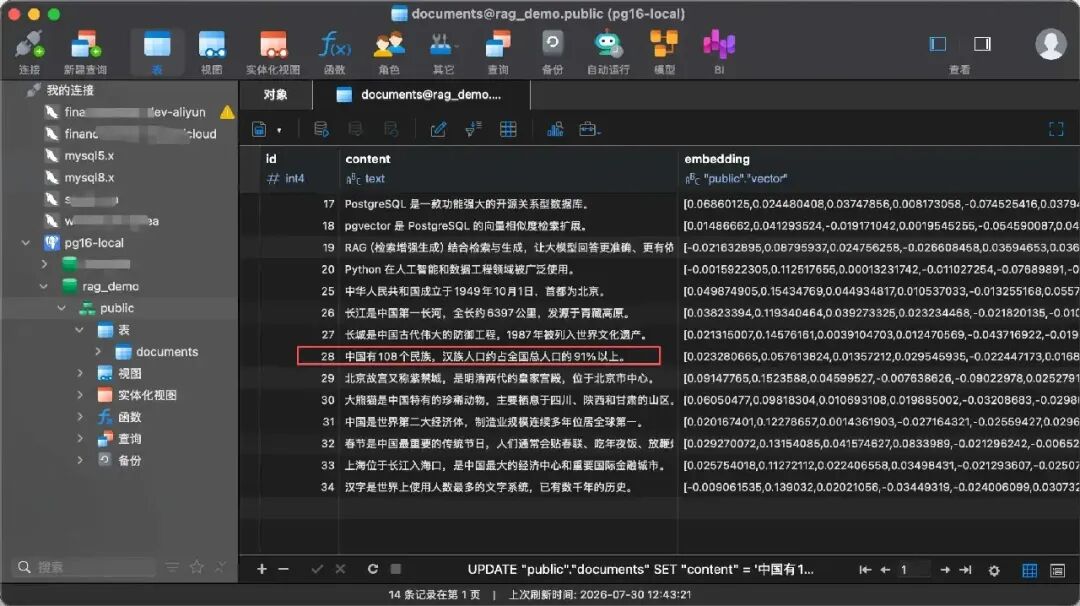
运行效果
执行 python main.py后,从输出可以看出召回成功——“根据上下文,中国有 108 个民族”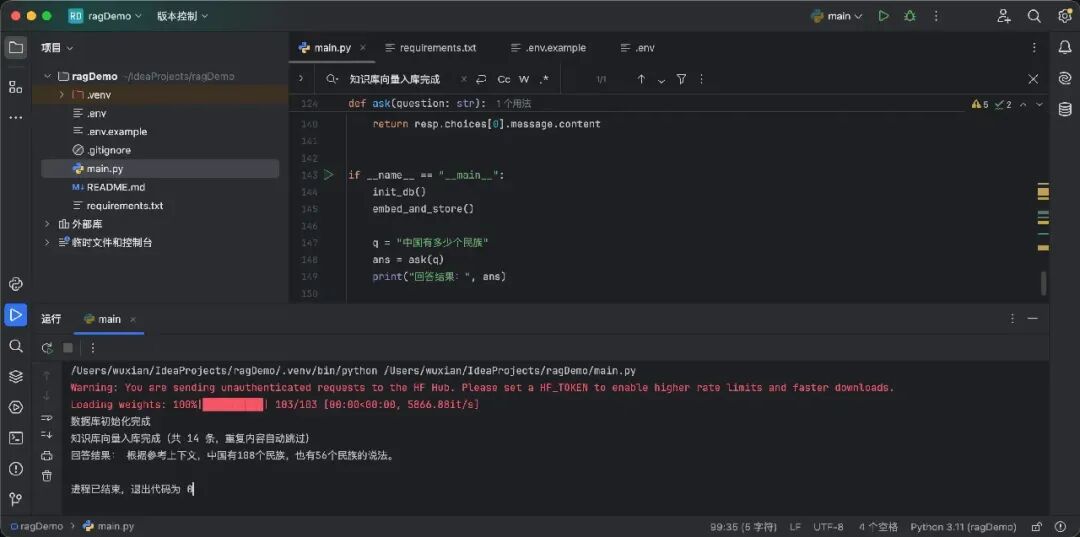
结果分析 & RAG 局限性科普
测试现象
提问:中国有多少个民族 输出大概率:根据上下文,中国有108个民族(错误答案)
原因拆解(新手必懂)
- 我们入库的知识库完全没有 “56 个民族” 这条信息;
- Prompt 约束失效,大模型脱离上下文自由发挥,产生模型幻觉。
由此总结 RAG 优缺点
✅ RAG 优势
❌ RAG 入门版明显短板
- 文本切块 (Chunk) 大小不合理会导致语义割裂、召回错误;
- 简单余弦检索容易出现噪声召回(语义字面相近但无关)。
总结
最开始我们说 RAG 不用害怕,看完整篇实操也印证了这句话:
它既没有复杂的高深算法,底层只是向量点积的高中数学;也不需要昂贵的重型基础设施,Docker 一键拉起 pgvector、写几十行 Python 代码就能实现完整能力。
这次测试里 “中国 108 个民族” 的错误回答,也给我们提了醒:RAG 只是解决大模型知识滞后、私有资料无法注入的工具,答案靠谱与否,最终决定权永远在我们自己维护的知识库手里。
如果你刚接触 AI 应用开发,完全可以从这个最小 Demo 开始动手,亲手跑一遍向量入库、相似度召回、LLM 回答全流程,就能彻底搞懂 RAG 的来龙去脉。
