适用:Linux 服务器(Rocky / RHEL / Debian / PVE),NVIDIA 显卡(RTX 3090 / 4090 / 5090)阅读时间:8 分钟|收藏用:3 个月
你有没有过这种经历:
装完驱动,nvidia-smi 出来了,但 torch.cuda.is_available() 死活是 False
装完 CUDA Toolkit,结果 nvcc 装不上、驱动又崩了
跟着网上的教程装,结果发现自己的显卡根本不支持那一套
装一遍,重启,黑屏;装一遍,又黑屏
真相是:90% 的人不需要装完整的 CUDA Toolkit。
AI 框架(PyTorch、vLLM、ComfyUI、Ollama…)的官方 wheel 包已经把 CUDA Runtime 和 cuDNN 静态打包进去了。你只需要系统层面的 NVIDIA 驱动,剩下全部交给 pip。
这篇文章我尽量讲清楚三件事:
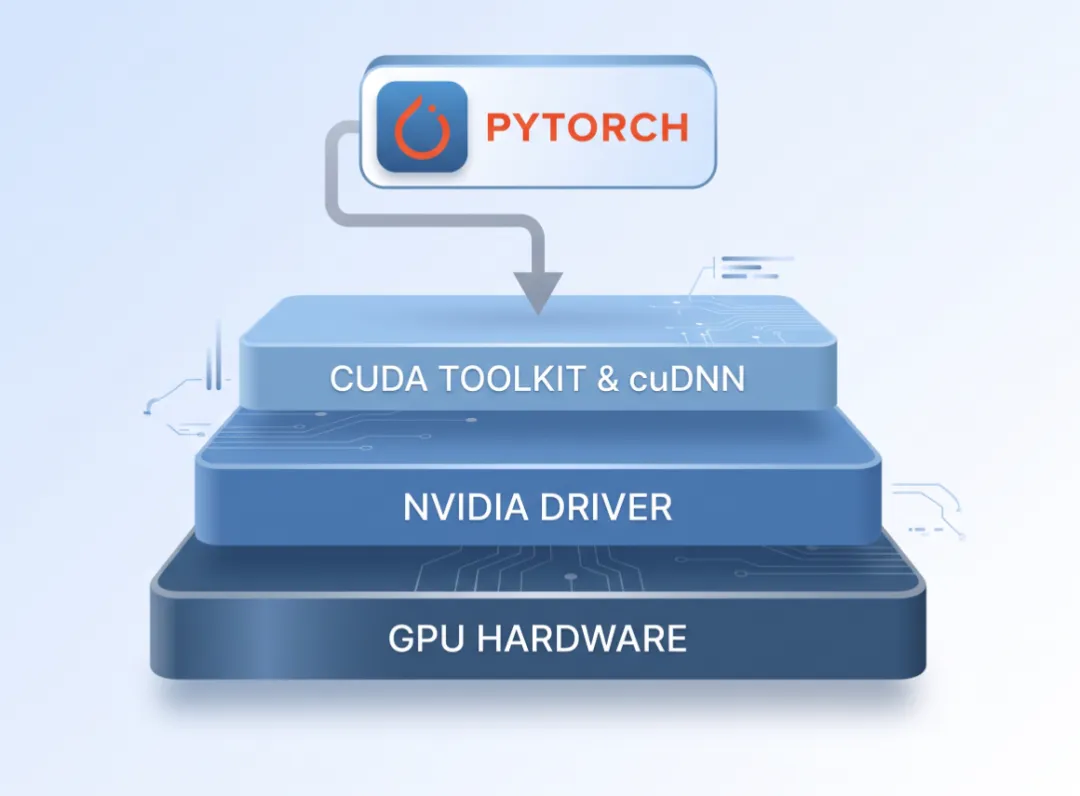
驱动 / CUDA Toolkit / cuDNN 到底是什么关系(一张图看懂)
开源驱动 vs 闭源驱动怎么选(看显卡架构,不看心情)
5 种典型场景的标准动作(直接抄作业)
一、先把三个概念搞清楚
| 组件 | 它干嘛的 | 一定要装吗 |
|---|
| NVIDIA 驱动 | 内核模块 + 用户态驱动,让系统识别 GPU,nvidia-smi 能出信息 | ✅ 必需 |
CUDA Toolkit(nvcc + libcudart) | 编译 CUDA 代码、提供 Runtime | ❌ 看你写不写 .cu |
| cuDNN | 深度学习卷积 / RNN 加速库 | ❌ 看你写不写 C++ 深度学习 |
💡 关键认知:现代 AI 框架 wheel 自带 CUDA + cuDNN,只依赖系统驱动。
所以先只装驱动,跑起来再说。报错了再加。
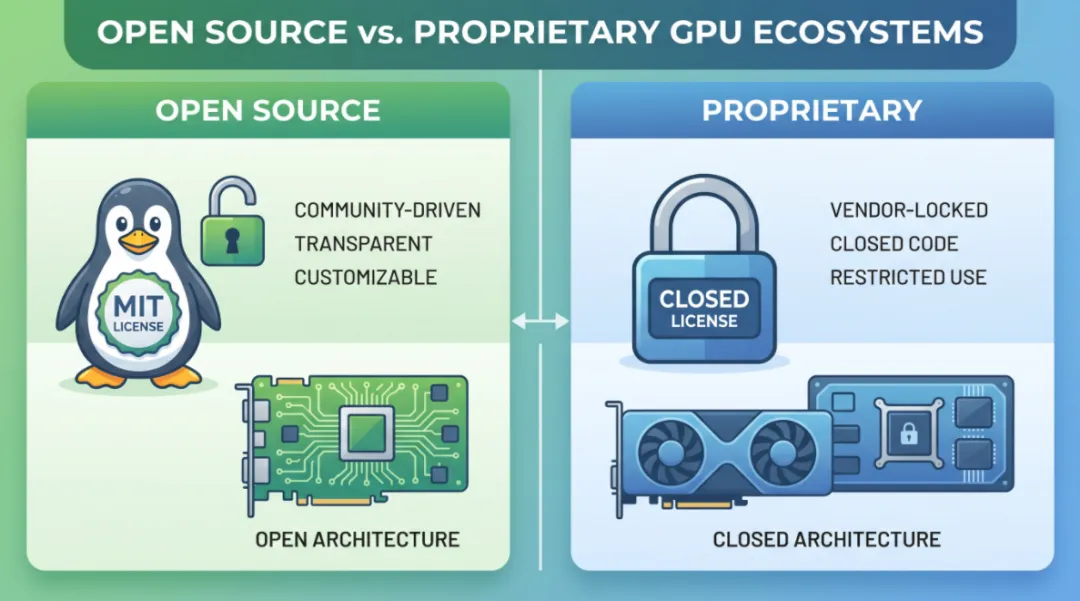
二、开源 vs 闭源驱动,这是最大的坑
网上教程一半让你装 nvidia-driver,一半让你装 nvidia-open,谁都没告诉你怎么选。我先把几个误区拆掉:
误区 1:"开源驱动性能差"
错。Turing 架构(20 系)以后,开源和闭源性能一致。Ampere(30 系)官方就推荐开源。
误区 2:"Nouveau 也是 NVIDIA 驱动,能不能用?"
不能。 Nouveau 是社区反向工程,跑不了 CUDA。装 NVIDIA 驱动前必须先禁掉 Nouveau。
误区 3:"我装老版本驱动更稳定"
错。新卡必须用新驱动。4090 / 5090 只能用开源 KMD,闭源 KMD 已经被 NVIDIA 砍了。
正确的选择方法:看显卡架构
| GPU 架构 | 代表显卡 | 怎么选 |
|---|
| Blackwell(50 系) | RTX 5090 / 5080 | ✅ 必须开源 KMD |
| Ada(40 系) | RTX 4090 / 4080 | ✅ 必须开源 KMD |
| Ampere(30 系) | RTX 3090 / 3080 / A100 | ✅ 推荐开源 KMD |
| Turing(20 系) | RTX 2080 / T4 | ✅ 推荐开源 KMD |
| Volta / Pascal(10 系) | GTX 1080 / V100 | ❌ 必须闭源 KMD |
| Maxwell / Kepler 更早 | GTX 900 / 700 | ❌ legacy 闭源 |
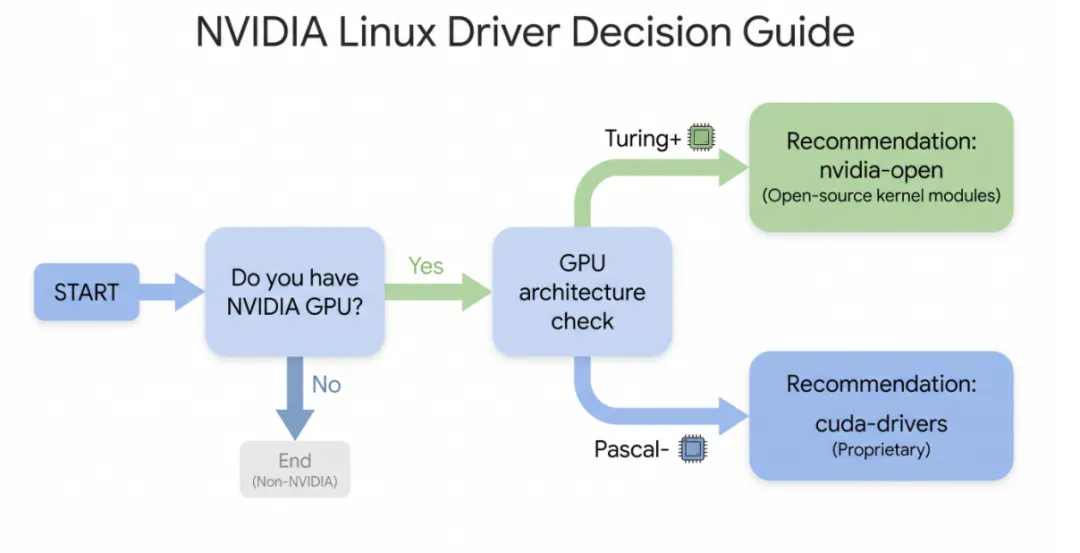
🎯 记住一句话:Turing 及以上用 nvidia-open,Pascal 及以下用 cuda-drivers。
| 维度 | 开源 nvidia-open | 闭源 cuda-drivers |
|---|
| 内核模块许可证 | MIT/GPL 开源 | 闭源 |
| AI 训练性能 | ✅ 与闭源一致 | ✅ 与开源一致 |
| Secure Boot 签名 | ✅ 方便 | ⚠️ 需 MOK 注册 |
| 老卡兼容(Pascal-) | ❌ | ✅ |
| 新卡必须(Ada/Blackwell) | ✅ | ❌ |
| Rocky/RHEL 包名 | nvidia-open | cuda-drivers |
| Debian/PVE 包名 | nvidia-open-kernel-dkms | nvidia-driver |
三、装之前先看这张决策树
你需要 NVIDIA 驱动吗?└─ 是 → 看显卡架构 ├─ Turing+(20/30/40/50 系)→ 装 nvidia-open └─ Pascal/Volta 及更早 → 装 cuda-drivers装完驱动,还需要系统级 CUDA Toolkit 吗?├─ 只跑现成模型(PyTorch wheel) → 不需要└─ 编译自定义 CUDA 算子 → 装 cuda-toolkit(注意:不是 cuda)还需要系统级 cuDNN 吗?├─ 用 PyTorch / TF 官方 wheel → 不需要└─ 写 C++ CNN → 装 libcudnn9
四、5 个场景的标准动作
场景 A:纯 AI 训练 / 推理(90% 的人走这条)
代表用途:PyTorch 训练、vLLM 推理、ComfyUI 画图、Ollama 跑 LLM
装什么:只装驱动。不装系统 CUDA,不装系统 cuDNN。
完整流程(Rocky 10 / RHEL 10):
# 1. 关掉图形桌面systemctl isolate multi-user.targetsystemctl set-default multi-user.targetsystemctl disable --now gdm 2>/dev/null# 2. 禁用 Nouveau(必须)cat > /etc/modprobe.d/blacklist-nouveau.conf <<'EOF'blacklist nouveauoptions nouveau modeset=0EOFgrubby --args="rd.driver.blacklist=nouveau nouveau.modeset=0"--update-kernel=ALLdracut --forcereboot# 3. 装编译依赖 + 加 NVIDIA CUDA repodnf install -y epel-releasednf config-manager --set-enabled crbdnf install -y dkms kernel-devel-matched kernel-headers gccmakednf config-manager --add-repo https://developer.download.nvidia.com/compute/cuda/repos/rhel10/$(uname -m)/cuda-rhel10.repodnf clean expire-cache# 4. 装开源驱动dnf install -y nvidia-openreboot# 5. 验证驱动nvidia-smi # 看到 GPU 型号 + 显存即可# 6. 装 AI 框架(wheel 自带 CUDA + cuDNN)python -m venv ai && source ai/bin/activatepip install torch torchvision --index-url https://download.pytorch.org/whl/cu128# 7. 验证 GPUpython -c"import torch; print(torch.cuda.is_available(), torch.backends.cudnn.is_available())"# 输出 True True → 收工
🎯 环境干净、不污染系统、多版本框架互不干扰。
场景 B:写 / 编译自定义 CUDA 算子
代表用途:写 .cu kernel、编译 detectron2 / mmcv / xformers 源码、旧版 TF 1.x
装什么:驱动 + 只装cuda-toolkit(不要装 cuda 这个 meta 包,会拉闭源驱动冲突)
# 1~4 同场景 A# 5. 只装 CUDA Toolkitdnf install -y cuda-toolkit# 6. 配置环境变量echo'export PATH=/usr/local/cuda/bin:$PATHexportLD_LIBRARY_PATH=/usr/local/cuda/lib64:$LD_LIBRARY_PATH' >> ~/.bashrcsource ~/.bashrc# 7. 验证nvcc --version
⚠️ 易踩坑:dnf install cuda 会拉闭源 cuda-drivers,和 nvidia-open 冲突。永远只装 cuda-toolkit。
场景 C:C++ 深度学习开发(要系统级 cuDNN)
# 驱动 + CUDA Toolkit 同场景 Bdnf install -y nvidia-open cuda-toolkit && reboot# 装系统级 cuDNNdnf install -y libcudnn9 libcudnn9-devel# 验证cat /usr/include/cudnn_version.h | grep CUDNN_MAJOR
单纯 Python 框架用户跳过此场景。
场景 D:Docker 容器跑训练
宿主机只需要:驱动 + NVIDIA Container Toolkit
dnf install -y nvidia-open nvidia-container-toolkitnvidia-ctk runtime configure --runtime=dockersystemctl restart docker# 验证docker run --gpus all pytorch/pytorch:latest nvidia-smi
容器镜像(pytorch/pytorch、nvcr.io/nvidia/pytorch)自带 CUDA + cuDNN,宿主完全不用管。
场景 E:老显卡(10 系 / V100)必须用闭源驱动
# 1~3 同场景 A# 4. 装闭源驱动dnf install -y cuda-driversreboot# 5. 验证nvidia-smi# 后续 AI 框架安装同场景 A 步骤 6~7
💡 报 dkms >= 3.1.8 needed?说明 EPEL 没开:
dnf install -y epel-releasednf config-manager --set-enabled crbdnf install -y dkms kernel-devel-matched
五、装之前必做的 5 件事
任何场景都需要先做这些:
1. 关图形桌面
systemctl isolate multi-user.targetsystemctl set-default multi-user.target
2. 禁 Nouveau(必须)
cat > /etc/modprobe.d/blacklist-nouveau.conf <<'EOF'blacklist nouveauoptions nouveau modeset=0EOFgrubby --args="rd.driver.blacklist=nouveau nouveau.modeset=0" --update-kernel=ALLdracut --forcereboot
验证:lsmod | grep nouveau 无输出。
3. 装编译依赖
dnf install -y epel-releasednf config-manager --set-enabled crbdnf install -y dkms kernel-devel-matched kernel-headers gcc make
4. 确认内核头文件匹配
uname -rrpm -q kernel-devel # 版本必须一致,否则 DKMS 编译失败
不一致就先 dnf update kernel && reboot。
5. 加 NVIDIA CUDA repo
dnf config-manager --add-repo https://developer.download.nvidia.com/compute/cuda/repos/rhel10/$(uname -m)/cuda-rhel10.repodnf clean expire-cachednf search nvidia-open # 验证能看到包
六、装不上?试试官方 .run 兜底
DNF/RPM 失败(网络不通 / 依赖地狱)时,用官方 .run 文件:
# 开源驱动bash NVIDIA-Linux-x86_64-*.run --kernel-module-type=open# 闭源驱动bash NVIDIA-Linux-x86_64-*.run
常用参数:
| 参数 | 作用 |
|---|
--kernel-module-type=open | 装开源内核模块 |
--dkms | 注册 DKMS,内核升级自动重编 |
--no-opengl-files | 不装 OpenGL(无桌面推荐) |
--disable-nouveau-check | 跳过 Nouveau 检查(已禁可加) |
--silent | 静默安装 |
七、验证命令速查
# 驱动层nvidia-smi # 驱动是否工作modinfo nvidia | grep -i open # 看是 open 还是 proprietary KMDlsmod | grep nouveau # 应为空lsmod | grep nvidia # nvidia 模块是否加载# CUDA Toolkitnvcc --version # 系统 CUDA 是否装# PyTorch 内置 CUDA/cuDNNpython -c "import torch; print(torch.version.cuda)"python -c "import torch; print(torch.backends.cudnn.version())"python -c "import torch; print(torch.cuda.is_available())"python -c "import torch; print(torch.cuda.get_device_name(0))"# 包管理查询rpm -qa | grep -i nvidiarpm -qa | grep -i cudarpm -qa | grep -i cudnn
八、故障排查速查
| 问题 | 原因 | 解决 |
|---|
nvidia-smi 报 NVIDIA-SMI has failed | 驱动没加载 / Nouveau 没禁干净 | lsmod \| grep nouveau 应为空;重装驱动 |
dkms >= 3.1.8 needed | EPEL 没开 | dnf install epel-release && dnf config-manager --set-enabled crb |
nvidia-open: No match | NVIDIA CUDA repo 没加 | 重新加 repo |
装完驱动 nvidia-smi 黑屏 | Secure Boot 阻止 | BIOS 关 Secure Boot,或 mokutil 签模块 |
kernel-devel 版本不匹配 | 内核更新没重启 | 对齐 uname -r 后重装 |
cuda.is_available()=False | 装了 CPU 版 torch | 用 --index-url https://download.pytorch.org/whl/cu128 重装 |
nvcc: command not found 但驱动正常 | 没装 CUDA Toolkit | dnf install cuda-toolkit |
九、总结
| 你在做什么 | 装什么 | 驱动选哪个? |
|---|
| 只跑 AI 模型 | 只装驱动 + pip 装框架 | Turing+ → nvidia-open;Pascal- → cuda-drivers |
| 写 / 编译 CUDA 代码 | 驱动 + cuda-toolkit | 同上,不要装cuda-drivers |
| C++ 深度学习 | 驱动 + cuda-toolkit + libcudnn9 | 同上 |
| Docker 跑 AI | 驱动 + nvidia-container-toolkit | 同上,容器自带 |
| 老卡(10 系 / V100) | 闭源驱动 + pip 装框架 | 必须cuda-drivers |
🎯 黄金四原则:
先看显卡架构决定开源还是闭源
先只装驱动,用 pip/conda 装框架试跑
只有报错明确说"找不到 CUDA / nvcc / libcudnn"时,再按需追加
这样系统最干净、冲突最少
📌 收藏这一篇,下次装新机器直接照着抄。
如果觉得有用,转发给身边那个"装驱动装到崩溃"的朋友吧~
你装驱动踩过最离谱的坑是什么?评论区聊聊 👇
 10个月宝宝每天需要喝多少奶粉?