Python绘制相关性分析网络图
- 2026-10-11 06:17:06
Python绘制相关性分析网络图
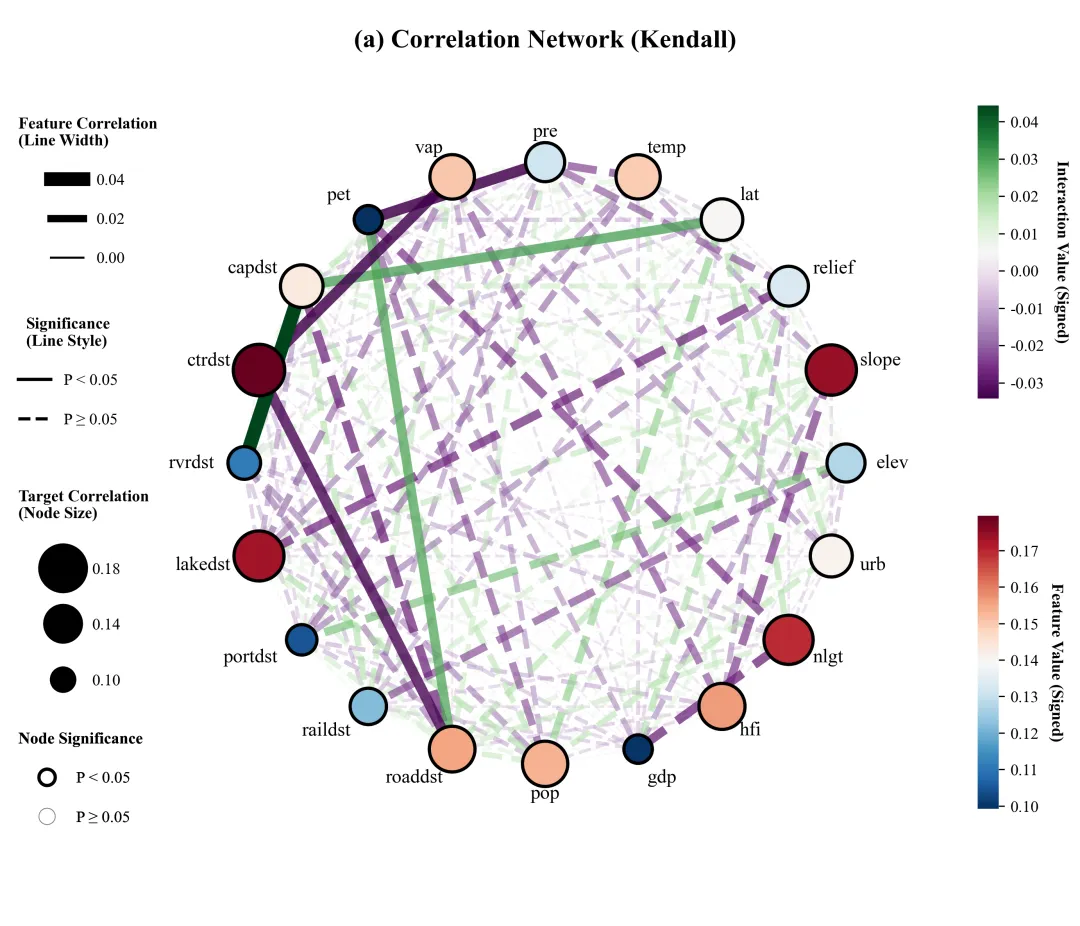
kendall分析结果图 这张图展示了特征变量与目标之间以及特征相互之间的线性相关关系。在环形网络中,节点的大小直观反映了各特征与目标变量的相关性强度;节点的颜色反映了相关系数的数值,而节点边框的粗细以及颜色代表了显著性分析的结果,粗黑色边框的节点代表其与目标具有统计显著性,细灰边框的节点则未达到显著水平。连线的线型表示了二者之间是否存在显著性,连线的粗细则是反映了相关性的强度,网络连线的颜色表示了实际相关性数值。 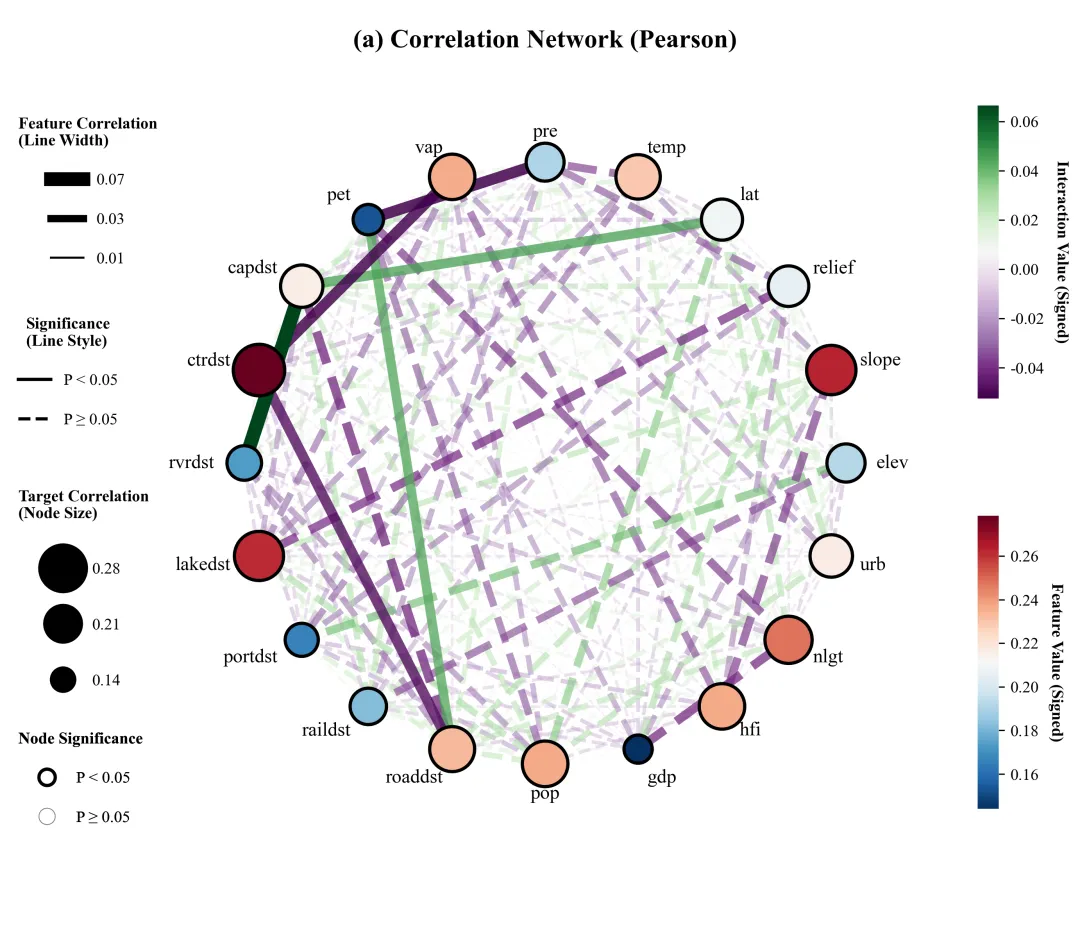
pearson分析结果图 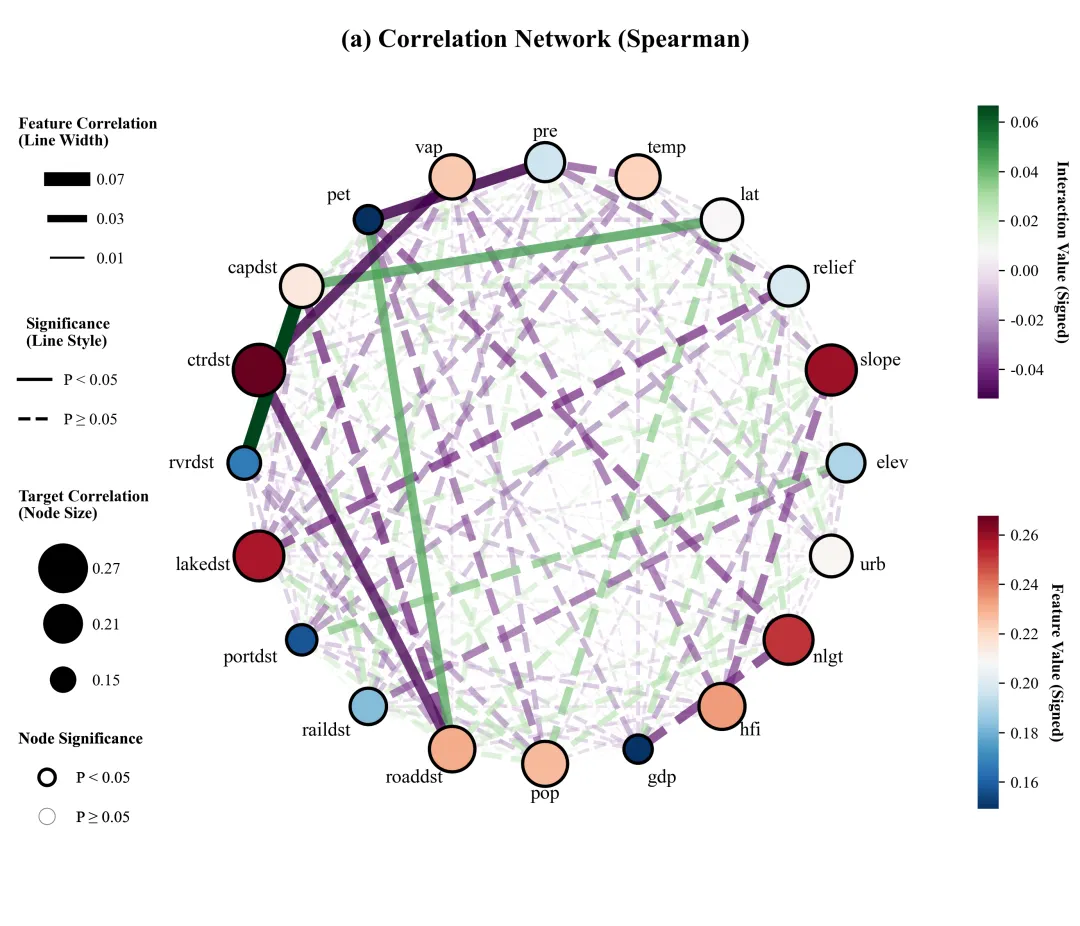
spearman分析结果图 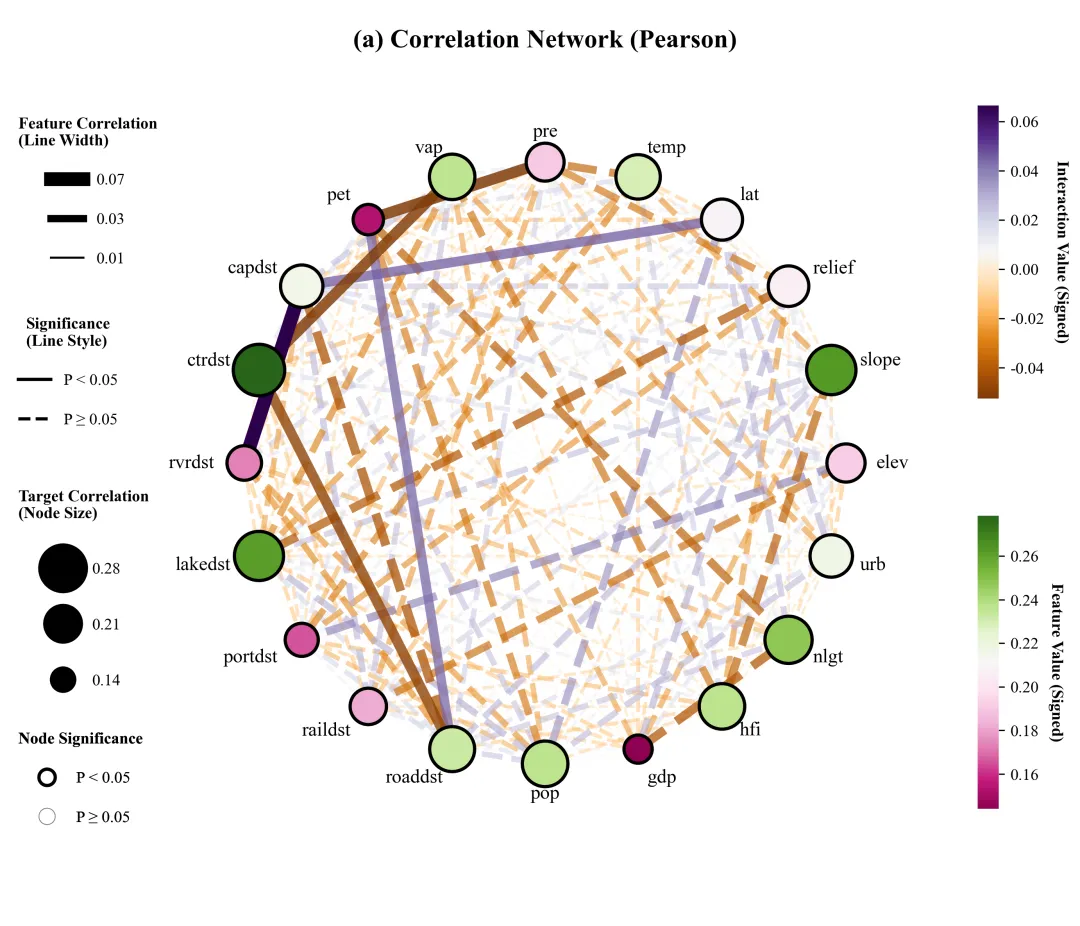
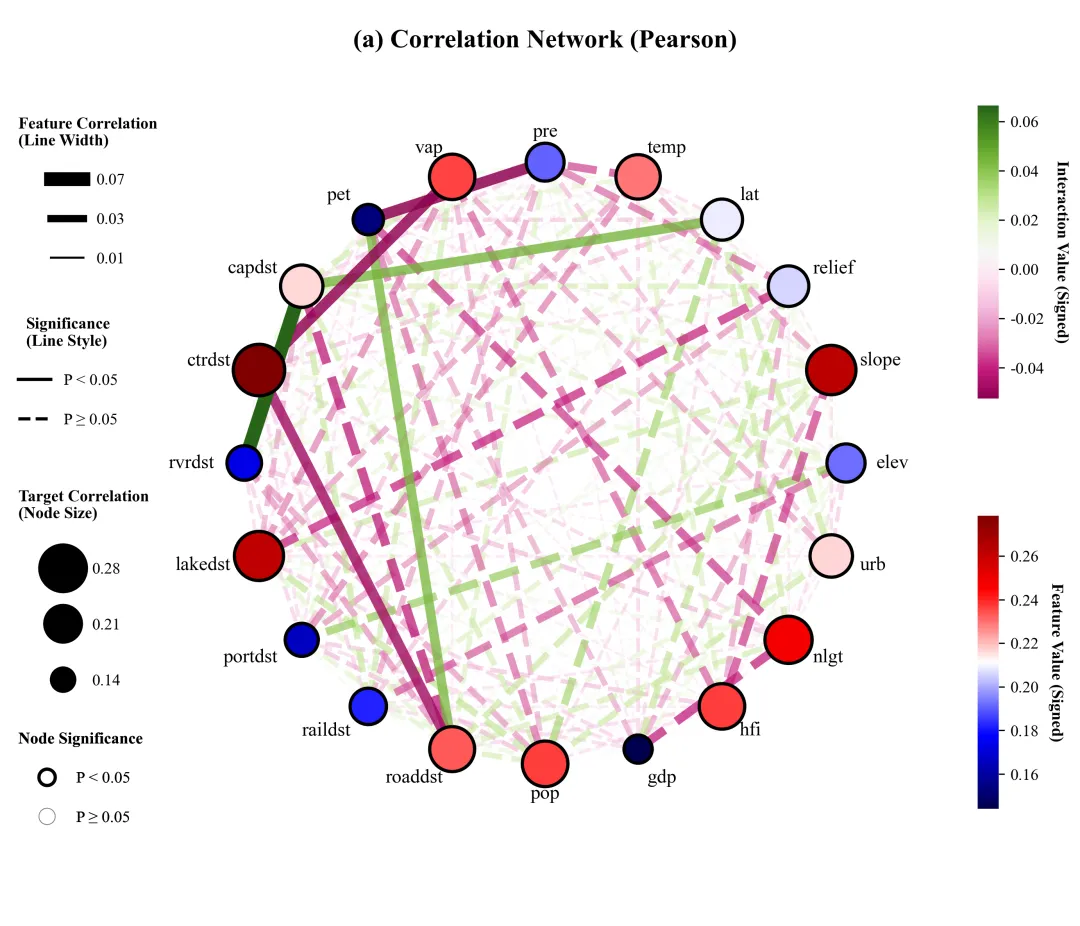
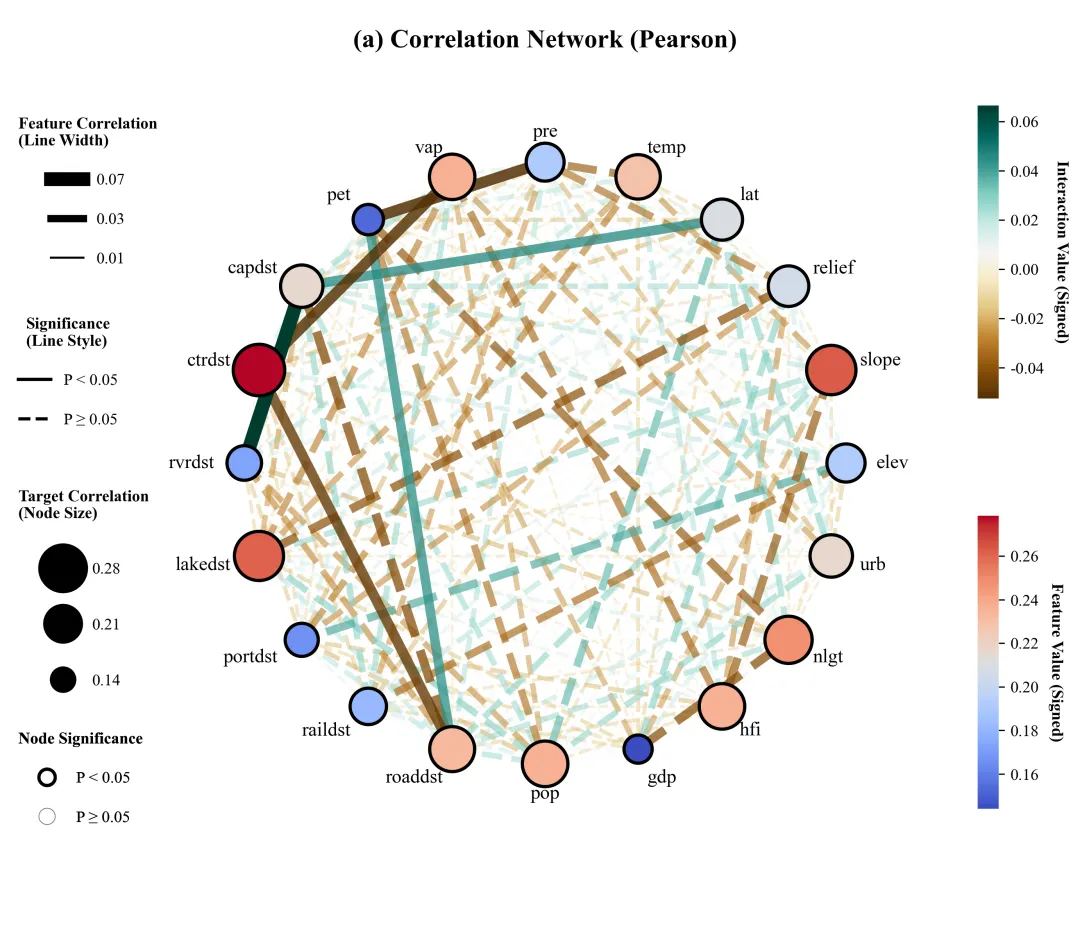
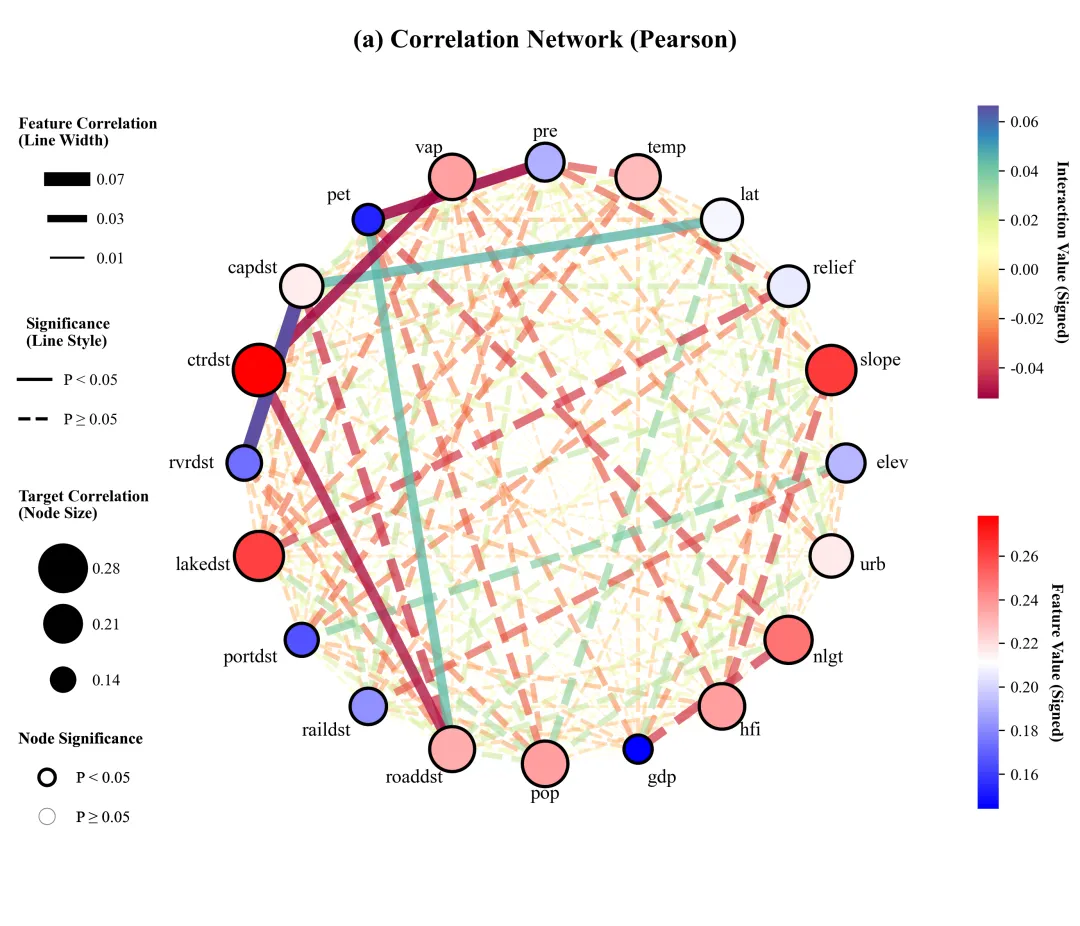
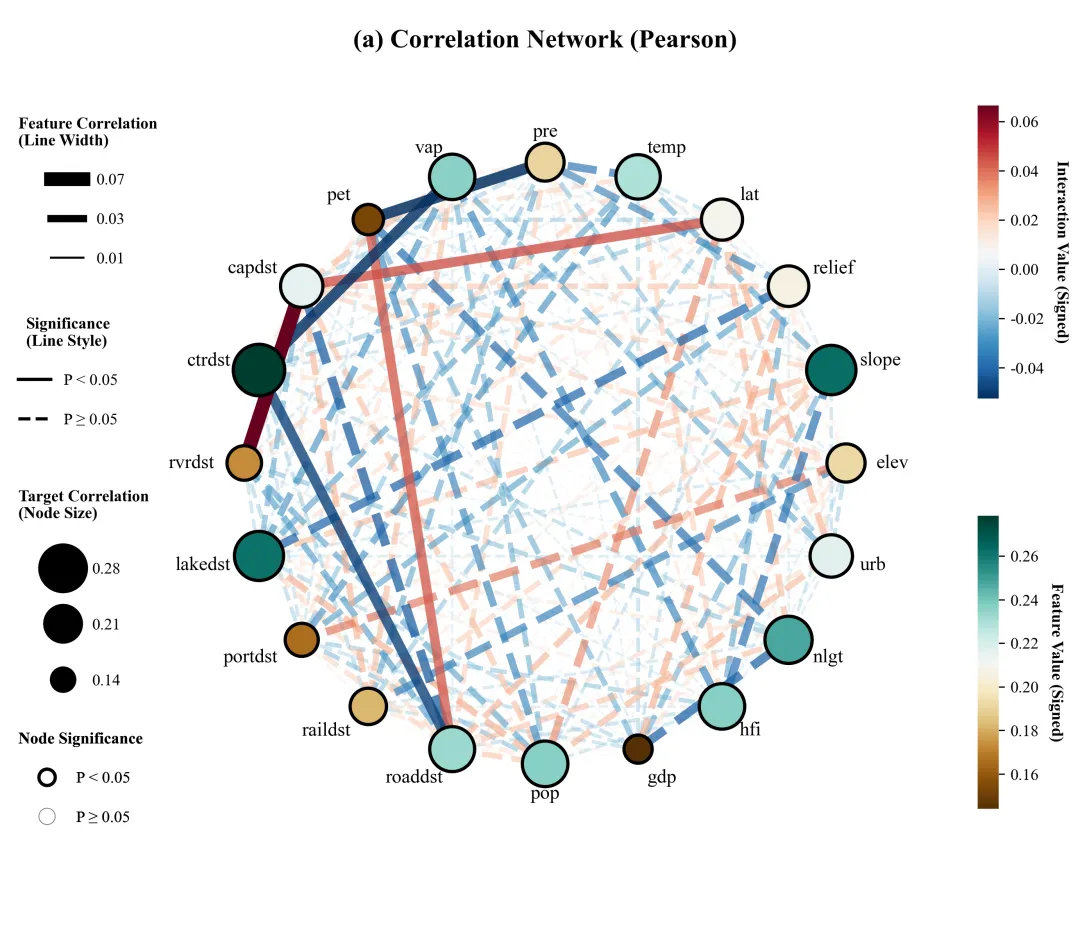
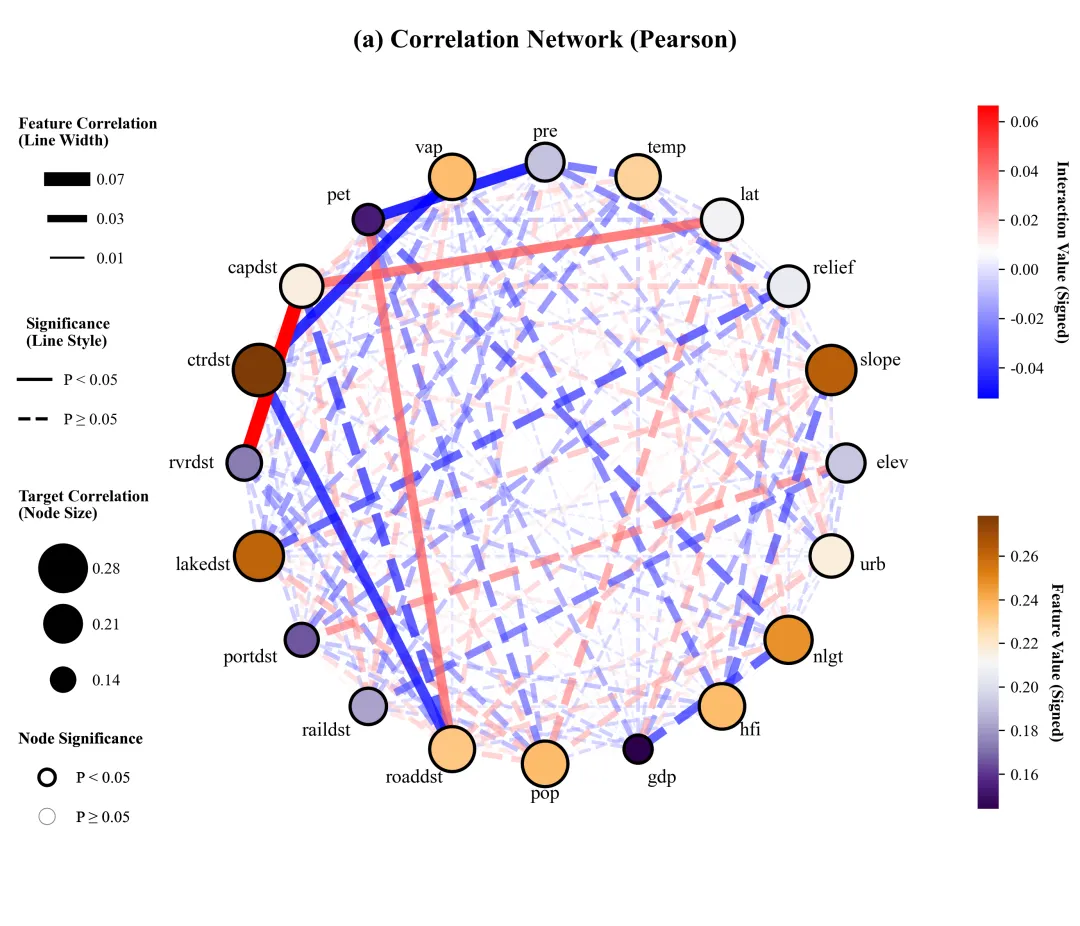
多种颜色方案 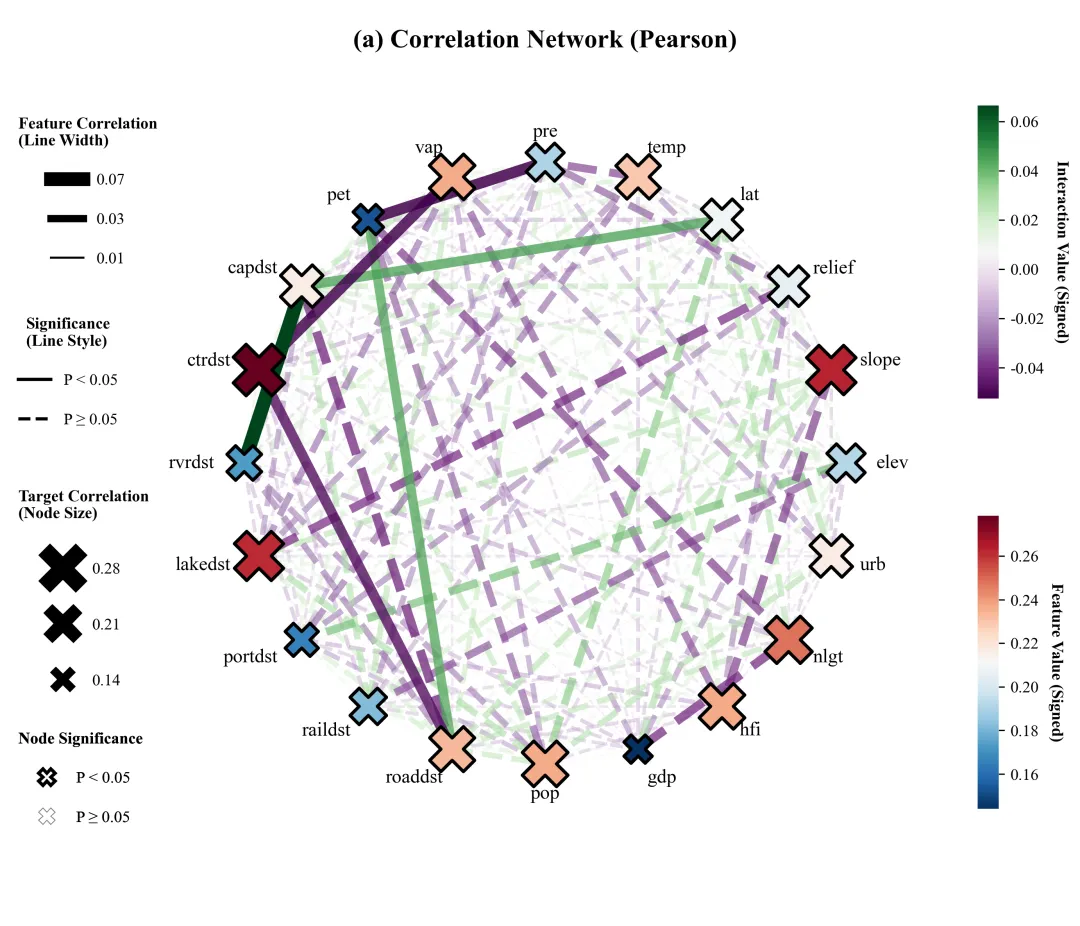
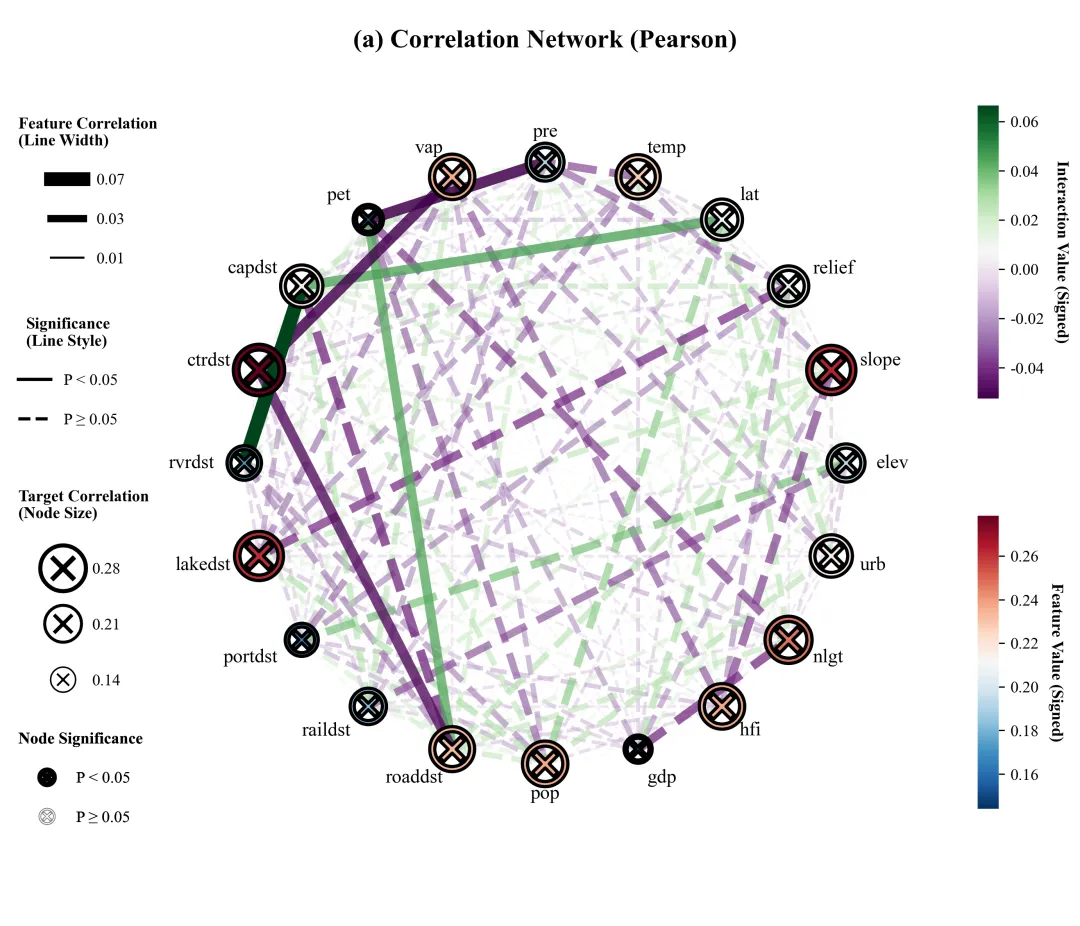
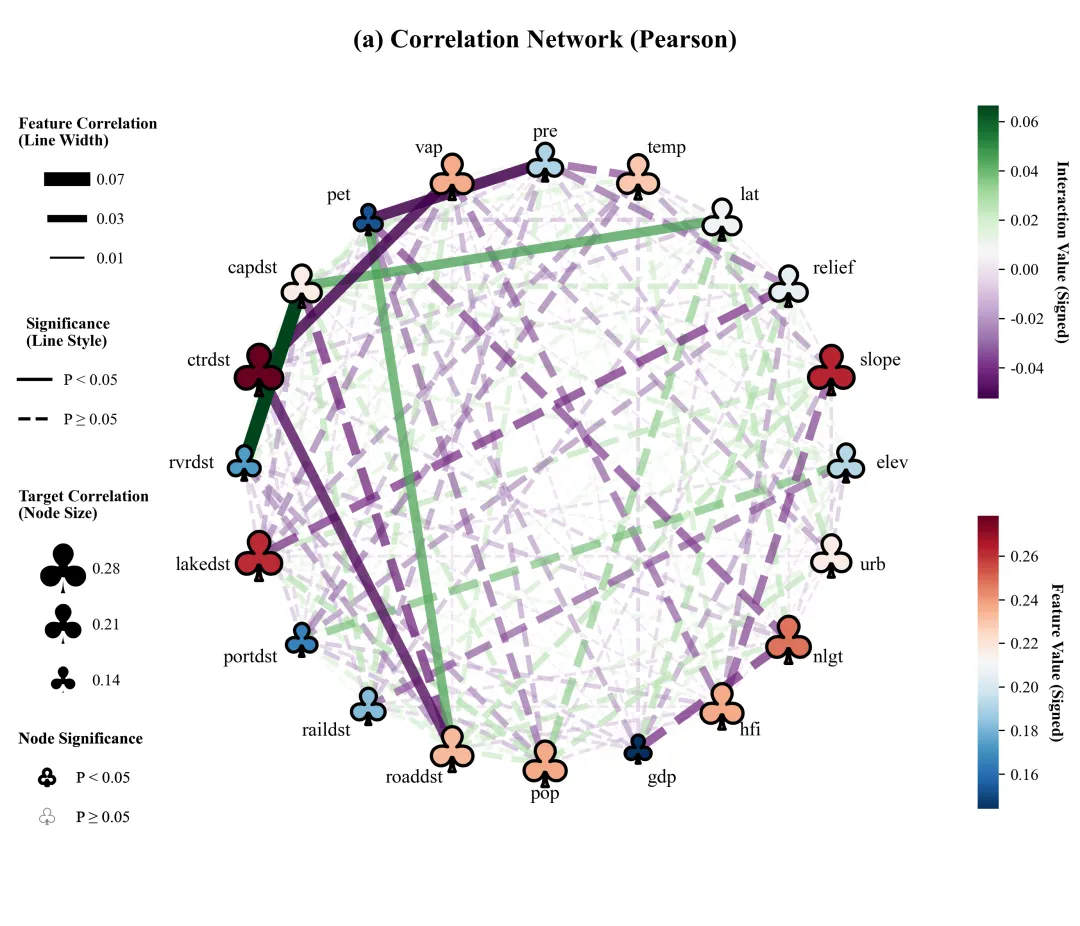
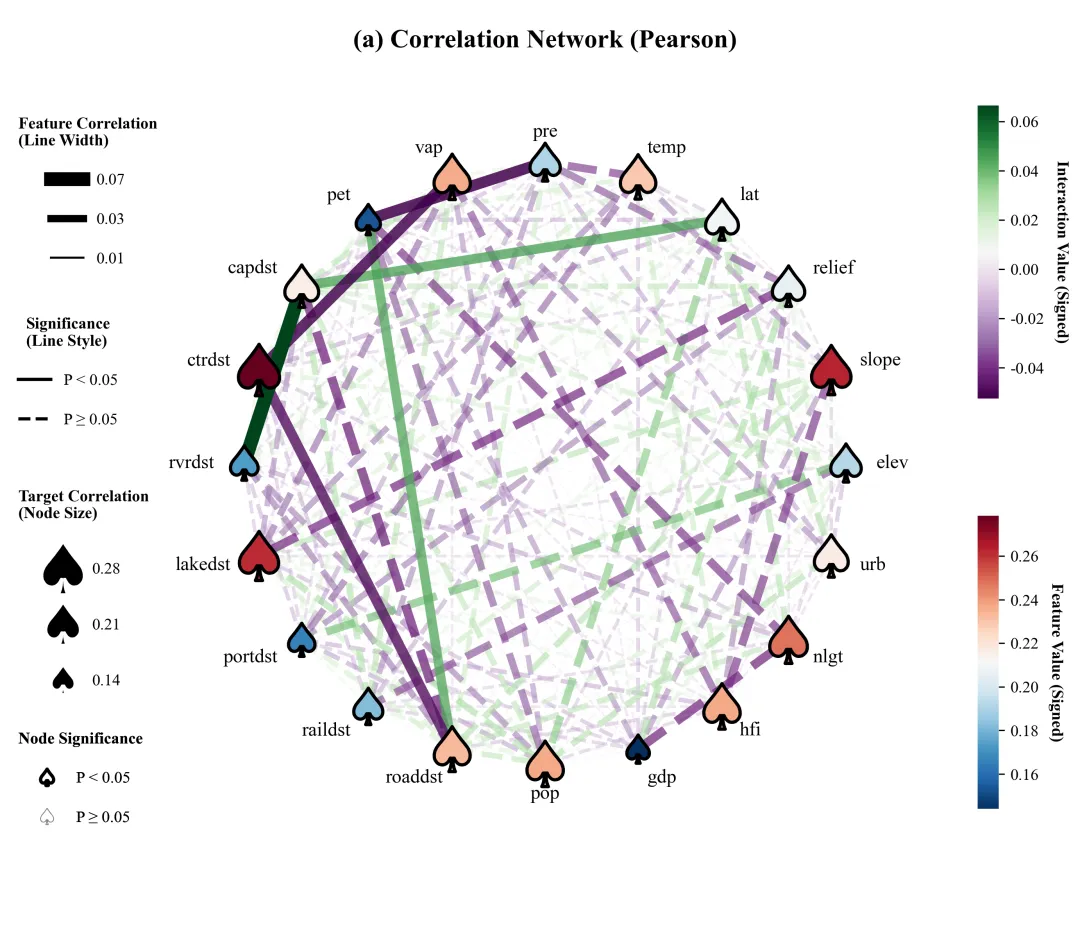
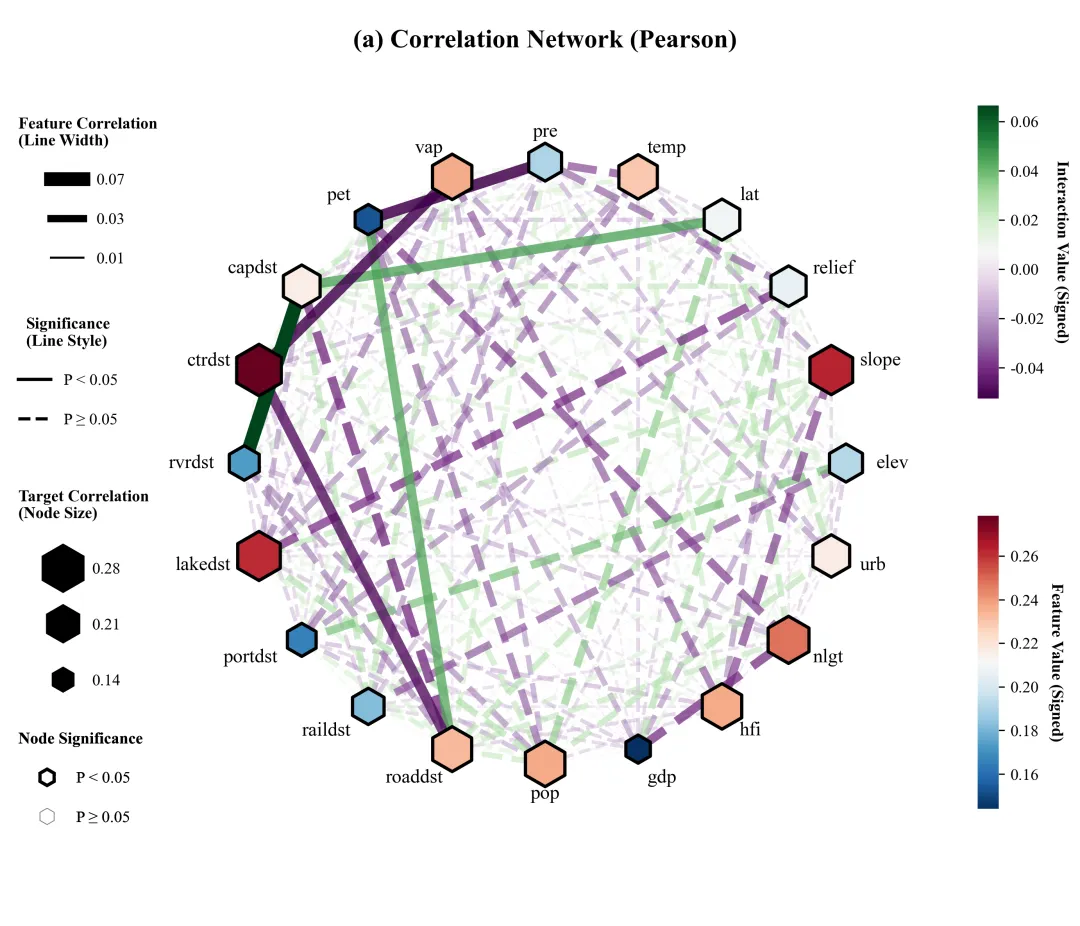
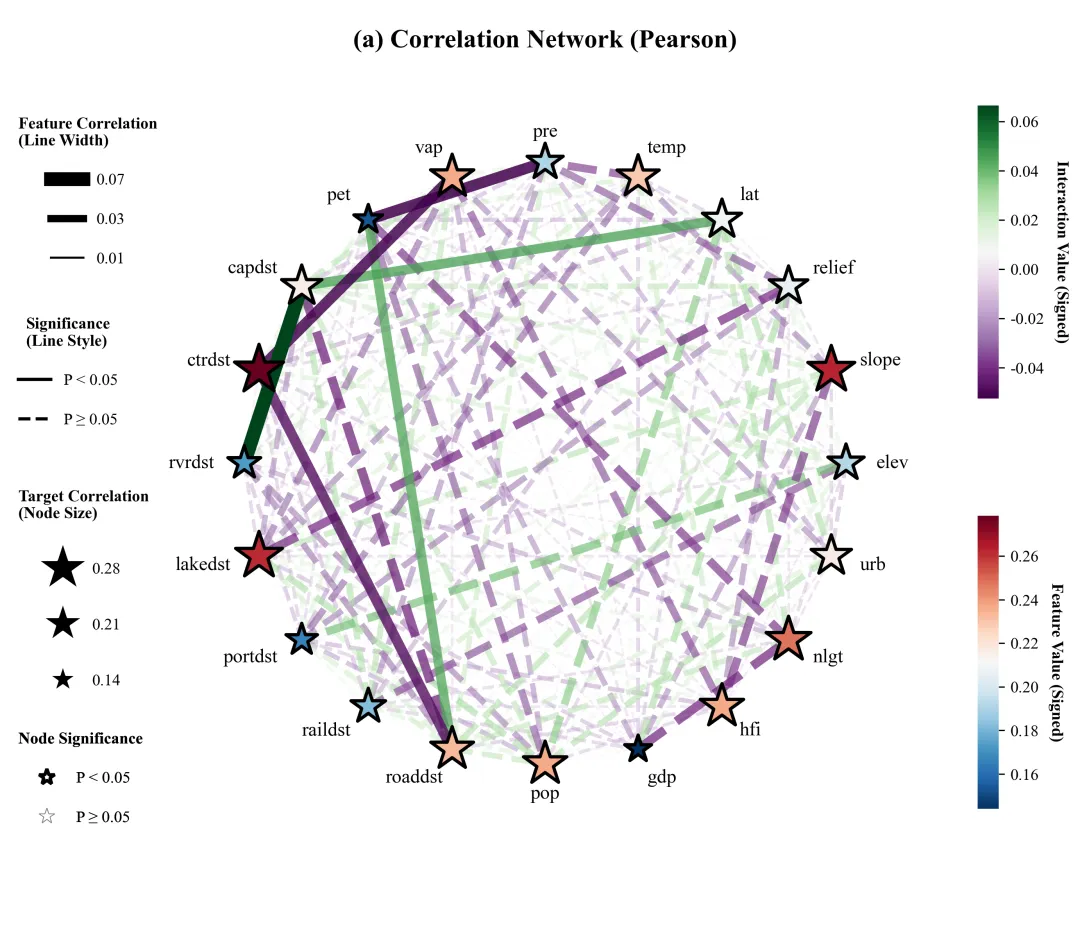
多种形状标记方案 
库的导入以及字体设置 
颜色库的设置以及配色方案的选择 
形状标记库的设置以及配色方案的选择 
数据的读取以及目标变量与特征变量的分离 
相关性分析方法库的设置以及相关性分析方法的选择 
计算特征与目标、特征与特征之间的相关系数和 P 值 
函数定义与基础设置,获取颜色方案、形状标记方案、创建画布 
构建网络图与布局 
获取特征之间的相关系数、显著性,设置颜色归一化,准备绘制网络线 
绘制特征变量之间的网络线,根据相关系数来设置线的粗细,根据显著性分析结果来设置线型 
设置节点的大小的映射逻辑 
绘制节点,根据相关系数的大小排序设置点的大小,点的颜色,根据显著性来设置节点的边框粗细 
绘制节点位置的特征名称标注,绘制标题 
绘制图例 
绘制颜色条及绘图结果保存 
执行部分,打印分析结果,调用绘图函数进行绘图 
期刊图片复现|Python绘制二维偏依赖PDP图 期刊复现|python绘制基于SHAP分析和GAM模型拟合的单特征依赖图 期刊图片复现|python绘制带有渐变颜色shap特征重要性组合图(条形图+蜂巢图) 期刊复现|用Python绘制SHAP特征重要性总览图、依赖图、双特征交互效应SHAP图,解锁XGBoost模型的终极奥秘 期刊图片复现|Python绘制shap重要性蜂巢图+单特征依赖图+交互效应强度气泡图+交互效应依赖图(回归+二分类+分类) 
需要的请后台私信我,注意只会分享练习数据和代码文件,不会提供答疑服务,代码文件中已经包含了每行代码的完整注释!!!
代码绘制成果展示
代码解释
第一部分
# =========================================================================================# ====================================== 1. 环境设置 =======================================# =========================================================================================import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport matplotlib.colors as mcolorsimport networkx as nximport warningsfrom matplotlib.lines import Line2Dfrom scipy.stats import pearsonr, spearmanr, kendalltauimport matplotlibmatplotlib.rcParams['pdf.fonttype'] = 42matplotlib.rcParams['ps.fonttype'] = 42plt.rcParams['font.family'] = 'serif'plt.rcParams['font.serif'] = ['Times New Roman']plt.rcParams['axes.unicode_minus'] = False
第二部分
# =========================================================================================# ======================================2.颜色库=======================================# =========================================================================================COLOR_SCHEMES = {1: {'nodes': plt.cm.RdBu_r, 'edges': plt.cm.PRGn},}scheme_index =1 # 颜色方案选择# 获取当前颜色方案current_color_scheme = COLOR_SCHEMES.get(scheme_index, COLOR_SCHEMES[1])
第三部分
# =========================================================================================# ======================================3.形状标记库=======================================# =========================================================================================STYLE_SCHEMES = {1: {'marker': 'o'},}style_index = 1 # 形状标记方案# 获取样式方案current_style_scheme = STYLE_SCHEMES.get(style_index, STYLE_SCHEMES[1])
第四部分
# =========================================================================================# ======================================4.数据加载=======================================# =========================================================================================# 原始数据路径file_path = r'mock_data.xlsx'# 读取数据df = pd.read_excel(file_path)# 目标变量y = df.iloc[:, -1]# 特征变量X = df.iloc[:, :-1]# 获取特征列的名称并转换为列表features = X.columns.tolist()print(f"特征: {features}")print(f"数据类型: {X.shape}")
第五部分
# =========================================================================================# ======================================5.相关性分析设置====================================# =========================================================================================# 相关性分析方法CORRELATION_METHODS = {1: 'pearson', # 皮尔逊2: 'spearman', # 斯皮尔曼3: 'kendall' # 肯德尔}# 设置使用的分析方法method_index = 3selected_method_name = CORRELATION_METHODS.get(method_index, 'pearson')#获取分析方案print(f"当前使用的相关性分析方法: {selected_method_name.capitalize()}")
第六部分
# =========================================================================================# ======================================6.相关性及P值计算===================================# =========================================================================================def calculate_corr_p(x, y, method):if method == 'pearson': #判断使用的是什么方法return pearsonr(x, y) #使用对应方法计算并返回 x 和 y 的相关系数与 p 值elif method == 'spearman':return spearmanr(x, y)elif method == 'kendall':return kendalltau(x, y)else:return pearsonr(x, y)correlations_target_list = [] #用于存储每个特征与目标变量之间的相关系数p_target_list = [] #用于存储每个特征与目标变量之间的 P 值for col in features: #遍历特征列表中的每一个特征列名r, p = calculate_corr_p(X[col], y, selected_method_name) # 调用函数计算当前特征与目标变量之间的相关系数和P值correlations_target_list.append(r) #添加到相关系数列表p_target_list.append(p) #添加到P值列表correlations_target_array = np.array(correlations_target_list) # 将列表转换为 NumPy 数组,以便进行后续的数值计算和绘图处理p_target_array = np.array(p_target_list) # 将 P 值列表转换为 NumPy 数组#绝对相关性 (用于节点大小)feature_importance_abs = np.abs(correlations_target_array)#相关性原始值 (用于节点颜色)feature_importance_signed = correlations_target_array#计算特征之间的两两相关性及P值n_feat = len(features)corr_matrix_values = np.zeros((n_feat, n_feat))#存放特征间分析系数#特征间相关性绝对值,共线性越强,线越粗mean_interaction_matrix_abs = np.abs(corr_matrix_values)np.fill_diagonal(mean_interaction_matrix_abs, 0) # 忽略自身相关性#特征间相关性,用于控制连线颜色mean_interaction_matrix_signed = corr_matrix_valuesnp.fill_diagonal(mean_interaction_matrix_signed, 0) # 忽略自身相关性
第七部分
def plot_circular_interaction(features, importance_abs, importance_signed,p_target,interaction_matrix_abs, interaction_matrix_signed,p_matrix):# 获取颜色方案cmap_nodes = current_color_scheme['nodes']cmap_edges = current_color_scheme['edges']# 获取节点形状标记node_marker = current_style_scheme['marker']# 创建画布fig, ax = plt.subplots(figsize=(12, 10), subplot_kw={'aspect': 'equal'})# 获取特征的数量n_features = len(features)
第八部分
# 创建一个 NetworkX 图对象G = nx.Graph()# 向图中添加节点G.add_nodes_from(features)# 生成节点的环形布局坐标pos = nx.circular_layout(G)# 标签的坐标label_pos = {k: (v * 1.1) for k, v in pos.items()}
第九部分
# 颜色归一化norm_edges = mcolors.Normalize(vmin=interaction_matrix_signed.min(),vmax=interaction_matrix_signed.max())# 宽度/大小归一化基准max_interaction_abs = np.max(interaction_matrix_abs)max_importance_abs = np.max(importance_abs)# 初始化交互列表interactions = []# 遍历特征for i in range(n_features):for j in range(i + 1, n_features):# 如果绝对强度大于 0 (显示阈值)if strength_abs > 0:# 将交互对、绝对强度、实际强度、P值添加到列表中interactions.append((features[i], features[j], strength_abs, strength_signed, p_val))# 根据绝对强度对交互列表进行排序interactions.sort(key=lambda x: x[2])
第十部分
# 遍历排序后的交互列表for u, v, strength_abs, strength_signed, p_val in interactions:# 根据实际值和当前边颜色方案获取线的颜色color = cmap_edges(norm_edges(strength_signed))# 根据绝对值计算线的粗细width = 0.5 + (strength_abs / max_interaction_abs) * 8# 线的透明度alpha = 0.3 + (strength_abs / max_interaction_abs) * 0.7# 绘制线nx.draw_networkx_edges(G,pos,edgelist=[(u, v)],width=width,edge_color=[color],style=current_linestyle,alpha=alpha, ax=ax)
第十一部分
# --- 节点的处理 ---# 节点颜色归一化norm_nodes = mcolors.Normalize(vmin=importance_signed.min(),vmax=importance_signed.max())#定义节点面积的范围NODE_SIZE_MIN = 300 #最小值,对应相关性最低NODE_SIZE_MAX = 1000 #最大值,对应相关性最高def map_size(value): #定义映射函数,用于将相关性数值线性转换到指定的节点大小范围内if data_max == data_min: return NODE_SIZE_MAX # 如果最大值等于最小值,直接返回设定的最大尺寸# 使用线性插值公式,将 value 映射到 [NODE_SIZE_MIN, NODE_SIZE_MAX] 区间return NODE_SIZE_MIN + (value - data_min) / (data_max - data_min) * (NODE_SIZE_MAX - NODE_SIZE_MIN)
第十二部分
# 初始化节点颜色列表node_colors = []# 初始化节点大小列表node_sizes = []node_edge_colors = [] #用于存储每个节点边框的颜色node_line_widths = [] #用于存储每个节点边框的线条宽度# 遍历每个特征for i, feat in enumerate(features):# 获取该特征的实际值if p_val_target < 0.05:node_edge_colors.append('black') #黑边node_line_widths.append(2.0) #加粗else:node_edge_colors.append('grey') #灰边node_line_widths.append(0.5) #细# 绘制节点nx.draw_networkx_nodes(G, #在图G中绘制节点pos, #坐标位置node_size=node_sizes, #大小node_color=node_colors, #填充颜色edgecolors=node_edge_colors, #边框颜色linewidths=node_line_widths, #边框粗细node_shape=node_marker, #形状标记ax=ax)
第十三部分
# 遍历标签位置字典for node, (x, y) in label_pos.items():ha = 'center' # 水平对齐方式# 如果 x 坐标在右侧if x > 0.1:ha = 'left' # 设置左对齐# 如果 x 坐标在左侧elif x < -0.1:ha = 'right' # 设置右对齐# 绘制标签文本plt.text(x,y,node,size=12,horizontalalignment=ha,verticalalignment='center')# 关闭坐标轴ax.axis('off')# x轴显示范围ax.set_xlim(-1.5, 1.5)# y轴显示范围ax.set_ylim(-1.5, 1.5)# 标题plt.title(f'(a) Correlation Network ({selected_method_name.capitalize()})', y=0.95, fontsize=16, weight='bold')
第十四部分
#定义线条粗细图例的等级数值line_levels = [max_interaction_abs, max_interaction_abs * 0.5, max_interaction_abs * 0.1]#将数值转换为保留两位小数的字符串标签,用于图例显示具体数值line_labels = [f"{val:.2f}" for val in line_levels]legend1 = ax.legend(legend_lines,line_labels,loc='center left',bbox_to_anchor=(-0.1, 0.8),title="Feature Correlation\n(Line Width)",title_fontproperties={'weight': 'bold'},frameon=False,labelspacing=1.5)#将第一个图例对象手动添加到坐标轴上ax.add_artist(legend1)
第十五部分
#创建边颜色的标量映射对象sm_edge = plt.cm.ScalarMappable(cmap=cmap_edges, norm=norm_edges)#设置空数组sm_edge.set_array([])#绘制线的颜色条cbar_edge = plt.colorbar(sm_edge, cax=cax_edge)#设置线的颜色条的标签cbar_edge.set_label('Interaction Value (Signed)', rotation=270, labelpad=15, fontsize=10, weight='bold')#去掉线的颜色条的轮廓线cbar_edge.outline.set_visible(False)# --- 颜色条---#节点颜色条的位置cbar_node_pos = [0.82, 0.20, 0.015, 0.25]#添加节点颜色条的轴cax_node = fig.add_axes(cbar_node_pos)#创建节点颜色的标量映射对象sm_node = plt.cm.ScalarMappable(cmap=cmap_nodes, norm=norm_nodes)extra_artists = [legend1, legend2,legend3, legend4, cax_edge, cax_node]# 保存save_path_png = fr"{style_index}_scheme{scheme_index}_corr_sig_{selected_method_name}.png"save_path_pdf = fr"{style_index}_scheme{scheme_index}_corr_sig_{selected_method_name}.pdf"plt.savefig(save_path_png, dpi=300, bbox_inches='tight', bbox_extra_artists=extra_artists)plt.savefig(save_path_pdf, bbox_inches='tight', bbox_extra_artists=extra_artists)
第十六部分
if __name__ == "__main__":print("-" * 30)print("特征与目标变量相关性排序")print("-" * 30)# 创建DataFrame对象,用于展示分析结果df_importance = pd.DataFrame({'特征': features, # 特征列'相关性 (绝对值)': feature_importance_abs, # 重要性'相关性 (原始值)': feature_importance_signed, # 影响方向'P值': p_target_array, #P值数据'显著性': ['**' if p < 0.01 else '*' if p < 0.05 else '-' for p in p_target_array] # 显著性标记})# 根据重要性进行降序排序df_importance = df_importance.sort_values(by='相关性 (绝对值)', ascending=False)print(df_importance.to_string(index=False))print("-" * 30)print("特征间共线性/相关性强度排序")print("-" * 30)# 初始化一个空列表interaction_list = []# 获取特征的总数量n_features = len(features)# 开始外层循环for i in range(n_features):# 开始内层循环for j in range(i + 1, n_features):# 获取数据strength = mean_interaction_matrix_abs[i, j]direction = mean_interaction_matrix_signed[i, j]p_val = p_value_matrix[i, j] # 获取P值# 条件判断if strength > 0:interaction_list.append({'特征 1': features[i],'特征 2': features[j],'相关性 (绝对值)': strength,'相关性 (原始值)': direction,'P值': p_val, # 记录P值'显著性': '是' if p_val < 0.05 else '否'})# 转换为DataFramedf_interactions = pd.DataFrame(interaction_list)# 如果不为空if not df_interactions.empty:# 根据相关性强度排序df_interactions = df_interactions.sort_values(by='相关性 (绝对值)', ascending=False)print(df_interactions.head(15).to_string(index=False))else:print("无显著相关性。")# 调用绘图函数,传入计算好的P值矩阵plot_circular_interaction(features,feature_importance_abs, # 节点大小依据feature_importance_signed, # 节点颜色依据p_target_array,#Y显著性决定节点边框粗细mean_interaction_matrix_abs, # 连线粗细依据mean_interaction_matrix_signed, # 连线颜色依据p_value_matrix) # P值矩阵,用于控制线型
如何应用
1.选择你想要使用到的配色方案:
scheme_index =1 # 颜色方案选择2.选择你想要使用到的形状标记方案:
style_index = 1 # 形状标记方案3.设置原始数据路径:
file_path = r'mock_data.xlsx'4.设置目标变量和特征变量:
# 目标变量y = df.iloc[:, -1]# 特征变量X = df.iloc[:, :-1]
5.设置想要使用的相关性分析方法:
# 设置使用的分析方法method_index = 3
6.设置绘图结果的保存地址:
save_path_png = fr"{style_index}_scheme{scheme_index}_corr_sig_{selected_method_name}.png"save_path_pdf = fr"{style_index}_scheme{scheme_index}_corr_sig_{selected_method_name}.pdf"
推荐
获取方式
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
