AI Agent长期记忆人格建模工具调用
很多 AI Agent 项目一开始都很好做:接一个大模型,挂几个工具,再补一个聊天界面,系统就能跑起来。但如果目标从"完成一轮任务"变成"长期陪伴用户",问题就会立刻变复杂。
用户会自然期待它记得昨天聊过的事,期待它的说话方式前后一致,也期待它不只是给建议,而是真的能帮忙做点事。到了这一步,系统的重点就不再只是生成文本,而是要同时处理三件事:人格、记忆和工具。
💡 核心链路:用户输入 → Agent 编排层(人格层 + 记忆层 + 工具层 + LLM 运行时)→ 人格化回复 → 写回长期记忆。真正决定体验的,不是某一个模型名字,而是这几层能力能不能形成闭环。
① 先把工程边界收紧
长期交互型 Agent 很容易一上来就做大。更稳妥的做法,是先做一个最小系统:
src/
  agent/orchestrator.py      # 编排层
  persona/traits.py, prompt.py  # 人格层
  memory/types.py, store.py, extract.py  # 记忆层
  tools/weather.py, reminder.py, registry.py  # 工具层
  models/chat.py, embedding.py, reranker.py  # 模型层
✅ 这种拆法的好处很直接:后面无论是替换模型、增加工具,还是把内存版存储换成 SQLite / 向量库,都不用大改主流程。
② 人格层:不要只写"温柔""聪明",要让人设可配置
很多应用在 system prompt 里写一句"你是一个温柔、耐心的 AI"。这样当然能工作,但它最大的问题是不可控。更适合工程化落地的方式,是把人格参数化。
用 HEXACO 六维人格做结构化建模
HEXACO 是心理学领域最严谨的人格模型之一,六个维度互为正交——每个维度独立控制一种认知倾向。把它作为 AI Agent 的"角色控制面板":
默认Agent人格
@dataclass
class Hexaco:
    honesty: float          # 诚实-谦逊 → 来源信任度
    emotionality: float     # 情绪性 → 情感细腻度
    extraversion: float     # 外向性 → 主动性和社交能量
    agreeableness: float    # 宜人性 → 合作与共情倾向
    conscientiousness: float # 尽责性 → 计划性和条理性
    openness: float         # 开放性 → 联想和创造力
💡 这 6 个值不只是浮点数——它们是角色的控制面板:emotionality 高,安慰场景下会更细腻;conscientiousness 高,涉及计划和提醒时会更有条理;openness 高,更容易做适度联想和延展。
更进一步的做法,是让人格也影响运行时决策——不只是"怎么说",也影响"怎么做":
def derive_runtime_bias(p: Hexaco) -> dict:
    return {
        "emotional_sensitivity": p.emotionality,
        "planning_depth": p.conscientiousness,
        "proactivity": (p.extraversion + p.openness) / 2,
    }
③ 长期记忆层:上下文不是记忆,最多只是缓存
如果一个 Agent 只能依赖最近几轮消息,它最多只能保证当前对话连贯。真正有用的长期记忆,至少要回答两个问题:什么内容值得保存,保存之后怎么在下一轮正确用起来。
记忆类型三分法
长期记忆最大的坑,是把所有内容都混在一起。一个最小实现里,至少分成三类:
- Fact(事实):决定 AI 是否真的"知道你"。例如:"用户最近在准备算法面试"。
- Emotion(情绪):决定 AI 是否在关键时刻"懂你"。例如:"用户近期有焦虑情绪"。
- Preference(偏好):决定 AI 是否逐渐贴近你的交流习惯。例如:"用户喜欢直接的代码建议,不爱寒暄"。
召回不是结束,还要再排一次序
哪怕有了向量召回,也不代表 Top N 一定适合直接送进 Prompt。最终得分通常不是单一相似度,而是语义 + 重要性 + 时间新鲜度 + 类型权重共同决定的:
def score_memory(item, semantic_score: float) -> float:
    type_bonus = 0.15 if item.type == "emotion" else 0.05
    return semantic_score + item.importance * 0.2 + type_bonus
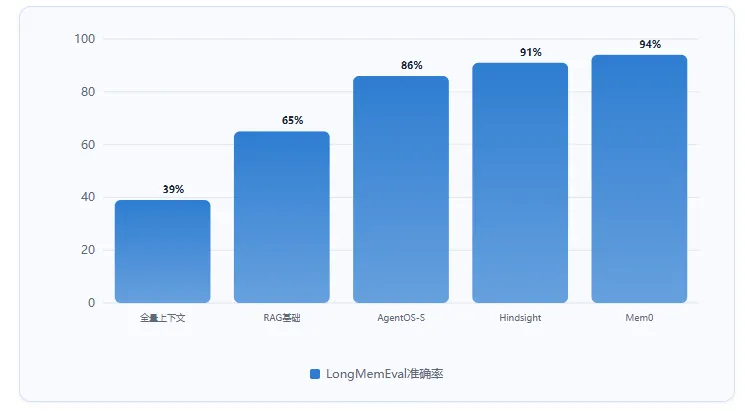
LongMemEval(ICLR 2025)是当前 AI Agent 长期记忆领域的标杆评测——500 道题覆盖信息提取、多会话推理、时间推理、知识更新和拒绝回答 5 种能力。在这个基准上,纯 RAG 全量上下文方法基线仅 39%,而结构化记忆系(Hindsight、Mem0)可达 83%–94%。关键是架构而非模型规模。
④ 工具层:让 Agent 从"给建议"变成"帮你做事"
长期交互型 AI 只有会聊天,体验往往很薄。真正让用户感到"被照顾"的时候,通常不是它说了一句多温柔的话,而是它真的把一件小事办了。
统一工具协议 + 风险分级
@dataclass
class ToolDefinition(Generic[TIn, TOut]):
    name: str              # 工具名称
    description: str       # 工具描述(供 LLM 理解)
    execute: Callable[[TIn], TOut]  # 执行函数
工具写操作从一开始就应该分风险等级:
- read(只读):查询天气、搜索信息等只读操作,风险最低,可直接执行。
- reversible-write(可逆写入)
- irreversible-write(不可逆写入)
⚠️ 很多 Agent 失败并不是"不够聪明",而是"太自信地做错了事"。风险分级是生产环境的底线保障。
⑤ 模型怎么选:先组成闭环,不急着追排行榜
把工程骨架搭好后,模型选择就会变得清楚很多。不需要一上来就追最强配置,先选出一套能把整条链路跑通的组合:
- 主对话:Qwen/Qwen3-8B · Phi-4-mini-instruct —— 理解意图、结合人格和记忆生成回复。
- 记忆嵌入:BAAI/bge-m3 —— 将记忆文本转为向量,支持语义召回。
- 记忆重排:BAAI/bge-reranker-v2-m3 —— 对召回候选做二阶段排序。
- 语音(可选):Whisper-small · Whisper-large-v3 · Silero-VAD —— 文本链路稳定后再接入。
⑥ Python 生态中的开源参考框架
- LangChain:快速接入模型和工具 → 对应
models/、tools/ 模块替代。 - LangGraph:多步骤 Agent 和状态恢复 →
agent/orchestrator.py 升级方案。 - LlamaIndex:文档、记忆和检索系统 →
memory/store.py 增强方案。 - Mem0:长期记忆管理 →
memory/extract.py 替代方案。 - Haystack:可观测检索 Pipeline → 记忆召回管道增强。
- AgentOS:HEXACO 人格 + 认知记忆 → TypeScript 版本的整体参考。
AgentOS 是当前在 LongMemEval 上表现最好的开源框架之一:Short 级 85.6%(gpt-4o),Medium 级 70.2%(1.5M token 干草堆),是唯一在 M 级突破 65% 门槛的开源方案。
⑦ 记忆系统孰强孰弱:LongMemEval 基准比对
数据来源:LongMemEval (ICLR 2025)、Hindsight 技术报告、Mem0 技术报告、AgentOS 公开基准(2025–2026)。分数越高越好。
⑧ 编排层:让人格、记忆和工具真正开始协作
前面三层分别解决了"怎么定义角色""怎么保存用户信息""怎么执行外部动作",但真正能把体验做出来的,还是编排层。
完整编排代码骨架
async def handle_message(user_input: str, actor_id: str, memory_store):
    tools = build_tool_registry(actor_id)           # ① 绑定工具
    system_prompt = build_personality_prompt(...)   # ② 注入人格
    recalled = memory_store.search(user_input, 5)   # ③ 召回记忆

    tool_context = []
    if "天气" in user_input:                        # ④ 判断工具
        weather = tools["check_weather"].execute(...)
        tool_context.append(...)

    final_prompt = f"""                             # ⑤ 拼接上下文
系统设定:{system_prompt}
召回记忆:{recalled}
工具结果:{tool_context}
用户消息:{user_input}"""

    reply = await run_chat_model(final_prompt)       # ⑥ 生成回复

    for mem in extract_memories_from_turn(...):      # ⑦ 提取并写回
        memory_store.save(mem)

    return reply
✅ 这段代码最重要的不是语法,而是它对应的运行顺序:先人格,后记忆,再工具,最后写回。只要这条闭环打通,后面无论替换模型、增加工具,还是把本地存储换成数据库,系统都能自然往上长。
⑨ 跑通并验证完整闭环
只打印一条最终回复,还不能说明 Agent 真的完成了记忆和工具调用。验证时至少检查五件事:召回记忆 → 工具调用 → 工具返回 → 新记忆写入 → 第二轮能否继续召回。
第一轮验证:输入"我明天下午要出门面试,帮我看看天气,顺便提醒我带伞"——预期观察到旧记忆(面试、焦虑)被召回,两个工具被执行,本轮产生新记忆。
第二轮验证:换一种问法"你还记得我最近在为什么事情发愁吗?"——如果第二轮能召回"准备面试"和"焦虑",说明最小的跨轮记忆链路已经成立。
⑩ 实战里最容易踩的四个坑
- 人格漂移:多轮对话后角色风格变味 → 固定人格参数 + 影响运行时偏置 + 角色回归测试。
- 记忆污染:长期记忆变成噪音仓库 → 保留来源/置信度/过期时间 + 用户纠错与删除。
- 工具越界:写操作过于自信 → 风险分级 + 写确认 + 超时重试 + 降级策略。
- Token 膨胀:上下文越长越慢越贵 → 渐进披露 + 记忆摘要 + 工具结果压缩 + 辅助小模型。
结语
长期交互型 AI Agent 不是"聊天模型 + 几个工具"的简单拼接,而是一个围绕人格、长期记忆和工具编排构建出来的运行时系统。
从工程实践角度看,最重要的不是一开始就追求一个功能很全的产品,而是先把最小闭环跑通:
- 用 Python 把这些模块组织成一个可维护的 Agent 工程
只要这条链路已经成立,后面无论是接入更强的模型、更复杂的数据库,还是扩展到语音和主动陪伴,系统都会有一个稳定的落脚点。
 10个月宝宝每天需要喝多少奶粉?