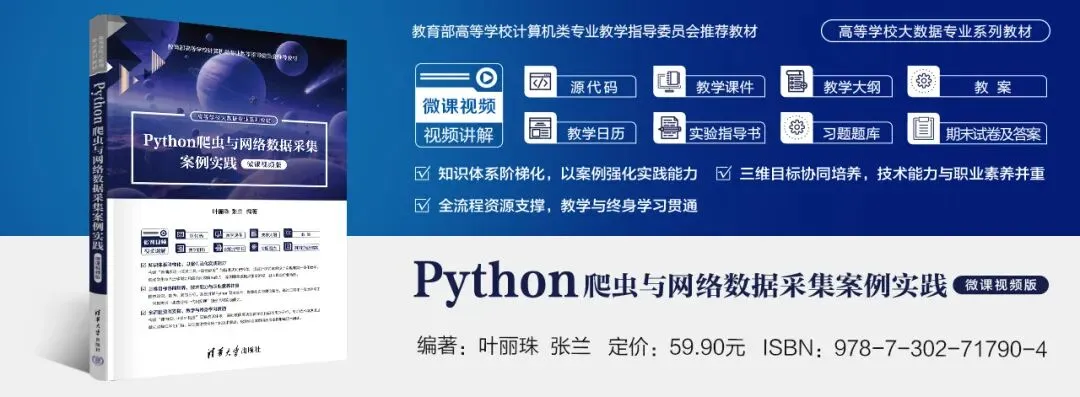
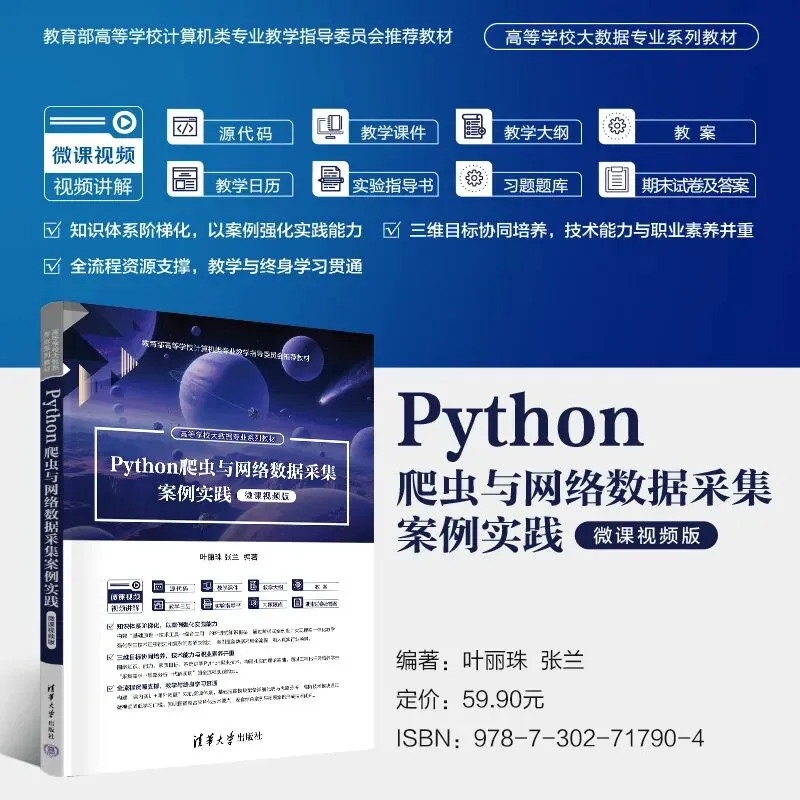
Python爬虫与网络数据采集案例实践
(微课视频版)
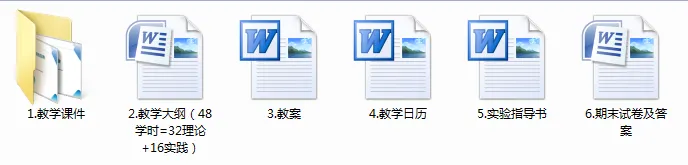
“基础+案例”,提供视频、源码、课件、大纲、教案、实验指导、习题题库、期末试卷等
作者:叶丽珠 张兰 编著
丛书名:高等学校大数据专业系列教材
定价:59.9元
印次:1-1
ISBN:9787302717904
出版日期:2026.06.01
在当今数字化时代,数据已然成为推动社会进步与行业发展的关键驱动力。网络爬虫技术作为挖掘互联网海量数据宝库的有力工具,在大数据分析、人工智能、商业智能等众多前沿领域占据着不可或缺的重要地位。Python 语言凭借其简洁优雅的语法、强大的功能库以及活跃的社区支持,在网络爬虫开发领域备受青睐,成为众多开发者的首选。本书旨在为读者提供全面且深入的Python爬虫与网络数据采集知识,助力读者掌握数据采集实用技能,适应时代发展需求。
全书力求内容精练、系统,由浅入深,循序渐进。本书提供综合案例、拓展案例的思路分析和代码,力争将知识讲解、能力培养、素质教育融为一体。
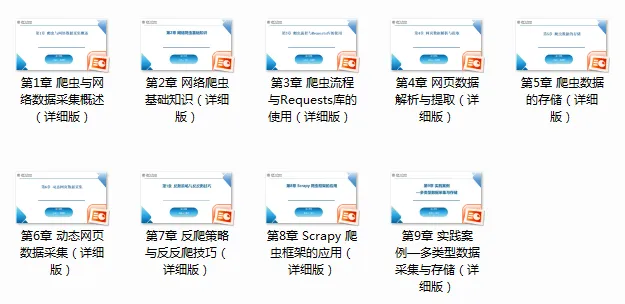
本书全面系统地讲解 Python 爬虫与网络数据采集技术,全书共有9章。
第1章爬虫与网络数据采集概述,包括认识数据采集、走近网络爬虫、网络数据采集的工作原理与流程、网络数据采集的实现技术、网络数据采集的合法性、Python爬虫环境搭建、综合案例——采集“小说”类图书信息。
第2章网络爬虫基础知识,包括浏览器加载网页的过程、网页基础知识、HTTP基础知识、Google开发者工具、综合案例——采集2024年中国大学排名。
第3章爬虫流程与Requests库的使用,包括Python爬虫基本流程、Requests库的使用、综合案例——采集排行榜电影信息、拓展案例——采集翻译信息。
第4章网页数据解析与提取,包括Beautiful Soup的使用、正则表达式的使用、lxml库与XPath的使用、拓展案例——采集二手车信息。
第5章爬虫数据的存储,包括爬虫数据的存储方式、存储至JSON文件、存储至MongoDB数据库、存储至MySQL数据库、拓展案例——采集贴吧信息。
第6章动态网页数据采集,包括静态网页与动态网页的区分、使用逆向分析法采集动态网页、使用Selenium采集动态网页、拓展案例——采集非物质文化遗产信息。
第7章反爬策略与反反爬技巧,包括反爬虫与反反爬虫的定义、反爬虫技术、反反爬虫技术、拓展案例——采集招聘网岗位信息。
第8章Scrapy爬虫框架的应用,包括Scrapy框架概述、Scrapy的工作原理、综合案例——采集古诗词排行榜、拓展案例——采集微博搜索文章信息。
第9章实践案例——多类型数据采集与存储,包括采集股票财经信息、采集聚合数据官网的天气数据、采集安居客租房信息。
(1) 知识体系阶梯化,以案例强化实践能力。
本书构建“基础原理→技术工具→综合应用”的渐进式知识框架,通过阶梯式案例设计实现理实一体化教学,强化学生技术迁移能力和复杂问题解决能力。案例覆盖数据采集全流程,融入真实行业场景。拓展案例与行业工具深度融合,确保技能训练与产业需求无缝对接。
(2) 三维目标协同培养,技术能力与职业素养并重。
本书围绕知识、能力、素质目标,系统讲解Python爬虫技术,构建扎实的理论基础。通过工程化任务培养学生“采集需求→思路分析→代码实现”的全流程实践能力。在技术训练中融入数据伦理、创新思维和团队协作等职业素养教育,培养适应行业发展的应用型人才。
(3) 全流程资源支撑,教学与终身学习贯通。
本书构建“课内实训+课外拓展”双轨资源体系,基础技能模块配备详细代码与思路分析,高阶技术模块通过微视频降低学习门槛。知识图谱整合碎片化技术要点,配套综合案例与拓展案例形成技术闭环。数字化资源支持混合式教学,帮助学生突破技术边界。
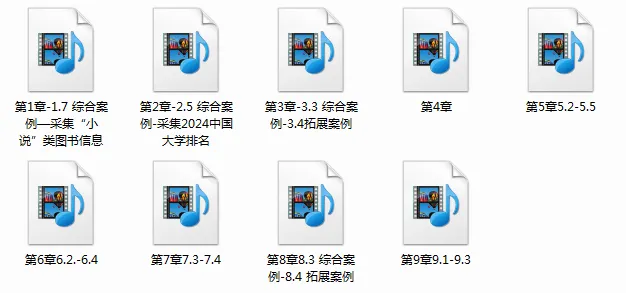
为便于教与学,本书配有微课视频、源代码、教学课件、教学大纲、教案、教学日历、实验指导书、题库、期末试卷及答案。
本书可以作为高等学校数据科学与大数据技术、计算机科学与技术、软件工程等计算机相关专业的教材,以及网络爬虫技术爱好者、数据分析从业人员的自学用书。