基于Python+Selenium的铁路车次查询爬虫:设计与实现
- 2026-09-09 16:24:28
基于Python+Selenium的铁路车次查询爬虫:设计与实现本免责声明适用于本项目(以下简称"本程序"或"本工具")及其源代码、文档、示例数据的全部内容。本程序是一个基于 Python 与 Selenium 编写的铁路时刻查询命令行工具,通过模拟浏览器访问第三方网站页面来获取车次时刻信息,仅用于个人学习、技术研究与非商业用途。任何个人或组织在获取、安装、运行、修改或分发本程序前,请务必完整阅读并理解本声明的全部内容。一旦您下载、复制、运行或以任何方式使用本程序,即视为您已阅读、理解并同意本声明的全部条款。如果您不同意本声明中的任何内容,请立即停止使用本程序,并删除已获取的全部相关文件。
先看结果: 这是一个基于 Python + Selenium 编写的命令行工具,用于自动化查询移动端页面上的火车直达车次信息。整体代码约 530 行,没有依赖复杂的框架,核心思路是"用浏览器自动化模拟人的操作 + 用正则表达式解析页面文本"。下面从架构、关键模块、核心算法三个层面详细拆解。 程序大致可以分为五个模块: 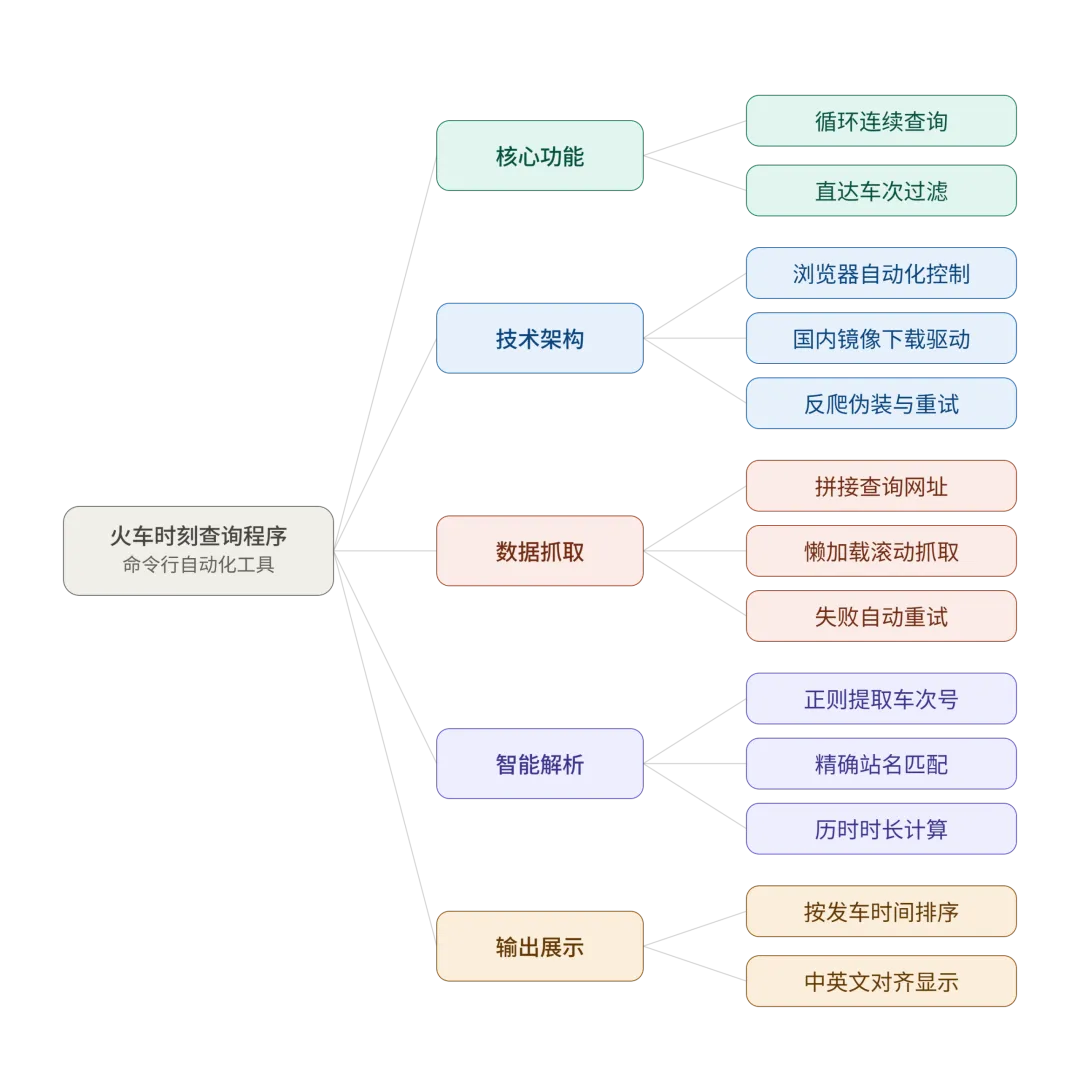
核心功能 :面向用户的交互循环,支持连续多次查询。 技术架构 :Selenium 浏览器自动化 + chromedriver 驱动获取(国内镜像适配)。 数据抓取 :拼接携程移动端接口地址,处理懒加载滚动。 智能解析 :用正则表达式从页面文本中提取车次号、时间、站名等结构化信息,并做精确站名匹配。 输出展示 :排序、中英文宽度对齐后打印成表格。 入口函数是文件最后的 run_query(),它把上述模块串联起来,形成一个"输入条件 → 抓取 → 解析 → 展示 → 是否继续"的循环。 Selenium 控制 Chrome 浏览器,需要一个叫 chromedriver 的可执行文件作为"翻译官",负责把 Selenium 的指令转成浏览器能听懂的操作。原始的第三方库(webdriver_manager)默认会从 Google 或 GitHub 相关地址自动下载对应版本的 chromedriver,但这些地址在国内网络环境下经常连不上或者超时。 解决方案是自己实现一套下载逻辑,优先级如下: 这是一个典型的"链式兜底"写法:先看有没有手动指定,再看脚本目录下有没有现成文件,都没有才走网络下载。这样即使某个环节出问题,用户也有办法手动补救,而不是程序直接崩溃。 真正下载时,代码通过 get_chrome_major_version() 检测本机 Chrome 的主版本号(Windows 读注册表,macOS/Linux 执行 --version 命令),然后区分两套发布体系:Chrome 115 版本之前用的是"旧版"打包方式,115 及以后改用了 Google 的 "Chrome for Testing" 新体系,文件命名和目录结构都不一样。代码里用一个常量做了分界: 下载源统一换成了 npmmirror 的国内镜像地址(registry.npmmirror.com),根据版本号走不同的 URL 拼接逻辑,下载后解压并缓存到用户目录 ~/.train_query_cache 下,下次运行时可以直接复用,不用重复下载。 页面对自动化访问是有一定识别机制的,所以 build_driver() 里做了几层伪装: 值得一提的细节是,浏览器的 User-Agent 被伪装成了 iPhone 上的 Safari,也就是说程序访问的其实是移动端网页,而不是桌面版。移动端页面结构相对简单,也更适合这种轻量抓取。 另外还有一步是通过 Chrome DevTools 协议(CDP)在页面加载前注入一段 JS,把 navigator.webdriver 这个能暴露"这是自动化浏览器"身份的属性给隐藏掉: 车次列表页是滚动到底部才继续加载更多结果的"懒加载"模式,如果只抓取首屏内容,会漏掉后面的车次。fetch_trains() 里用了一个"反复滚动、直到车次数量连续两轮不再增加"的策略: 这里的关键判断逻辑是:每滚动一次就统计一次当前页面上车次卡片的数量,如果连续两轮数量都没有变化,就认为已经加载到底了,跳出循环;否则继续滚动。同时设置了最多 15 轮的硬性上限,避免网页出现异常(比如无限加载)时程序卡死。此外整个抓取过程还包了一层重试机制,页面加载超时会自动重试(默认 2 次)。 核心问题是:如何从一段夹杂着车次号、时间、站名的纯文本里,准确地把结构化信息抠出来。 每张车次卡片抓下来是一段连续文本,代码先用正则表达式找车次号和时间点: 车次号的正则覆盖了高铁/动车(G/D)、特快(T/Z/K)等常见前缀,也兼容纯数字的普速车次编号;时间用简单的 HH:MM 模式匹配,一张卡片至少要出现两个时间点(发车、到达)才算有效。后续如果车次号调整也只需改动这一处就可以。 如果只是简单判断"文本里有没有出现目标站名",会遇到一个坑:查"苏州"的时候,"苏州北"这个词里也包含"苏州"两个字,容易被误判成命中。为此写了两个辅助函数: 更棘手的问题是:一张卡片上通常有两个时间(发车、到达)和两个站名,但站名和时间在排版上"谁在前谁在后"是不固定的,没法简单地靠"离得近"来猜。find_station_for_time() 的做法是不猜方向,而是直接拿"期望的站名"去时间左右两侧的候选文本里找: 逻辑分三步:先定位时间字符串在文本中的位置,分别向左、向右各截取一段紧邻的中文字符作为"候选站名";然后拿调用方期望的站名(比如用户输入的"苏州")去候选项里比对,命中了就直接确认;如果两侧都不命中,就返回排在前面的候选项,交给调用方(parse_cards)根据比对结果判定这张卡片不匹配、予以排除。这种"不猜方向,直接验证"的思路,比"哪边离得近就归哪边"的启发式方法要可靠得多。 在 parse_cards() 里,这几个函数被组合使用,形成了完整的过滤链条:先解析出发/到达站名,和用户输入做精确比对,两边都对上了才保留这张卡片,任何一边对不上就直接跳过——这就避免了把不相关的推荐车次(比如经停站包含目标站名的车次)也算进结果里。 最后是打印表格的部分。中文字符在等宽字体下显示宽度通常是英文字符的两倍,如果直接按字符数对齐,中文站名和车次号混排的表格会参差不齐。程序用了一个简单但实用的技巧: get_display_width 按 Unicode 编码区间判断每个字符是不是中文(\u4e00 到 \u9fff 是 CJK 统一表意文字的编码范围),中文字符按 2 倍宽度计算,再用 align_text 补上对应数量的空格,让整张表格在终端里对齐美观。 run_query() 是整个程序的调度中心,逻辑并不复杂:启动浏览器 → 进入 while True 循环,每轮询问出发站、到达站、日期(支持直接回车用默认值,输入 q/exit/quit 随时退出)→ 调用 fetch_trains 抓取 → 调用 parse_cards 解析 → print_results 打印 → 询问是否继续。整个程序结束时会在 finally 块里调用 driver.quit(),确保浏览器进程被正常关闭,不会残留后台进程占用资源。
[系统] 正在启动浏览器(国内镜像模式)...============================================================铁路查询============================================================▶ 出发站 (上海虹桥):▶ 到达站 (北京南): 太仓南▶ 日期 (2026-08-08):🔍 正在检索: 上海虹桥 ➔ 太仓南...车次 |出发站 |到达站 |时间(历时)-----------------------------------------------------------------G8352 |上海虹桥 |太仓南 |13:22-13:48 (0:26)C3772 |上海虹桥 |太仓南 |15:09-15:35 (0:26)G8364 |上海虹桥 |太仓南 |18:56-19:22 (0:26)-----------------------------------------------------------------📊 统计:找到 3 趟直达车次。[询问] 是否继续? (y/n, 默认y):============================================================铁路查询============================================================▶ 出发站 (上海虹桥):▶ 到达站 (北京南): 苏州北▶ 日期 (2026-08-08):🔍 正在检索: 上海虹桥 ➔ 苏州北...车次 |出发站 |到达站 |时间(历时)-----------------------------------------------------------------G1970 |上海虹桥 |苏州北 |06:09-06:32 (0:23)G1802 |上海虹桥 |苏州北 |06:13-06:36 (0:23)G1772 |上海虹桥 |苏州北 |06:35-06:58 (0:23)G2 |上海虹桥 |苏州北 |06:43-07:04 (0:21)后面太多不一一展示了...
一、整体架构
二、技术架构:为什么要自己处理 chromedriver 下载
def get_driver_path():"""按优先级获取 chromedriver 路径:1) 环境变量 CHROMEDRIVER_PATH 手动指定2) 脚本同目录下的 chromedriver(.exe)3) 通过国内镜像自动下载并缓存"""env_path = os.environ.get("CHROMEDRIVER_PATH")if env_path and os.path.exists(env_path):return env_pathlocal_name = "chromedriver.exe" if platform.system() == "Windows" else "chromedriver"local_path = os.path.join(os.path.dirname(os.path.abspath(__file__)), local_name)if os.path.exists(local_path):return local_pathmajor = get_chrome_major_version()if not major:raise RuntimeError(...)return download_chromedriver_from_mirror(major)
CFT_CUTOVER_MAJOR = 115三、浏览器伪装与反爬
chrome_options.add_argument("--headless=new")chrome_options.add_argument("user-agent=Mozilla/5.0 (iPhone; CPU iPhone OS 16_0 like Mac OS X) AppleWebKit/605.1.15 ""(KHTML, like Gecko) Version/16.0 Mobile/15E148 Safari/604.1")chrome_options.add_argument("--disable-blink-features=AutomationControlled")chrome_options.add_experimental_option("excludeSwitches", ["enable-automation"])chrome_options.add_experimental_option("useAutomationExtension", False)
driver.execute_cdp_cmd("Page.addScriptToEvaluateOnNewDocument",{"source": "Object.defineProperty(navigator, 'webdriver', {get: () => undefined})"},)
四、数据抓取:处理懒加载
last_count = 0stable_rounds = 0for _ in range(15): # 最多滚动 15 轮,防止极端情况下死循环driver.execute_script("window.scrollTo(0, document.body.scrollHeight);")time.sleep(1.2)current_count = len(driver.find_elements(By.XPATH, item_xpath))if current_count == last_count:stable_rounds += 1if stable_rounds >= 2:breakelse:stable_rounds = 0last_count = current_count
五、智能解析
5.1 车次号与时间的提取
train_match = re.search(r'\b([GDTZKCS]\d{1,5}|\d{4,5})\b', text)times = re.findall(r'(\d{2}:\d{2})', text)
5.2 站名精确匹配:避免"苏州"误判成"苏州北"
def station_in_text(text, station_name):"""精确匹配站名,避免子串误判(例如 "苏州" 不应匹配到 "苏州北")。"""pattern = re.escape(station_name) + r'(?:站)?'regex = r'(?<![\u4e00-\u9fff])' + pattern + r'(?![\u4e00-\u9fff])'return re.search(regex, text) is not Nonedef normalize_station(name):"""去掉站名末尾的"站"字,便于统一比较("苏州站" 与 "苏州" 视为同一站)"""if name and name.endswith("站"):return name[:-1]return name
station_in_text用了正则的负向零宽断言((?<!...) 和 (?!...)),要求目标站名的前后不能紧跟其他中文字符——这样"苏州"就不会命中"苏州北"里的"苏州",因为后面紧跟着"北"字。同时用 (?:站)? 兼容"苏州"和"苏州站"两种写法。normalize_station 则负责把"苏州站"统一成"苏州",方便后续比较时忽略"站"字的差异。5.3 判断某个时间点对应的到底是哪个站
def find_station_for_time(text, time_str, expected_norm):idx = text.find(time_str)before = text[:idx]after = text[idx + len(time_str):]m_before = re.search(r'([\u4e00-\u9fff]{2,10})\s*$', before)m_after = re.search(r'^\s*([\u4e00-\u9fff]{2,10})', after)candidates = []if m_before:candidates.append(m_before.group(1))if m_after:candidates.append(m_after.group(1))for c in candidates:if normalize_station(c) == expected_norm:return creturn candidates[0] if candidates else None
六、输出展示:中英文混排对齐
def get_display_width(text):"""计算含中文字符的显示宽度(中文按 2 个字符宽计算)"""width = 0for char in text:if '\u4e00' <= char <= '\u9fff':width += 2else:width += 1return widthdef align_text(text, target_width):current_width = get_display_width(text)padding = max(0, target_width - current_width)return text + (" " * padding)
七、主循环:把各模块串起来
鸣谢
claude code
[==============往期推荐==============]
点击标题可直接跳转
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 这份 Linux 工具教程,把命令速查、定时任务和排障串成一条线
- ray · Python 分布式 AI 计算引擎
- 影响了世界的linux,名字起得如此随意
- Valve出手:Linux 7.3让显卡显存"不够用"不再等于崩溃
- 自学Python,顺序比努力重要!!
- 我的实验随笔:Linux篇(6):使用私钥登录服务器的具体操作
- Python游戏汇总:三十个pygame游戏代码!
- Linux多媒体进阶之旅(十五): 音乐播放时,WirePlumber如何选择设备?
- 价值4.6万美元的顶级工作站上,Linux把Windows 11按在地上摩擦
- Python开发从零开始-50.35-Office 文档处理