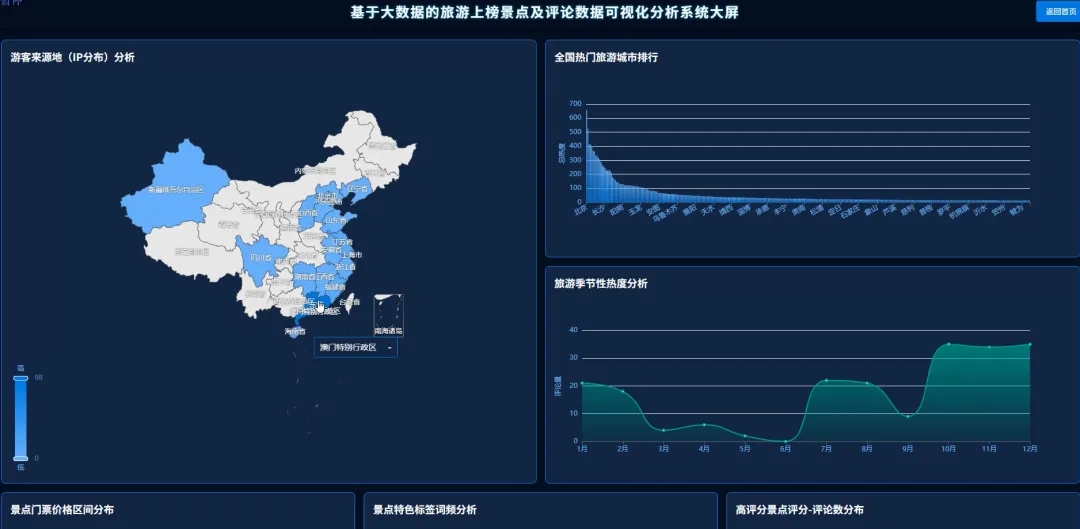
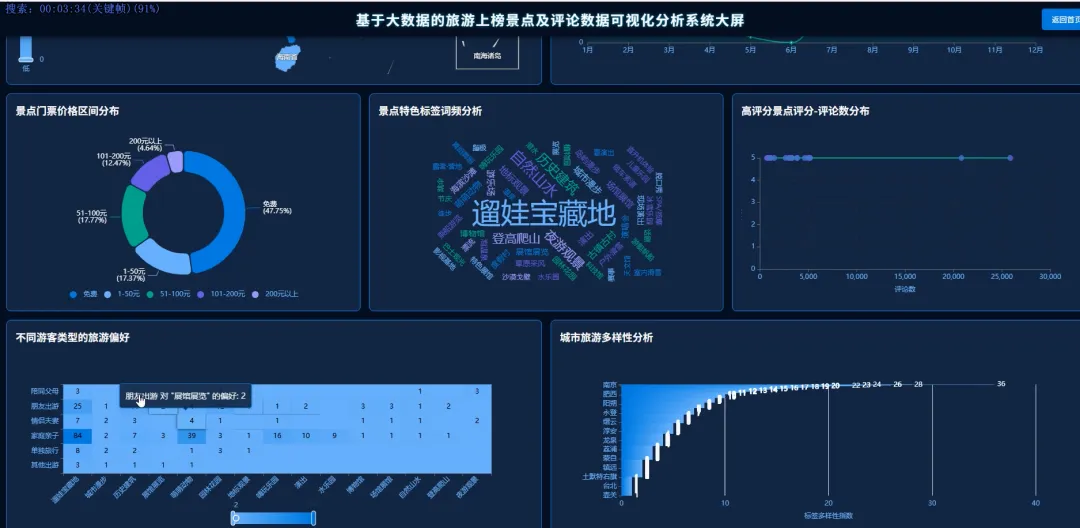
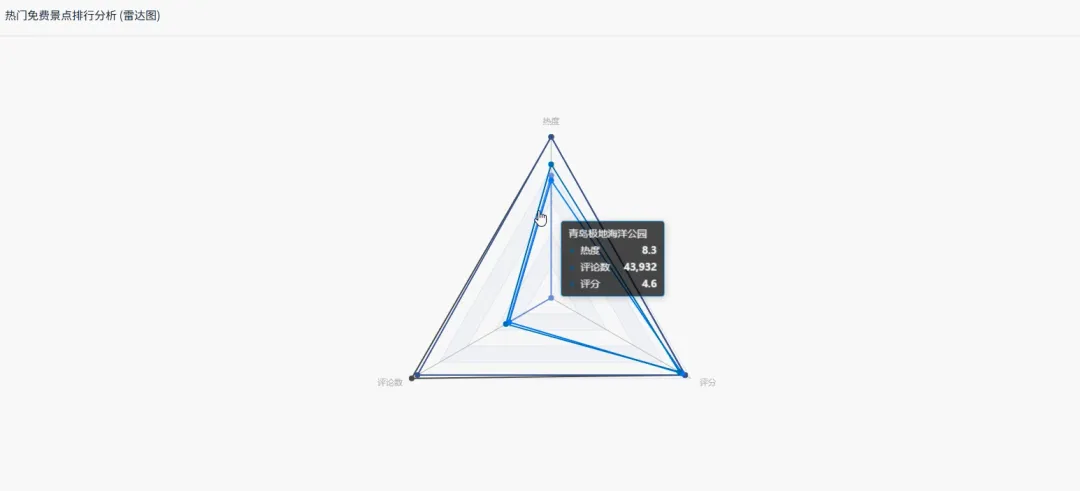
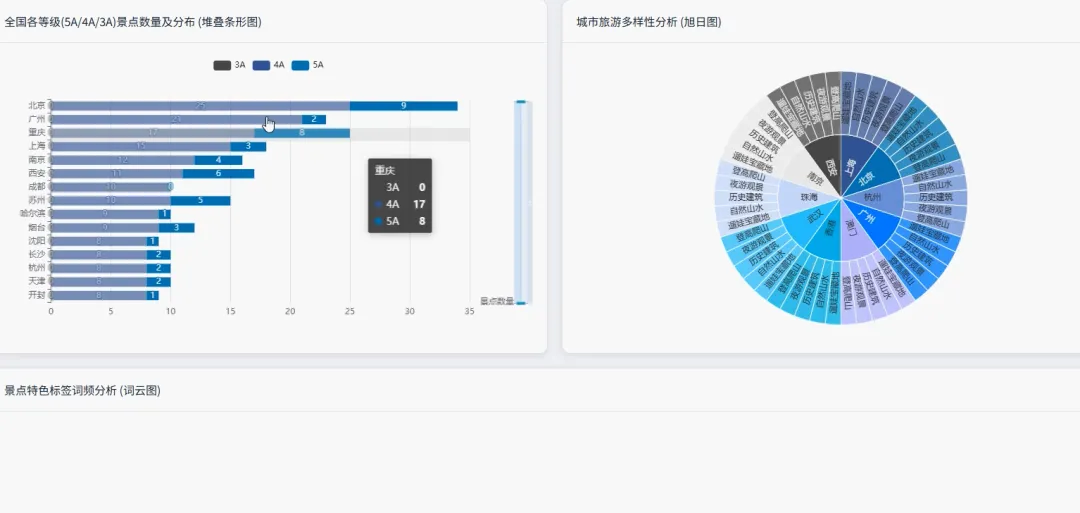
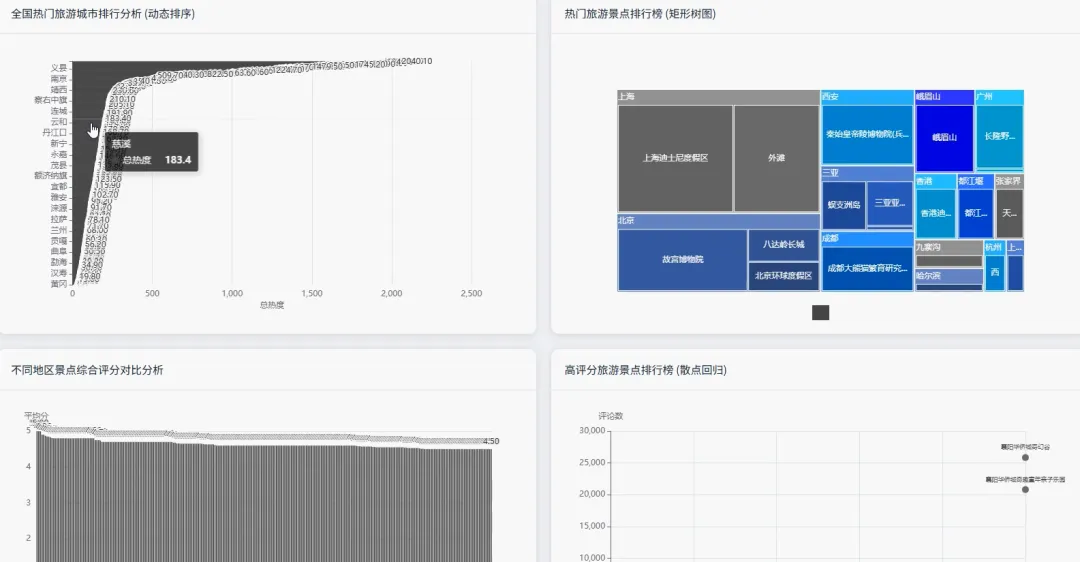
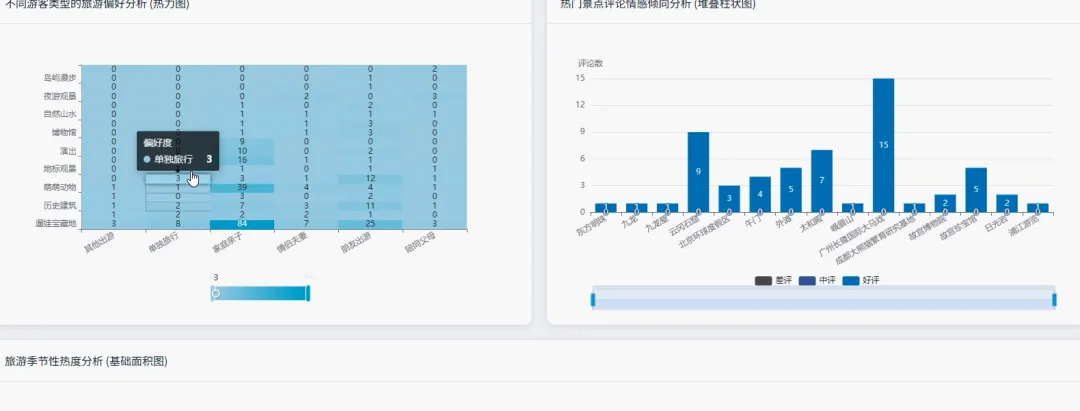
spark = SparkSession.builder.appName("TourismAnalysis").getOrCreate()def analyze_hot_cities(): sight_df = spark.read.csv("hdfs://path/to/sightinfo.csv", header=True, inferSchema=True) # 过滤掉热度分无效的数据,并进行数据清洗 sight_df = sight_df.filter(sight_df["heatscore"].isNotNull() & (sight_df["heatscore"] != "\\N")) # 将热度分转换为数值类型以便计算 from pyspark.sql.functions import col, sum as _sum sight_df = sight_df.withColumn("heatscore", col("heatscore").cast("float")) # 按城市分组并计算总热度 city_heat_df = sight_df.groupBy("districtname").agg(_sum("heatscore").alias("total_heat")) # 按总热度降序排列,获取热门城市排行 hot_cities_df = city_heat_df.orderBy(col("total_heat").desc()) # 将结果写入HDFS或输出 hot_cities_df.coalesce(1).write.csv("hdfs://path/to/output/hot_cities_analysis.csv", header=True, mode="overwrite") return hot_cities_dfdef analyze_tourist_preference(): sight_df = spark.read.csv("hdfs://path/to/sightinfo.csv", header=True, inferSchema=True) comment_df = spark.read.csv("hdfs://path/to/commentinfo.csv", header=True, inferSchema=True) # 定义UDF用于判断评论内容是否包含景点名,解决数据关联难题 from pyspark.sql.functions import udf from pyspark.sql.types import BooleanType def contains_sight_name(plcontent, poiname): if plcontent and poiname: return poiname in plcontent return False contains_udf = udf(contains_sight_name, BooleanType()) # 通过交叉连接和UDF过滤来关联两个数据集(注意:大数据量下此方法效率低,仅为示例逻辑) combined_df = comment_df.crossJoin(sight_df).filter(contains_udf(comment_df["plcontent"], sight_df["poiname"])) # 处理标签字段,拆分并展开 from pyspark.sql.functions import explode, split combined_df = combined_df.withColumn("tag", explode(split(combined_df["tagname"], ","))) # 按游客类型和景点标签分组,统计偏好次数 preference_df = combined_df.groupBy("touristtype", "tag").count() # 将结果写入HDFS preference_df.coalesce(1).write.csv("hdfs://path/to/output/tourist_preference_analysis.csv", header=True, mode="overwrite") return preference_dfdef analyze_comment_sentiment(): comment_df = spark.read.csv("hdfs://path/to/commentinfo.csv", header=True, inferSchema=True) # 过滤掉评分无效的数据 comment_df = comment_df.filter(comment_df["score"].isNotNull() & (comment_df["score"] != "\\N")) # 将评分转换为整数类型 from pyspark.sql.functions import col, when, count as _count comment_df = comment_df.withColumn("score", col("score").cast("int")) # 根据评分定义情感倾向:4-5分为好评,3分为中评,1-2分为差评 sentiment_df = comment_df.withColumn("sentiment", when(col("score") >= 4, "好评") .when(col("score") == 3, "中评") .otherwise("差评")) # 按情感倾向分组,统计各评价的数量 sentiment_count_df = sentiment_df.groupBy("sentiment").agg(_count("*").alias("count")) # 将结果写入HDFS sentiment_count_df.coalesce(1).write.csv("hdfs://path/to/output/comment_sentiment_analysis.csv", header=True, mode="overwrite") return sentiment_count_df
 10个月宝宝每天需要喝多少奶粉?