python自动化系列:批量自动转换pdf文件为txt文件
- 2026-08-27 15:05:51
作品名称:批量自动转换pdf文件为txt文件
开发环境:PyCharm 2023.3.4 + python3.7
用到的库:os、PyPDF2
适用场景:当需要编辑PDF文件的时候。
实现过程
一、代码设计
以下是代码的详细说明:
导入模块:
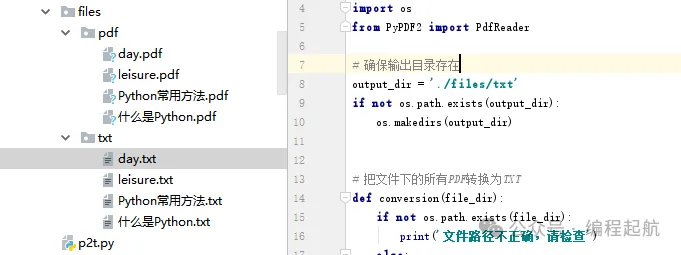
os:用于文件和目录操作。PyPDF2:用于读取PDF文件。设置输出目录:
output_dir:定义TXT文件的输出目录。使用
os.makedirs确保输出目录存在。定义
conversion函数:参数
file_dir:包含PDF文件的目录路径。检查目录是否存在,然后获取所有PDF文件列表。
对每个PDF文件调用
pdf2txt函数进行转换。定义
pdf2txt函数:参数
pdf_path:单个PDF文件的路径。使用
PyPDF2.PdfReader读取PDF文件。初始化空字符串
text_content以存储提取的文本。遍历PDF的每一页,使用
extract_text方法提取文本,并将其累加到text_content。将累加的文本内容写入到一个新的TXT文件中,文件名基于原PDF文件名。
定义
get_name函数:参数
file_path:文件的路径。使用
os.path.basename获取文件名(带扩展名)。使用
os.path.splitext分离文件名和扩展名,返回文件名(不含扩展名)。执行转换:
调用
conversion函数,并传入包含PDF文件的目录路径。异常处理:
在
pdf2txt函数中,使用try-except结构捕获并打印在读取PDF或写入TXT文件时发生的异常。输出信息:
在转换过程中,打印转换成功或错误的信息。
"""批量自动转换pdf文件为txt文件"""import osfrom PyPDF2 import PdfReader# 确保输出目录存在output_dir = './files/txt'if not os.path.exists(output_dir):os.makedirs(output_dir)# 把文件下的所有PDF转换为TXTdef conversion(file_dir):if not os.path.exists(file_dir):print('文件路径不正确,请检查')else:file_list = [f for f in os.listdir(file_dir) if f.endswith('.pdf')] # 确保是PDF文件for file in file_list:pdf_path = os.path.join(file_dir, file)try:pdf2txt(pdf_path)except Exception as e:print(f"转换错误: {e}")# PDF转为TXTdef pdf2txt(pdf_path):# 使用PyPDF2读取PDF文件reader = PdfReader(pdf_path)# 初始化一个空字符串用于存储文本text_content = ""# 遍历PDF中的每一页for page_num in range(len(reader.pages)):# 获取每一页的内容page = reader.pages[page_num]# 将文本添加到字符串text = page.extract_text()if text: # 确保提取的文本不为空text_content += text + "\n"# 保存TXT文件name = get_name(pdf_path)# TXT文件输出路径txt_file = os.path.join(output_dir, f"{name}.txt")try:with open(txt_file, 'w', encoding='utf-8') as f:f.write(text_content)print(f"文件已保存: {txt_file}")except Exception as e:print(f"保存文件时出错: {e}")# 获取文件名def get_name(file_path):# 使用os.path.basename()获取文件名file_name_with_extension = os.path.basename(file_path)# 使用os.path.splitext()分离文件名和后缀名file_name, _ = os.path.splitext(file_name_with_extension)return file_nameconversion('./files/pdf')
二、结语
以上就是本次分享的全部内容,如果你有任何疑问或想要分享你的自动化办公经验,我们的评论区永远为你敞开。你的每一个点赞和转发,都是对我们最大的支持和鼓励!
想要深入学习并获取文中的完整代码吗?很简单,关注我们的公众号,并回复文章标题,即可立即获取。
再次感谢你的阅读,期待在下一次分享中与你相见!
 精选阅读
python自动化系列:将Excel表格中的学生信息自动填充到一个word文档
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- 【第4集】:电机控制篇|50个SCL编程经典程序-程序6:三相电机直接启动程序
- 【python在线直播课】NOAI人工智能奥赛官方指定语言,寒假学习立省3000元!
- Java 面向对象核心!面向接口编程吃透这篇就够了
- 用python实现四个完整游戏开发小项目
- SQL编程大赛第6名张泽鹏:数独还能这么解?PostgreSQL 玩转约束传播
- Python装饰器
- 【AI时代如何学编程】- 学习目标已变:从“造砖工”到“建筑师”
- Python 装饰器实战:写一个自动记录脚本运行时间的装饰器
- 网络工程师狂喜!2026年Linux命令速查手册
- 2025年3月GESP7级难度编程题解,量子跃迁:GESP 7级图论时空穿梭