当前位置:首页>python>Python+Spark医疗数据分析:肝硬化生存预测可视化系统教程 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

Python+Spark医疗数据分析:肝硬化生存预测可视化系统教程 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

  • 2026-10-14 12:38:06
Python+Spark医疗数据分析:肝硬化生存预测可视化系统教程 毕业设计 选题推荐 毕设选题 数据分析 机器学习 数据挖掘

基于Spark的肝硬化患者生存预测数据可视化分析系统

一
肝硬化患者生存预测数据可视化分析系统-简介

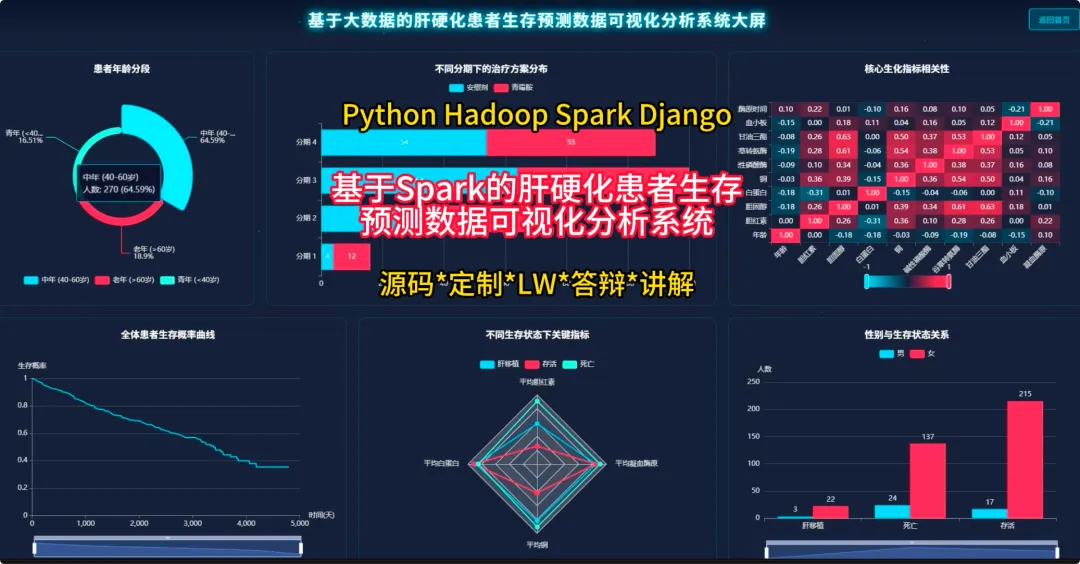
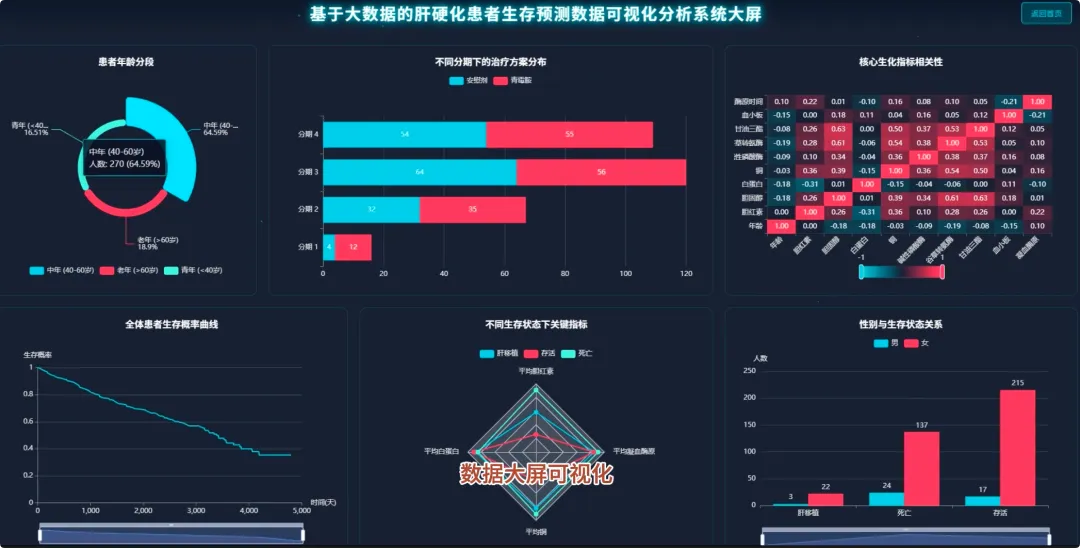
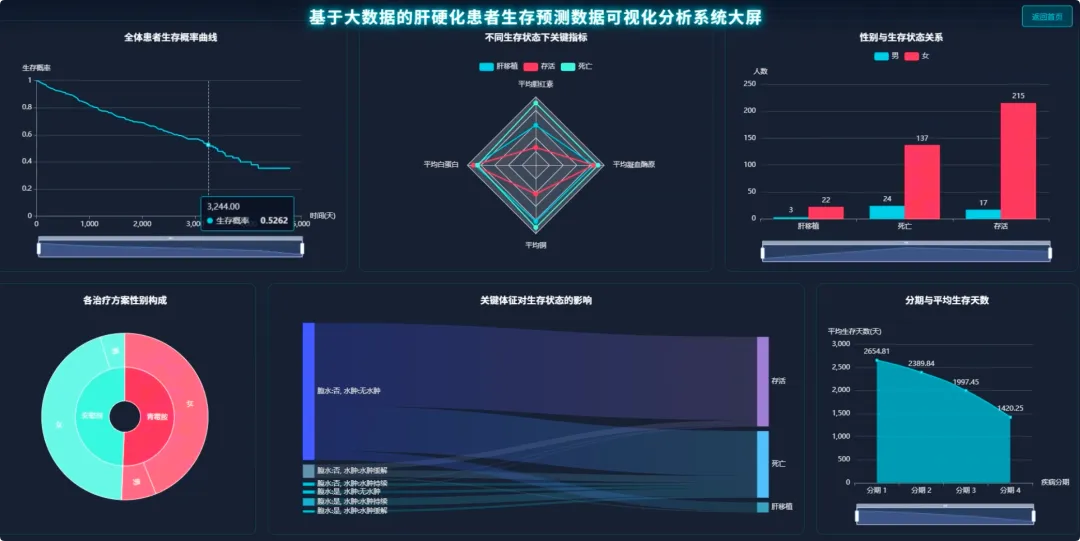
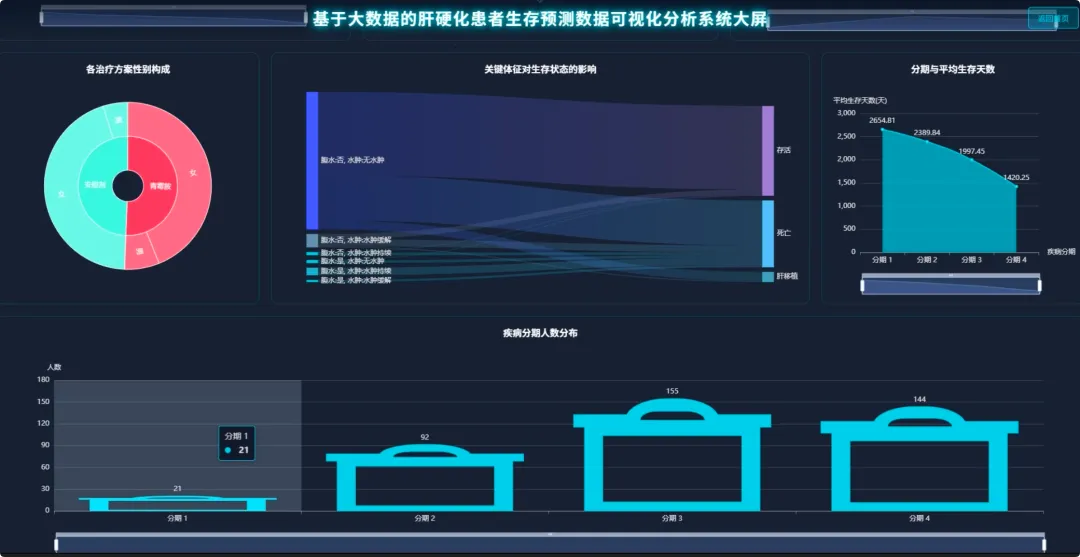
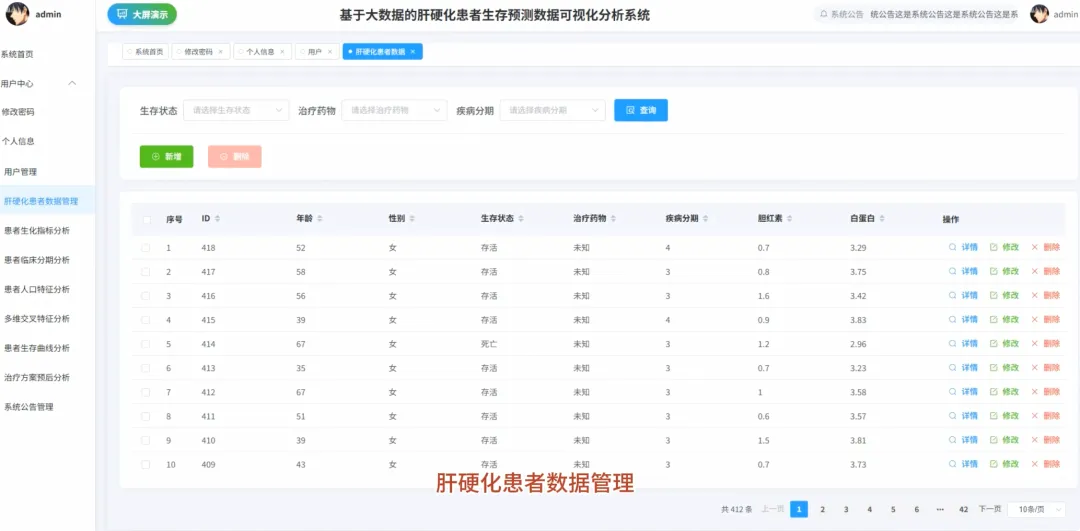
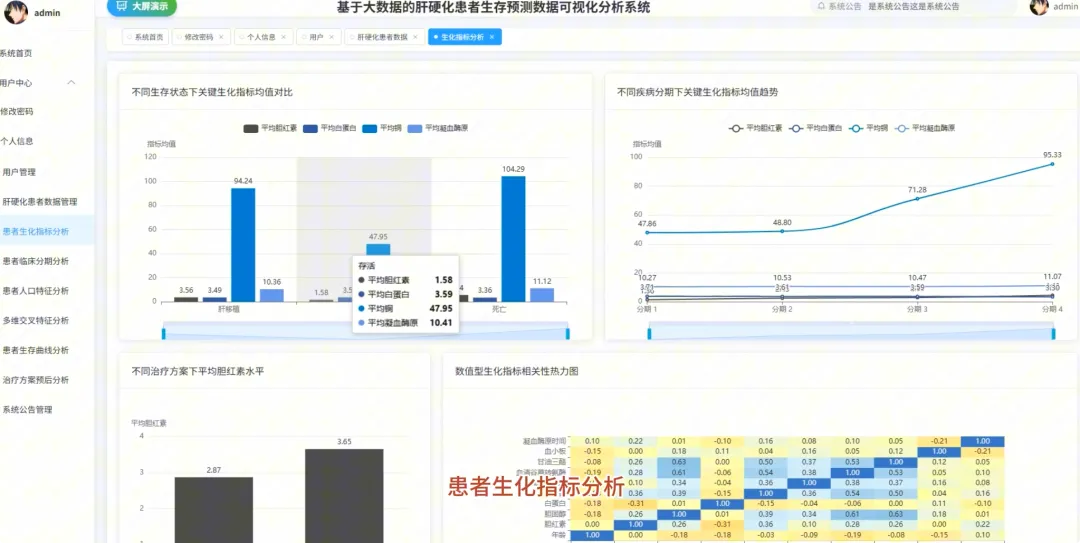
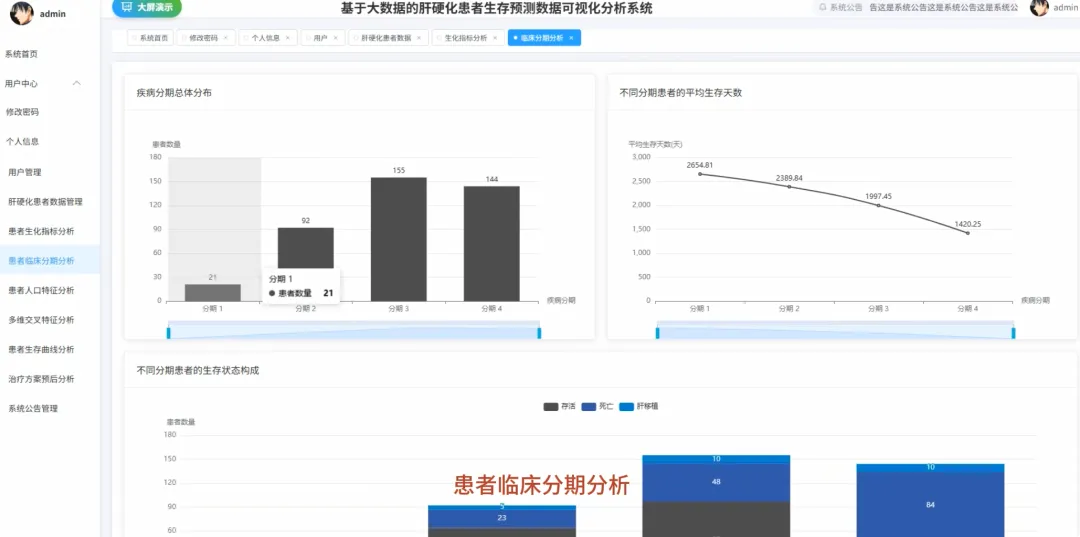
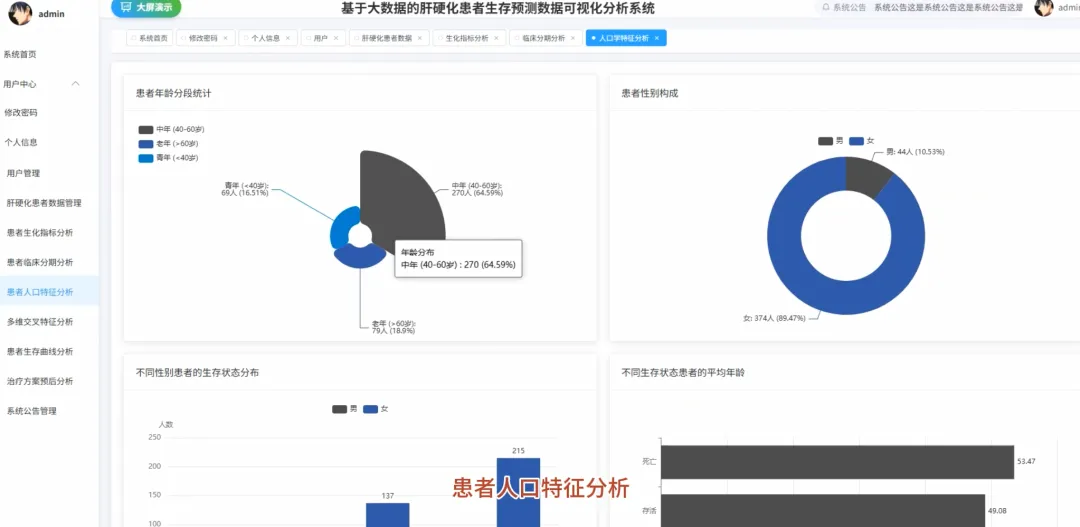
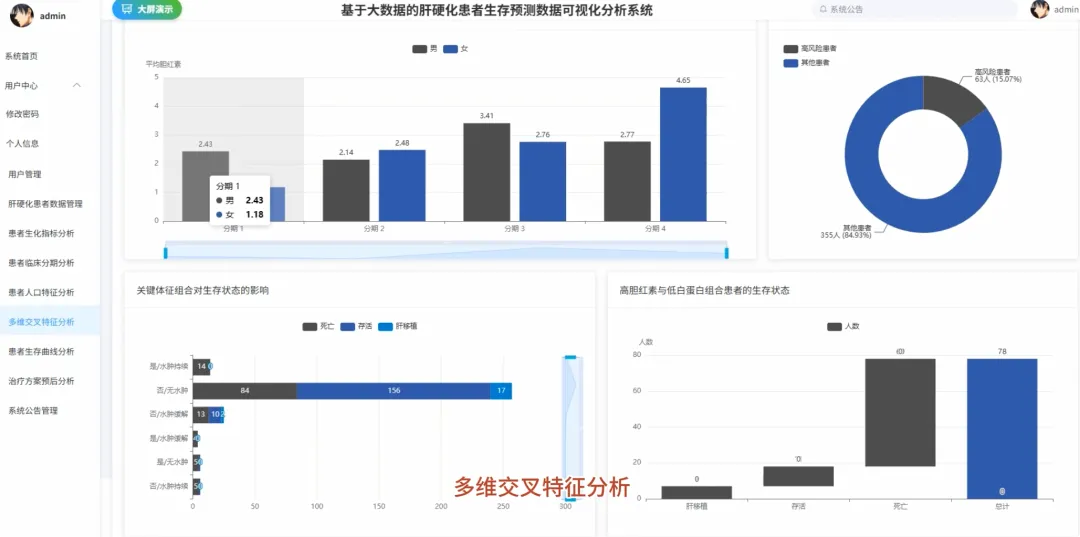
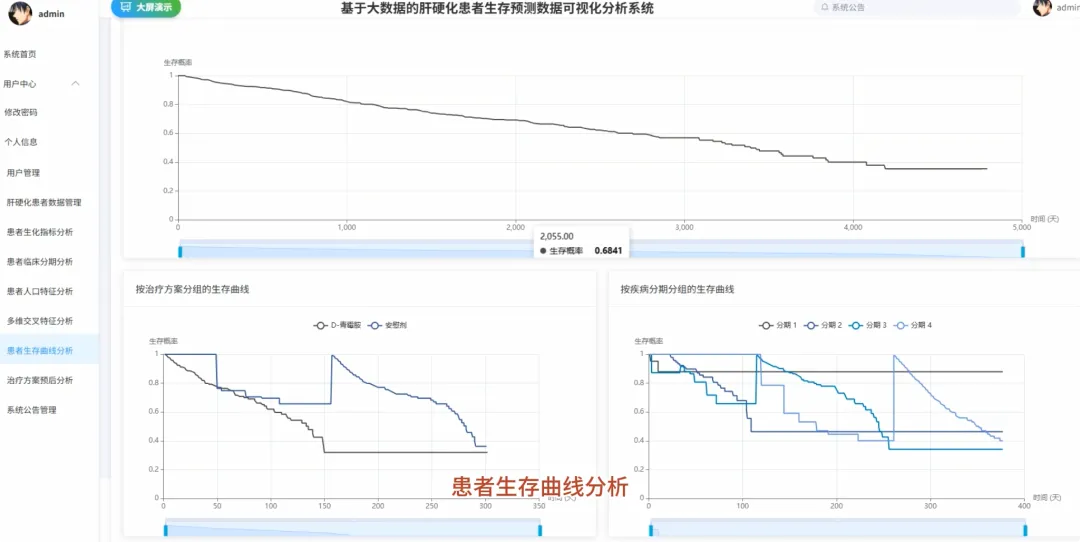
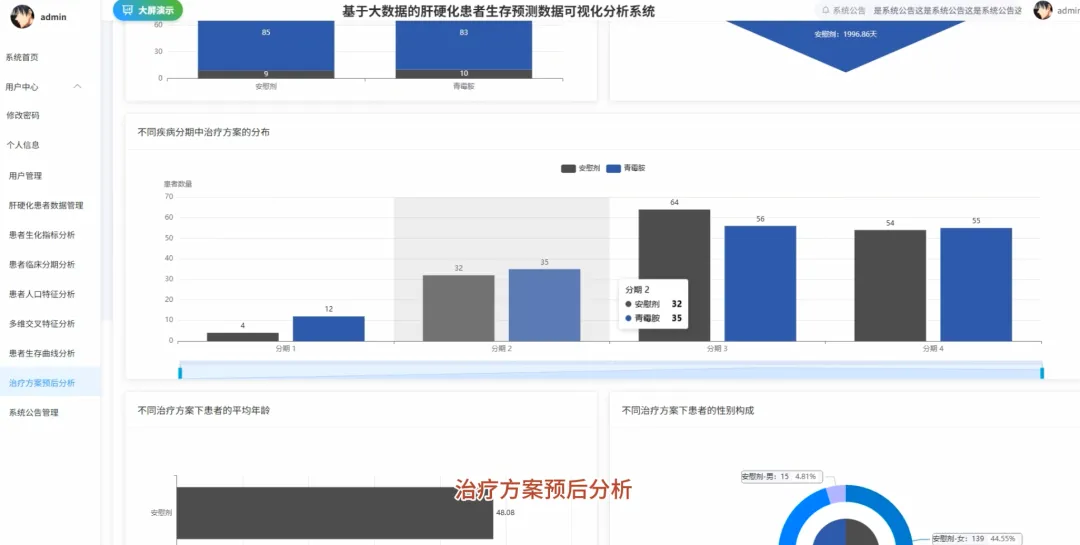
本系统“基于Spark的肝硬化患者生存预测数据可视化分析系统”是一个围绕医疗健康大数据构建的综合性分析平台。系统底层采用Hadoop HDFS作为海量肝硬化患者临床数据的分布式存储解决方案,确保了数据的可靠性和可扩展性。核心计算引擎选用Apache Spark,特别是利用其Spark SQL组件对cirrhosis_processed.csv数据集进行高效的多维度数据分析。后端服务基于Python的Django框架开发,负责处理前端请求、调用Spark任务并返回分析结果。前端界面则由Vue结合ElementUI构建,通过Echarts库将Spark计算出的统计结果,如不同性别患者的生存状态分布、各疾病分期的生存天数对比、关键生化指标的均值变化等,以交互式图表的形式直观呈现。系统不仅涵盖了基础的人口学特征与临床体征分析,还实现了Kaplan-Meier生存曲线的绘制,能够动态展示不同治疗方案或疾病分期下患者的生存概率变化,为理解肝硬化疾病的进展规律和影响因素提供了数据驱动的可视化支持。

二
肝硬化患者生存预测数据可视化分析系统-背景

肝硬化作为一种常见的慢性进行性肝病,其病情发展复杂,患者的生存情况受到多种因素交织影响。在临床实践中,医生和研究人员会积累大量的患者数据,这些数据包含了人口学信息、临床体征、生化指标及治疗记录等宝贵信息。然而,这些数据往往以表格形式存在,维度多、体量大,单纯依靠人工或传统工具进行梳理和分析,不仅效率低下,而且难以发现隐藏在数据背后的深层关联和规律。如何有效利用这些沉睡的数据,将其转化为直观易懂的洞见,辅助临床决策和疾病研究,成为了一个亟待解决的实际问题。这便是本课题的出发点,希望通过技术手段为医疗数据分析提供一种新的视角和工具。

本课题的意义体现在几个层面。对于即将毕业的计算机专业学生而言,它提供了一个完整实践大数据技术栈的机会,从Hadoop存储到Spark计算,再到前后端可视化,整个流程能很好地锻炼工程能力和项目思维。对导师来说,这是一个结构清晰、技术路线明确的课题,能够体现学生对数据处理和分析的理解。从更实际的角度看,这个系统可以作为一个辅助分析工具,帮助医学研究者快速地从宏观上把握肝硬化患者群体的特征分布和生存趋势,虽然它不能替代专业的统计软件,但其直观的可视化界面能为后续更深入的科学研究提供初步的探索方向和假设验证的思路。它更像是一个桥梁,连接了复杂的数据和需要洞见的人

三
肝硬化患者生存预测数据可视化分析系统-技术框架展示

开发语言:Python或Java

大数据框架:Hadoop+Spark(本次没用Hive,支持定制)

后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)

前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery

详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy

数据库:MySQL

四
肝硬化患者生存预测数据可视化分析系统-视频展示
已关注
关注
重播 分享 赞
【解决方案】从数据采集到可视化:Spark肝硬化预测系统全流程实现
五
肝硬化患者生存预测数据可视化分析系统-图片展示
六
肝硬化患者生存预测数据可视化分析系统-代码展示
from pyspark.sql import SparkSession, functions as Fspark = SparkSession.builder.appName("CirrhosisAnalysis").getOrCreate()# 核心功能1:按治疗方案分组的Kaplan-Meier生存曲线数据准备def kaplan_meier_data_by_drug():    df = spark.read.csv("cirrhosis_processed.csv", header=True, inferSchema=True)    # 将生存状态转换为事件指示器(1表示事件发生,如死亡;0表示删失)    df_km = df.withColumn("Event", F.when(df["Status"] == "D", 1).otherwise(0))    # 按药物分组,计算每个时间点的生存人数和事件发生人数    km_data = df_km.groupBy("Drug", "N_Days").agg(        F.sum("Event").alias("Events"),        F.count("*").alias("At_Risk")    ).orderBy("Drug", "N_Days")    # 计算生存概率,这里简化处理,实际KM曲线需要更复杂的窗口函数计算累积生存率    # 返回数据供前端绘制曲线    return km_data.collect()# 核心功能2:不同疾病分期下,男女患者的平均胆红素水平对比def bilirubin_by_stage_sex():    df = spark.read.csv("cirrhosis_processed.csv", header=True, inferSchema=True)    # 按疾病分期和性别分组,计算胆红素的平均值    result = df.groupBy("Stage", "Sex").agg(        F.round(F.avg("Bilirubin"), 2).alias("Avg_Bilirubin")    ).orderBy("Stage", "Sex")    # 将结果转换为前端易于处理的格式,例如按分期为键,性别为值的字典    collected_data = result.collect()    return collected_data# 核心功能3:关键生化指标在不同生存状态下的均值对比分析def biochem_by_status():    df = spark.read.csv("cirrhosis_processed.csv", header=True, inferSchema=True)    # 筛选出生存状态为死亡(D)和存活(C)的患者    filtered_df = df.filter((df["Status"] == "D") | (df["Status"] == "C"))    # 按生存状态分组,计算多个关键生化指标的平均值    biochem_avg = filtered_df.groupBy("Status").agg(        F.round(F.avg("Bilirubin"), 2).alias("Avg_Bilirubin"),        F.round(F.avg("Albumin"), 2).alias("Avg_Albumin"),        F.round(F.avg("Copper"), 2).alias("Avg_Copper"),        F.round(F.avg("Prothrombin"), 2).alias("Avg_Prothrombin")    ).orderBy("Status")    # 返回聚合后的结果,用于前端图表展示    return biochem_avg.collect()
七
联系我们
扫码关注我们
商务合作
公众号:计算机编程指导师

~~感谢您抽出宝贵时间来阅读此文~~

最新文章

随机文章