在我们日的运维中,对数据,尤其是日志文件进行去重、筛重是日常的基本操作。Linux 自带的 uniq 命令轻量高效,配合 sort 就能搞定绝大多数文本去重场景。
今天我撰写一篇uniq的文章:主要描述它能干什么、怎么用、常见参数、实战案例、必知坑点,看你就可以直接上手练习了。
一、uniq简介
uniq = unique,其主要作用是:删除/报告连续重复行。
知识点:默认只处理相邻重复行,不相邻的重复行会被漏掉。
所以一般的用法是:先排序、再去重。
适用场景:
日志IP/用户去重统计
名单去重、找重复项
统计词频/访问次数
清洗导出数据
找最大的文件
二、基本语法与常用参数
基本语法
6个常用参数
-c:统计重复次数(最常用)
-d:只显示重复行(出现≥2次)
-u:只显示唯一行(出现=1次)
-i:忽略大小写
-f N:跳过前 N 个字段(按列去重)
-s N:跳过前 N 个字符
三、基础使用演示
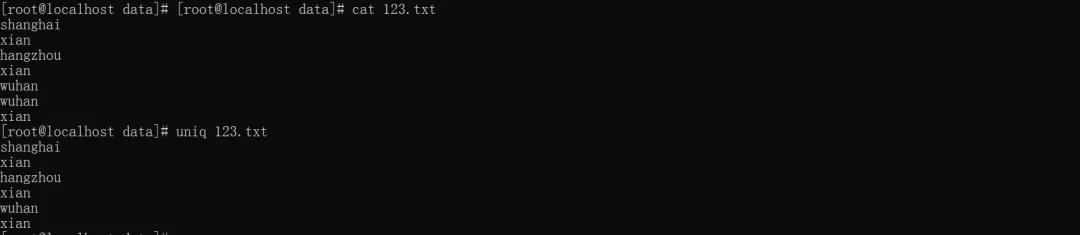
1)基础去重
只保留连续重复行的第一条。
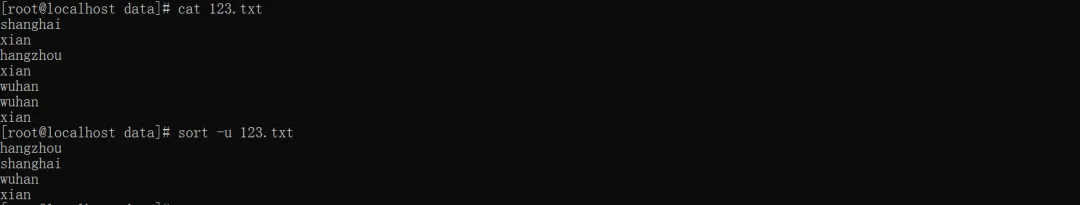
uniq 123.txt #只对相邻的数据进行去重
sort 123 |uniq #常规用法,先排序,再去重

2)统计出现次数
一般在日志分析、访问统计必备。
sort 123 |uniq -c #统计出现的次数
就会出现xian出现了3次,wuhan出现了2次。
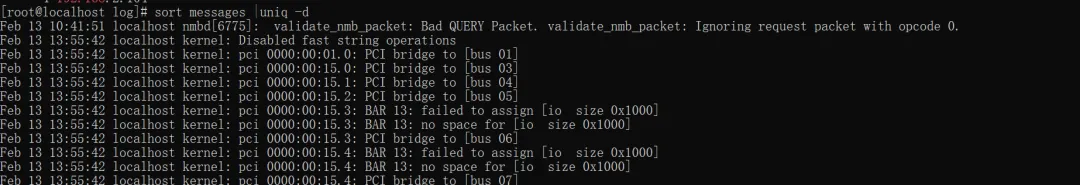
3)只看重复行
快速定位脏数据、重复录入。
sort 123.txt |uniq -d #只统计出现的重复的记录
4)只看唯一行
筛选只出现一次的记录。
sort 123.txt |uniq -u #只统计出现一次的记录

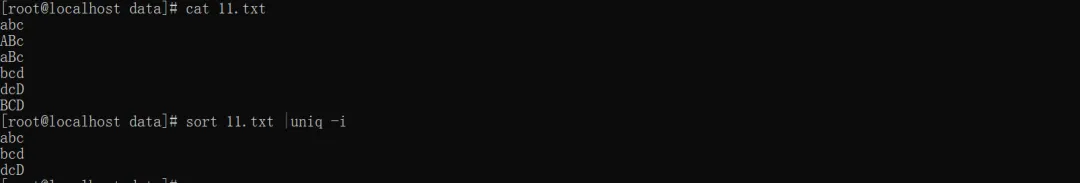
5)忽略大小写
sort 11.txt |uniq -i #忽略大小写进行统计
6)按字段/字符去重
日志、CSV 按列去重超实用。
sort 12.txt |uniq -f 1 #跳过第一字段进行去重
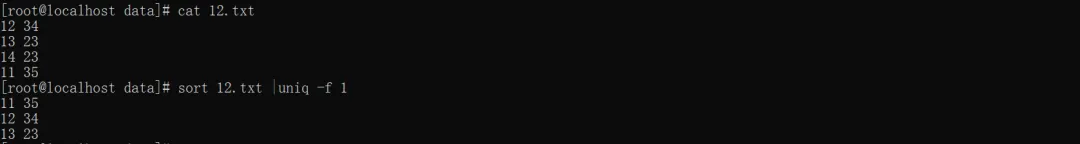
按照第二个字段进行去重,最终输出整行。
sort 12.txt |uniq -s 1 #跳过第一字段进行去重
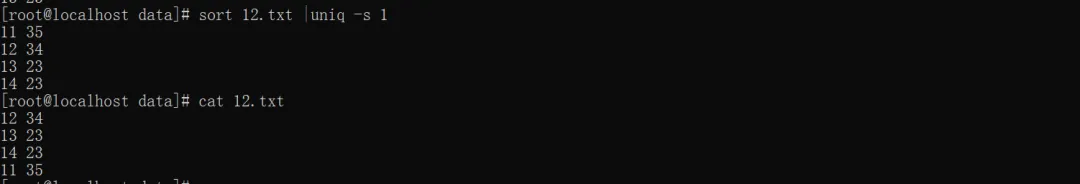
跳过第一字符后,第一行变成了2,3,4,1。
四、实战用法
情况1:统计访问 192.168段访问最多的IP
cat messages|awk '{print $11}'|sort|uniq -c |sort -nr |grep 192.168
- awk 取IP列
- sort 排序
- uniq -c 统计
- sort -nr 倒序排次数
情况2:找出重复记录
sort message |uniq -d #找出message中重复的记录
情况3:去重并写入新文件

情况4:一键去重
五、注意事项
不能不排序就用 uniq ,这样不能进行有效去重,uniq 只处理相邻重复,必须先 sort。
-d 只输出重复组的第一条,想看全部重复行用 -D。
空格/制表符会影响判断,必要时先 tr 缩空格、sed 清洗。
大小写敏感,不区分大小写加 -i。
六、一张表速查
七、写到最后
uniq 是 Linux 文本处理轻量利器,它不管能处理日志,处理excel也非常有用。使用需要记住规则:先排序,再去重;-c 统计、-d 查重、-u 查唯一。
现在就可以试试uniq去重功能了。欢迎评论区分享遇到的uniq新鲜用法。