在Python开发中,数据格式混乱、类型不匹配、参数校验繁琐,一直是困扰开发者的痛点。手写一堆if-else判断、try-except捕获异常,不仅代码臃肿冗余,还极易遗漏校验逻辑,埋下数据安全隐患。而Pydantic作为Python生态最主流的数据验证与设置管理库,凭借“类型提示驱动、高性能、易上手、强兼容”的特性,彻底解决了数据校验难题,成为FastAPI、LangChain、HuggingFace等热门框架的底层依赖,每月下载量超7000万次,大厂项目几乎标配。
今天就带大家全面拆解Pydantic,从基础安装、核心用法,到进阶特性、实战场景,帮你快速掌握这款Python数据处理利器,告别低效手写校验!
一、初识Pydantic:是什么?为什么选它?
1. 核心定义
Pydantic是一个基于Python类型注解(Type Hints)的数据验证与序列化库,核心作用是定义结构化数据模型,自动完成数据类型校验、格式转换、异常抛出,同时支持模型与字典、JSON等格式的互转,让数据处理更规范、更安全。
2. 核心优势
极简上手:依托Python原生类型提示,无需学习额外语法,定义模型即完成校验规则,学习成本极低;
高性能:V2版本核心校验逻辑采用Rust重写,速度较V1版本提升5-50倍,远超同类数据校验库;
智能转换:自动兼容类型转换(如字符串转日期、数字),同时支持严格模式,杜绝无效数据混入;
功能丰富:支持嵌套模型、自定义校验、别名映射、配置加载、JSON Schema生成等进阶能力;
生态完善:无缝适配FastAPI、Django、Flask等主流框架,覆盖接口开发、配置管理、数据清洗等全场景。
3. 快速安装
安装方式超简单,直接通过pip命令安装即可,默认安装最新V2版本:
二、Pydantic核心用法:零基础也能快速上手
Pydantic的核心是BaseModel,所有数据模型都需要继承该基类,通过类属性定义字段类型、默认值、约束条件,实例化时自动触发校验。
1. 基础模型定义与使用
先看一个最简单的示例,定义用户数据模型,实现基础的类型校验:
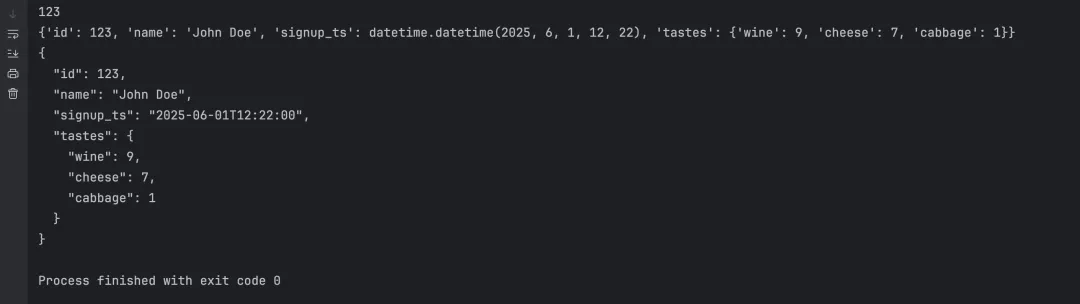
from datetime import datetimefrom pydantic import BaseModel, PositiveInt# 定义用户数据模型class User(BaseModel): # 必填字段,类型为整数 id: int # 可选字段,带默认值 name: str = "John Doe" # 可选字段,可为空 signup_ts: datetime | None # 字典类型,值为正整数 tastes: dict[str, PositiveInt]# 模拟外部传入的非规范数据external_data = { "id": 123, "signup_ts": "2025-06-01 12:22", "tastes": { "wine": 9, b"cheese": 7, "cabbage": "1", },}# 实例化模型,自动完成校验与类型转换user = User(**external_data)# 访问模型属性print(user.id) # 输出:123# 模型转字典print(user.model_dump())# 模型转JSON字符串print(user.model_dump_json(indent=2))
运行代码后会发现,Pydantic自动完成了多项处理:字符串格式的时间转为datetime对象、字节串key转为字符串、字符串数字转为正整数,完全无需手动转换。
2. 字段约束:精准控制数据格式
仅靠基础类型校验远远不够,Pydantic提供Field函数,可对字段添加长度、范围、正则、描述等约束,实现更精细化的校验:
from pydantic import BaseModel, Field, EmailStrfrom typing import Literalclass Product(BaseModel): # 产品名称:必填,长度1-100 name: str = Field(..., min_length=1, max_length=100, description="产品名称") # 产品价格:必填,大于0 price: float = Field(..., gt=0, description="产品价格,必须大于0") # 产品分类:默认空列表,避免可变默认值陷阱 categories: list[str] = Field(default_factory=list) # 产品状态:仅支持指定枚举值 status: Literal["available", "out_of_stock"] = "available" # 邮箱:自动校验邮箱格式 contact_email: EmailStr | None = None# 合法数据实例化product = Product( name="笔记本电脑", price=5999.99, categories=["电子产品", "电脑"], contact_email="test@163.com")print(product)# 非法数据会抛出ValidationError,精准提示错误try: invalid_product = Product(name="", price=-100, contact_email="invalid-email")except Exception as e: print(e.errors())
Field常用约束参数:
gt/ge/lt/le:数值大于/大于等于/小于/小于等于;
min_length/max_length:字符串长度限制;
regex:正则表达式校验;
default/default_factory:设置默认值,可变类型推荐用default_factory;
alias:字段别名,适配外部驼峰命名等格式;
description:字段描述,用于文档生成。
3. 错误处理:清晰定位数据问题
当数据不符合模型约束时,Pydantic会抛出ValidationError异常,异常信息包含错误类型、错误位置、错误提示,精准定位问题,无需逐行排查:
from pydantic import BaseModel, ValidationErrorclass User(BaseModel): id: int age: int = Field(ge=18, le=60)try: # 传入非法数据:id为字符串,年龄超出范围 User(id="abc", age=17)except ValidationError as e: # 打印结构化错误信息 print("错误详情:") for err in e.errors(): print(f"字段:{err['loc']},类型:{err['type']},提示:{err['msg']}")
三、Pydantic进阶特性:解锁高阶开发能力
1. 嵌套模型:处理复杂数据结构
实际开发中数据往往是多层嵌套的,Pydantic完美支持嵌套模型,实现复杂结构的全链路校验:
from pydantic import BaseModel# 地址子模型class Address(BaseModel): city: str zip_code: str detail: str | None = None# 用户主模型,嵌套地址模型class User(BaseModel): id: int name: str address: Address# 嵌套数据实例化user_data = { "id": 1, "name": "张三", "address": { "city": "北京", "zip_code": "100000", "detail": "朝阳区XX街道" }}user = User(**user_data)print(user.address.city) # 输出:北京
2. 自定义校验器:适配业务规则
内置校验无法满足复杂业务需求时,可通过field_validator(字段级)和model_validator(模型级)自定义校验逻辑,实现个性化校验:
from pydantic import BaseModel, field_validator, model_validatorclass Order(BaseModel): order_id: str price: float num: int total_price: float # 字段级校验:商品数量必须大于0 @field_validator("num") def num_must_positive(cls, v): if v <= 0: raise ValueError("商品数量必须大于0") return v # 模型级校验:总价=单价*数量 @model_validator(mode="after") def check_total_price(self): if self.total_price != self.price * self.num: raise ValueError("总价计算错误") return self# 测试校验try: Order(order_id="OD001", price=10, num=2, total_price=30)except ValidationError as e: print(e.errors())
3. 配置管理:加载环境变量与配置文件
Pydantic可轻松加载.env环境变量、JSON/YAML配置文件,实现项目配置的统一管理与校验,替代繁琐的配置读取逻辑:
from pydantic_settings import BaseSettings, SettingsConfigDict# 配置模型,继承BaseSettingsclass AppSettings(BaseSettings): # 配置来源:.env文件 model_config = SettingsConfigDict(env_file=".env", env_file_encoding="utf-8") app_name: str = "MyApp" host: str port: int debug: bool = False# 加载配置settings = AppSettings()print(settings.host, settings.port)
注意:需额外安装依赖:pip install pydantic-settings
4. 模型序列化:灵活导出数据
Pydantic提供丰富的序列化方法,支持模型按需转为字典、JSON,可排除敏感字段、仅导出非默认值,适配接口响应、数据存储等场景:
from pydantic import BaseModel, Fieldclass User(BaseModel): id: int name: str password: str = Field(exclude=True) # 序列化时排除敏感字段 age: int | None = Noneuser = User(id=1, name="张三", password="123456", age=None)# 转字典,排除空值print(user.model_dump(exclude_none=True))# 转JSON字符串print(user.model_dump_json(exclude={"password"}))
四、Pydantic实战场景:落地真实开发需求
Pydantic的应用场景覆盖Python开发全流程,以下是最核心的4大实战场景,附可直接复用的代码。
1. 接口开发:FastAPI无缝集成
FastAPI框架内置Pydantic,可自动完成请求参数校验、响应数据格式化,同时生成OpenAPI接口文档,大幅提升接口开发效率:
from fastapi import FastAPIfrom pydantic import BaseModelapp = FastAPI()# 定义请求体模型class Item(BaseModel): name: str price: float description: str | None = None# 接口路由,自动校验请求参数@app.post("/items/")async def create_item(item: Item): return { "message": "商品创建成功", "item": item.model_dump() }
2. 数据清洗:批量处理脏数据
针对爬虫、Excel导入、数据库查询等场景的脏数据,用Pydantic快速完成格式校验与清洗,保证数据合规性:
from pydantic import BaseModel, PositiveIntfrom typing import List# 定义数据模型class UserData(BaseModel): user_id: PositiveInt username: str age: int | None = None# 待清洗的脏数据列表raw_data = [ {"user_id": 1, "username": "user1", "age": "20"}, {"user_id": "2", "username": "user2", "age": None}, {"user_id": -3, "username": "user3", "age": 25},]# 批量清洗数据clean_data = []for item in raw_data: try: clean_item = UserData(**item) clean_data.append(clean_item.model_dump()) except Exception: # 过滤非法数据 continueprint("清洗后有效数据:", clean_data)
3. 项目配置统一管理
替代手动读取配置文件,通过Pydantic管理数据库、缓存、第三方服务等配置,实现配置类型校验与便捷调用:
from pydantic_settings import BaseSettingsclass DbSettings(BaseSettings): db_host: str = "localhost" db_port: int = 3306 db_user: str db_password: str db_name: str# 全局配置实例db_settings = DbSettings(_env_file=".env")# 业务代码中直接使用print(f"连接数据库:{db_settings.db_host}:{db_settings.db_port}")
4. 数据传输对象(DTO)封装
在微服务、模块化开发中,用Pydantic定义DTO对象,规范模块间、服务间的数据传输格式,降低沟通成本与数据报错风险。
五、避坑指南与最佳实践
1. 常见避坑点
可变默认值陷阱:列表、字典等可变类型,禁止用default=[],必须用default_factory=list;
严格模式慎用:默认宽松模式支持兼容转换,核心数据场景建议开启strict=True,杜绝隐式转换;
字段别名冲突:使用alias时,建议开启populate_by_name,兼顾别名与原字段名赋值;
V2版本兼容:V2废弃了V1的parse_obj、dict()等方法,改用model_validate、model_dump()。
2. 最佳实践
拆分输入/输出模型,避免单模型承担过多职责,提升代码可维护性;
复杂模型采用继承、组合方式,复用校验逻辑,减少重复代码;
敏感字段通过exclude=True,避免序列化泄露;
开启extra="forbid",禁止传入未定义字段,防止脏数据侵入。
六、总结
Pydantic凭借极简的用法、强大的校验能力、完善的生态,彻底重构了Python数据处理方式,不仅解决了手写校验的低效问题,更让项目数据更规范、更安全。
无论是接口开发、配置管理,还是数据清洗、微服务交互,Pydantic都能轻松胜任,是Python开发者必备的效率工具。
建议大家立刻上手实操,把项目中的手写校验替换为Pydantic,感受极致的开发效率提升!
 10个月宝宝每天需要喝多少奶粉?