当前位置:首页>python>10分钟掌握 2026版 Python爬虫实战

10分钟掌握 2026版 Python爬虫实战

  • 2026-09-10 11:42:42
10分钟掌握 2026版 Python爬虫实战

概述

学完理论,是时候来真的了!这章直接上实战——批量下载全网美图,再把豆瓣电影Top250的数据“扒”下来,让你亲手把学到的爬虫技能用起来~

爬虫应用实战

(一)批量爬取下载网络图片

知识点:

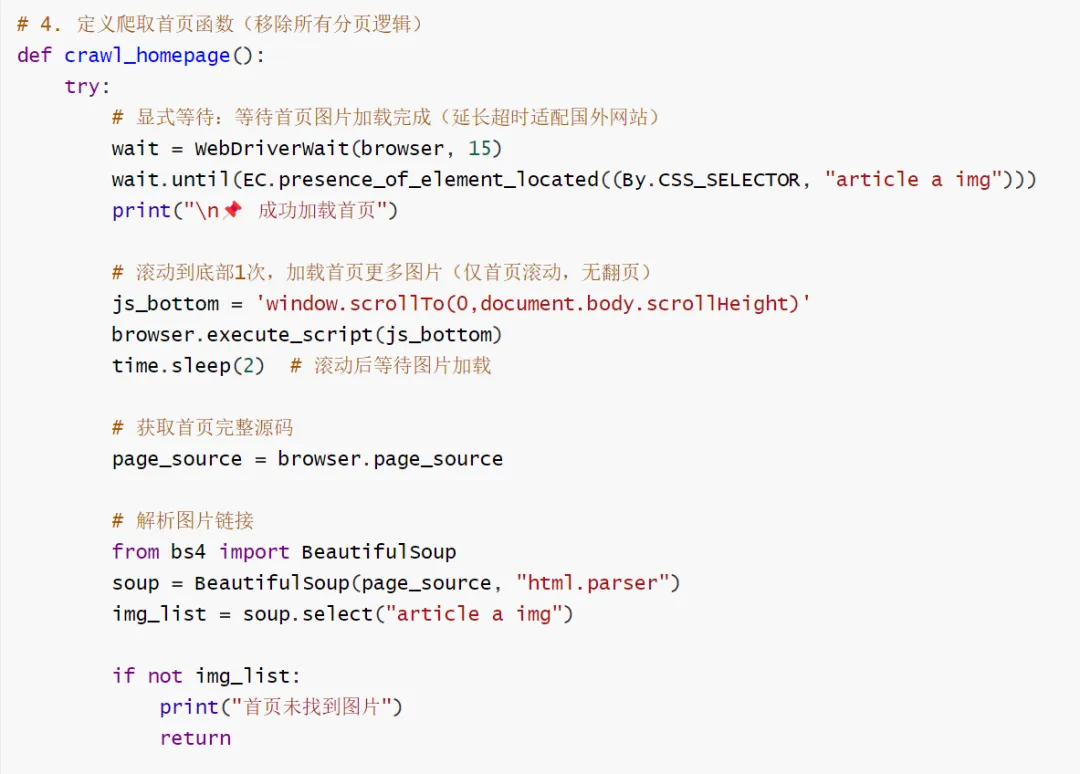
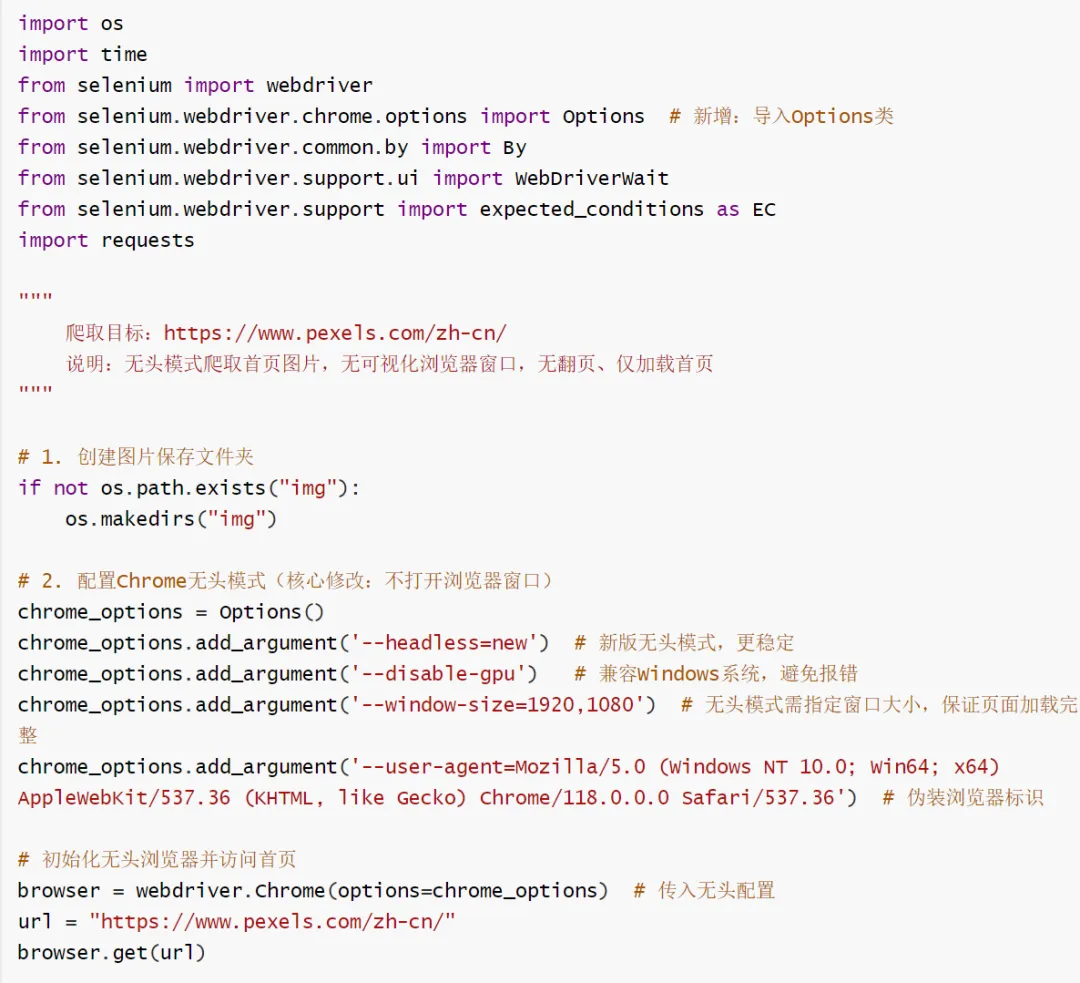
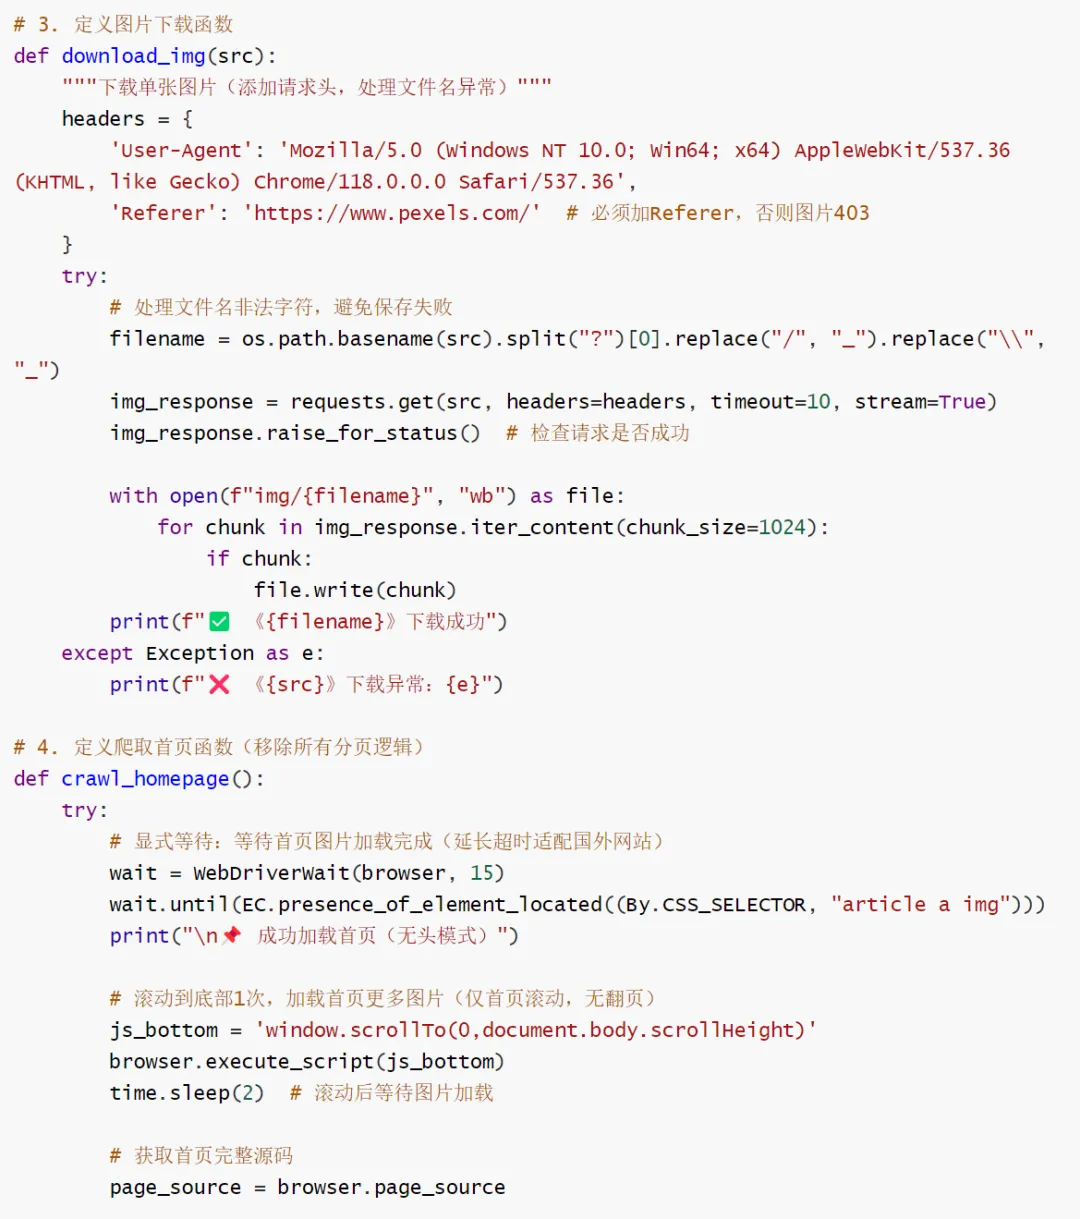
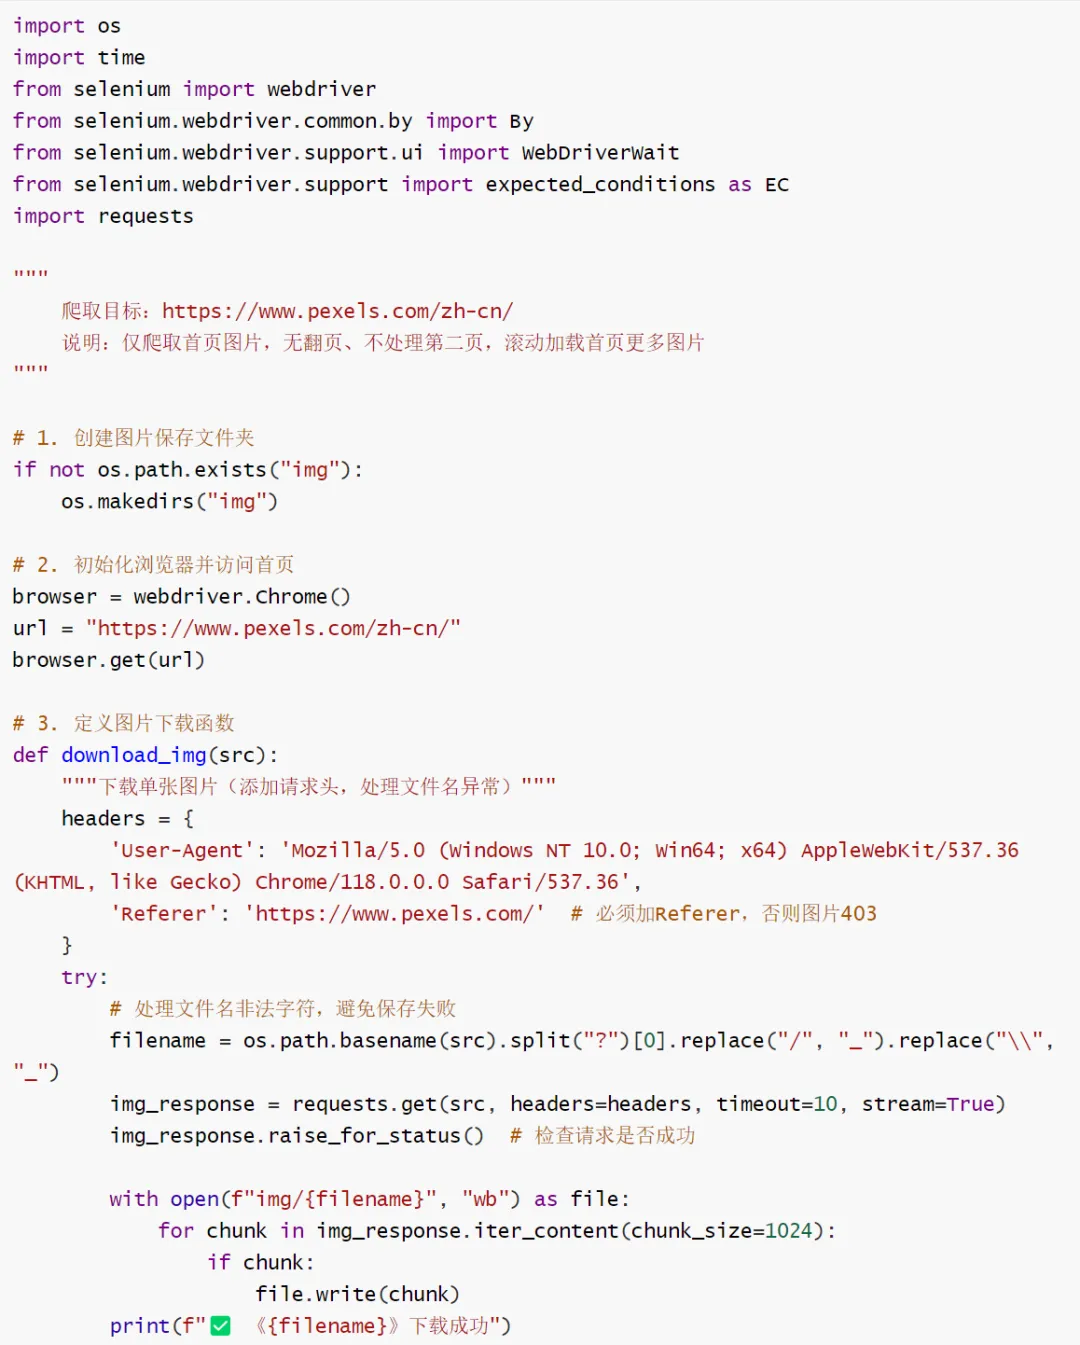
  1. 文件系统操作:使用os.path.exists判断文件夹是否存在,os.makedirs创建图片保存文件夹,处理文件存储的基础路径问题;通过os.path.basename提取图片 URL 中的文件名,并替换非法字符(/、\)避免文件保存失败。

  2. Selenium 浏览器驱动使用:初始化 Chrome 浏览器实例,通过browser.get访问目标网页;利用browser.quit关闭浏览器,通过try-finally保证浏览器无论爬取成败都能正常关闭。

  3. Selenium 显式等待机制:使用WebDriverWait结合EC.presence_of_element_located等待页面图片元素加载完成,设置超时时间适配国外网站加载慢的场景,避免提前解析空页面。

  4. JavaScript 脚本执行:通过browser.execute_script执行滚动页面的 JS 代码(window.scrollTo),实现页面滚动加载更多图片,模拟用户浏览行为。

  5. Requests 库网络请求:使用requests.get发起图片下载请求,设置timeout避免请求超时,通过stream=True流式下载图片并分块写入文件(iter_content),降低内存占用;配置User-Agent、Referer请求头伪装浏览器,规避图片链接 403 错误;通过raise_for_status检查请求状态码,捕获 4xx/5xx 请求错误。

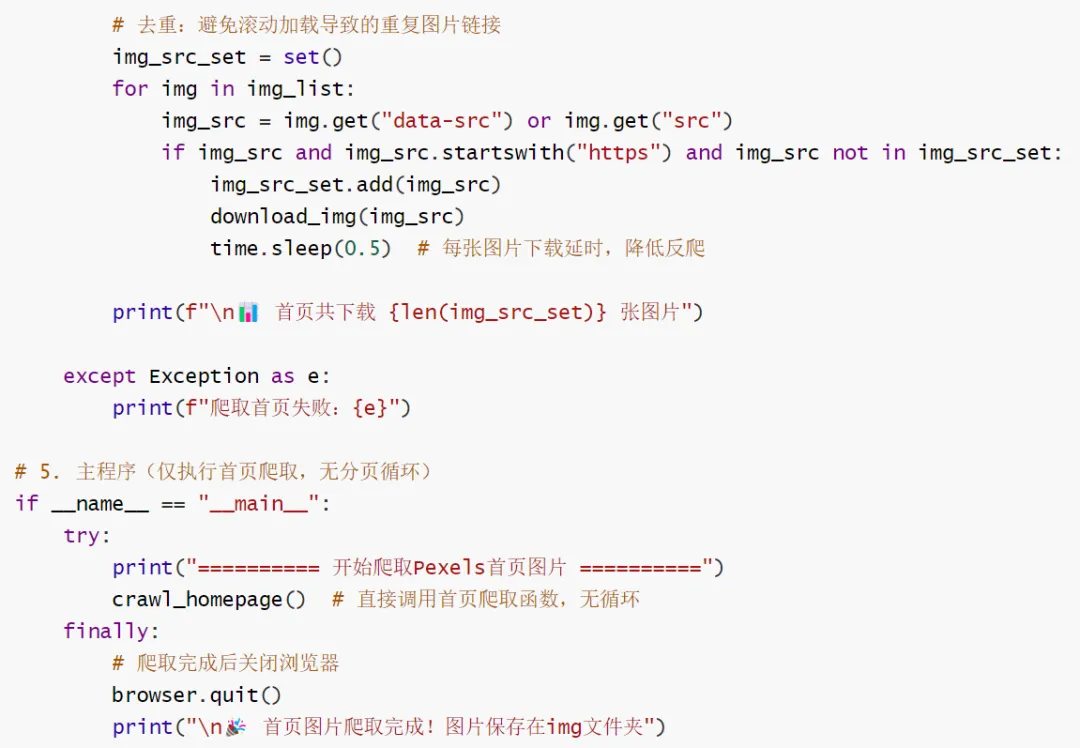
  6. 异常处理:使用try-except捕获图片下载、页面解析过程中的异常,打印错误信息且不中断整体爬取流程;主程序通过try-finally保证浏览器资源释放。

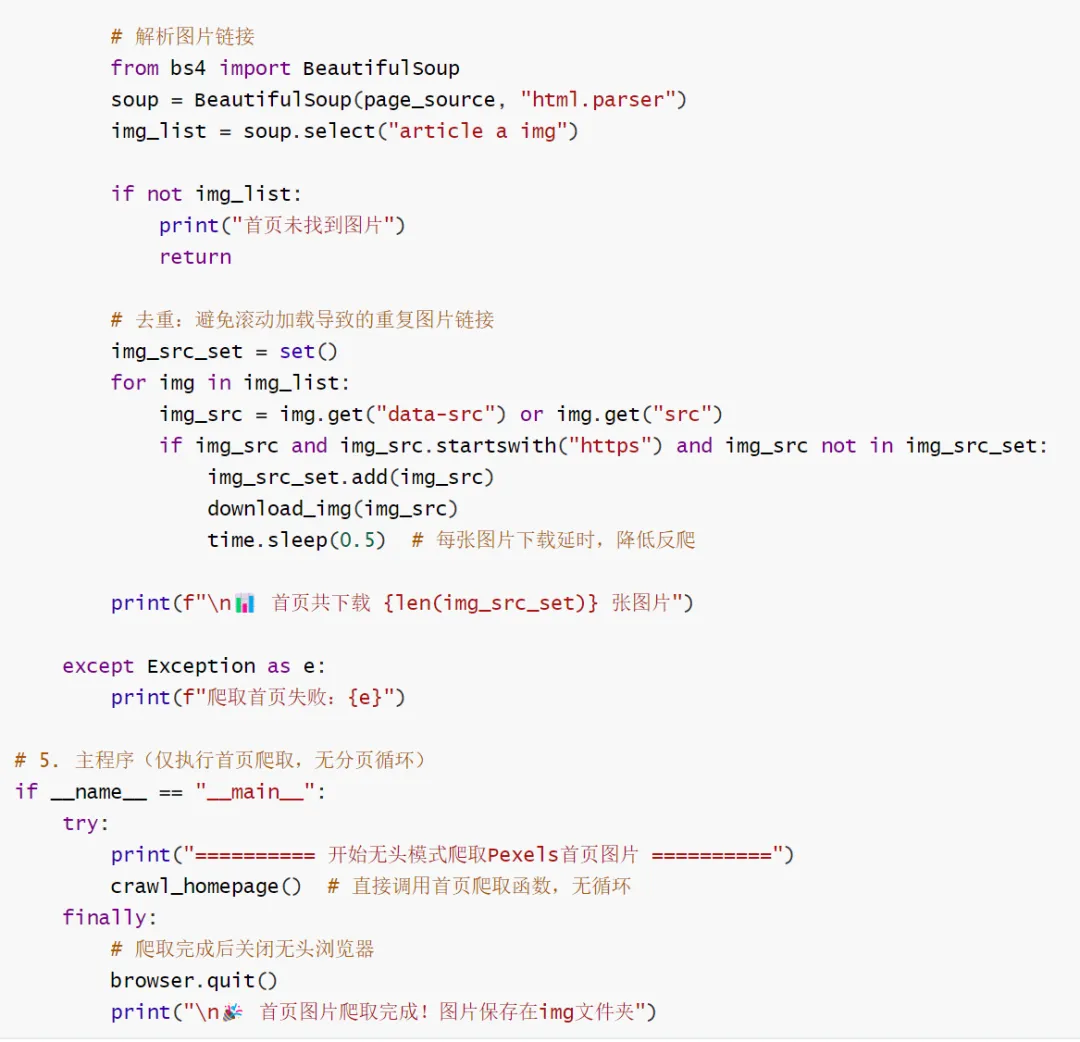
  7. BeautifulSoup 页面解析:利用BeautifulSoup解析浏览器渲染后的页面源码,通过 CSS 选择器(select/select_one)定位图片元素,优先提取data-src(懒加载高清链接),无则取src。

  8. 数据去重:使用集合(set)存储图片链接,避免滚动加载导致的重复图片下载,保证下载的图片唯一性。

  9. 反爬策略规避:设置time.sleep在图片下载、页面滚动后添加延时,降低请求频率;伪装请求头模拟真实浏览器行为,减少被网站反爬机制识别的概率。

  10. 函数封装与代码结构:将图片下载、首页爬取逻辑封装为独立函数,提升代码可读性和复用性;主程序仅调用核心爬取函数,无冗余分页逻辑,专注处理首页爬取。
有痕模式(浏览器驱动会打开浏览器)

无痕模式(浏览器驱动不会打开浏览器)

(二)批量爬取豆瓣电影排行信息

知识点:

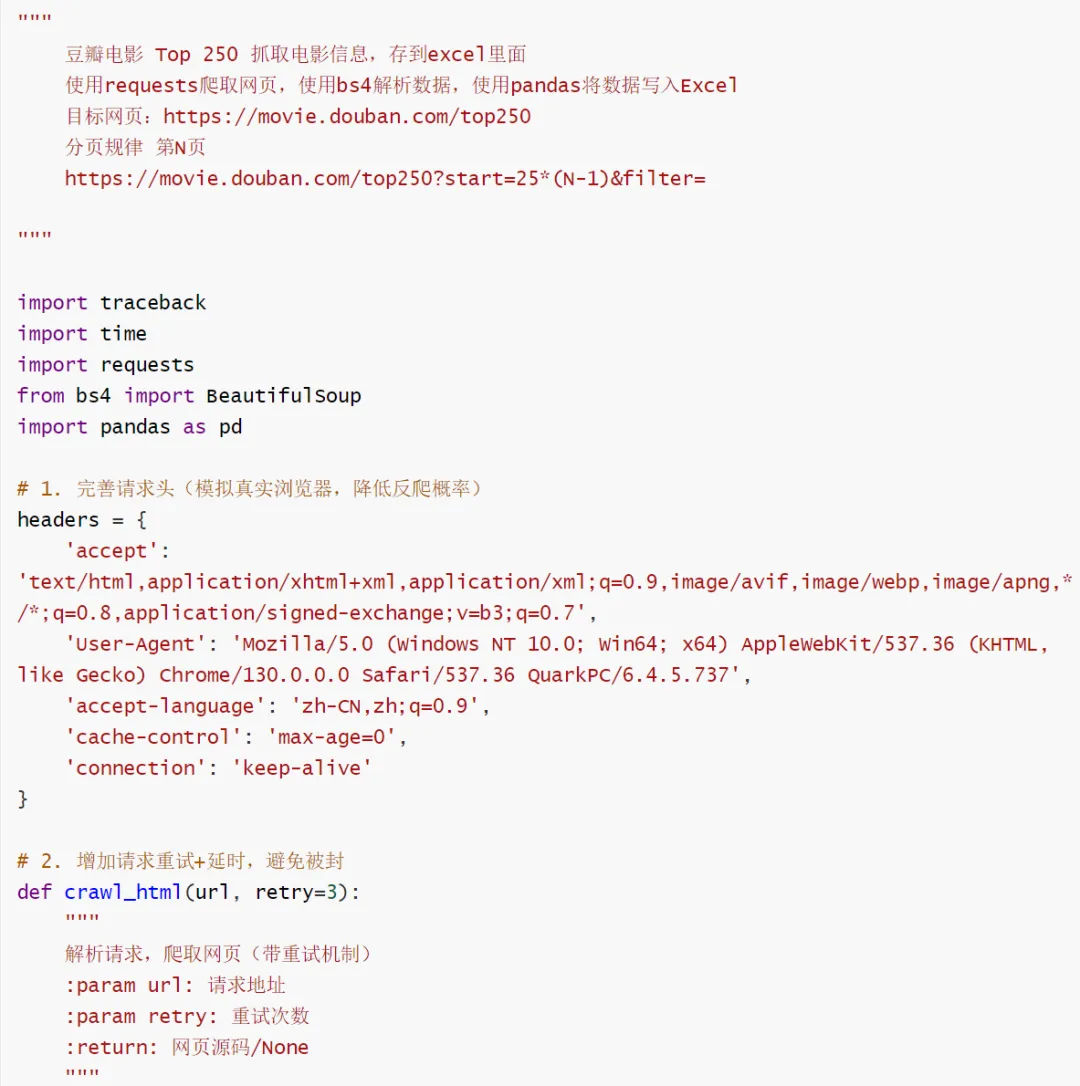
  1. 爬虫请求头优化配置:配置包含accept、User-Agent、accept-language等字段的完整请求头,模拟真实浏览器的请求特征,降低被网站反爬机制识别的概率。

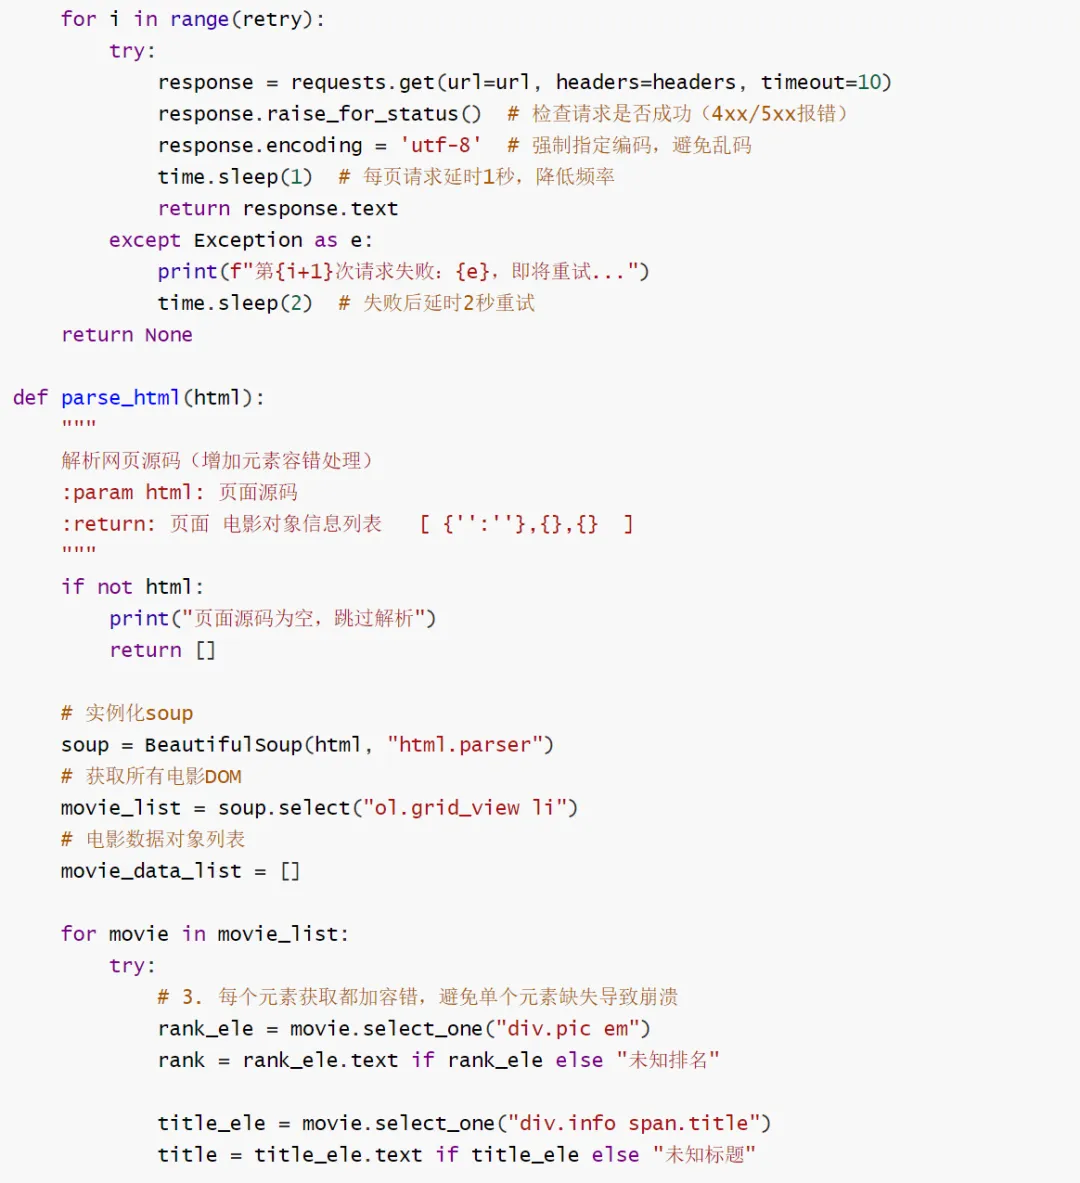
  2. 带重试与延时的网页请求:自定义crawl_html函数实现请求重试机制(最多 3 次重试),结合time.sleep设置请求 / 分页延时,避免请求频率过高触发反爬;使用requests.get发起 GET 请求,设置timeout控制请求超时,通过response.raise_for_status()检查请求状态码(捕获 4xx/5xx 错误),强制指定utf-8编码解决页面源码乱码问题。

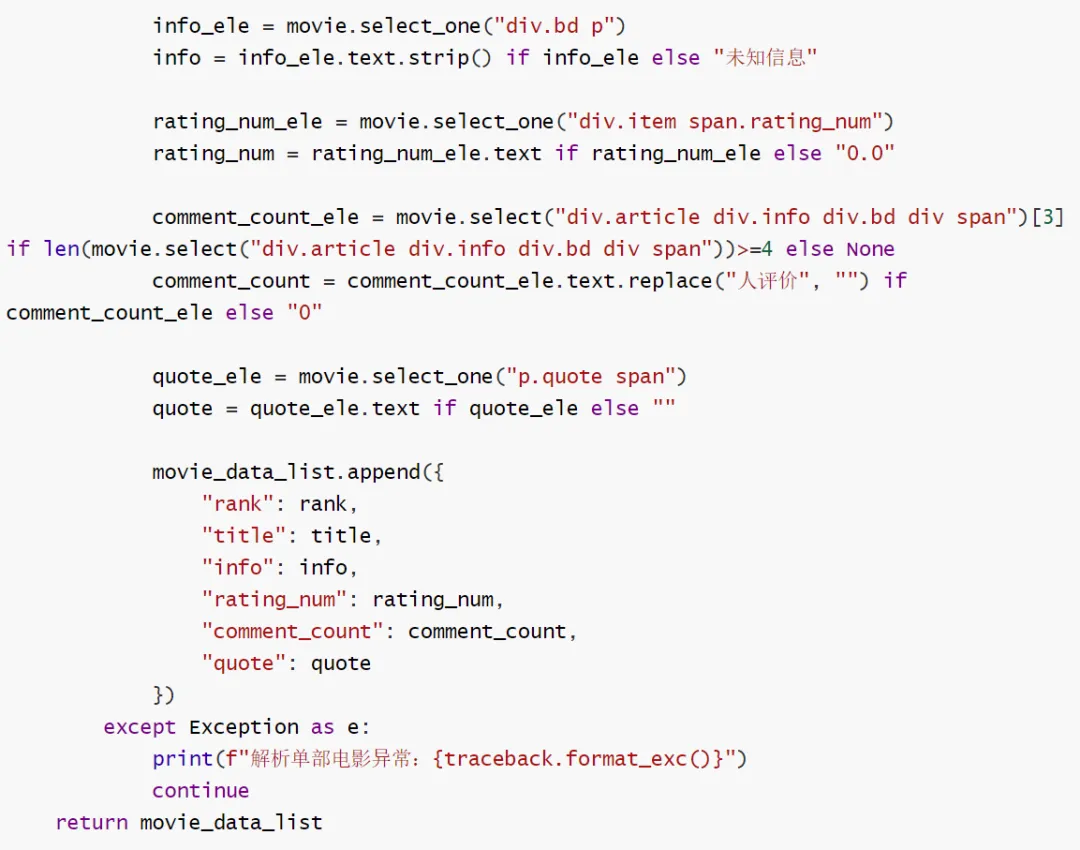
  3. 容错式网页源码解析:使用BeautifulSoup结合html.parser解析器解析页面源码,通过select/select_one方法基于 CSS 选择器定位 DOM 元素;对每个目标元素先判断是否为None,再提取text属性,避免NoneType对象无text属性的报错;通过try-except捕获单部电影解析异常并跳过,保证整体爬取流程不中断。

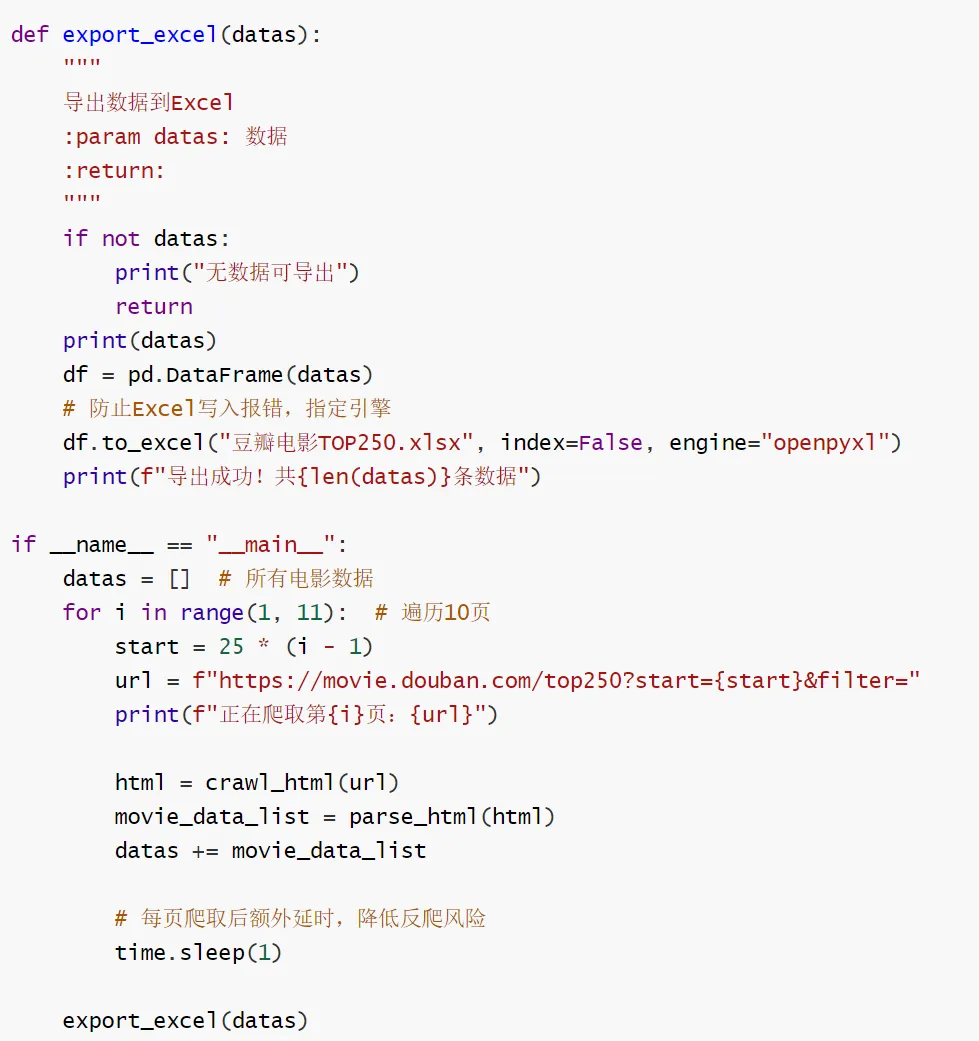
  4. 分页爬取逻辑实现:利用豆瓣电影 Top250 的分页规律(start=25*(N-1)),循环遍历 10 页构造分页 URL,累计收集所有页面的电影数据。

  5. 结构化数据处理与 Excel 导出:将解析后的电影信息封装为字典列表,通过pandas.DataFrame将结构化数据转换为 DataFrame;指定openpyxl引擎将数据导出为 Excel 文件,设置index=False去除默认索引列,导出前判断数据是否为空,避免无数据导出的异常。

  6. 异常捕获与调试优化:使用traceback模块打印详细的异常堆栈信息,便于定位解析错误;在关键节点打印爬取进度、请求失败信息、导出结果等,提升代码的可调试性。

  7. 反爬策略规避:通过请求头伪装、请求延时控制、请求重试机制等组合手段,降低被豆瓣反爬机制拦截的概率,提升爬虫的稳定性。

结束语

1

后续我会持续输出优质、实用的内容,也欢迎大家在评论区留言,说说你们最想学习的内容、遇到的困惑,我们一起交流、一起进步。

愿每一位软件人,都能在这里收获知识、突破自我,在自己的赛道上发光发热✨

以上内容仅做学习所用,如有侵权联系必删

最新文章

随机文章