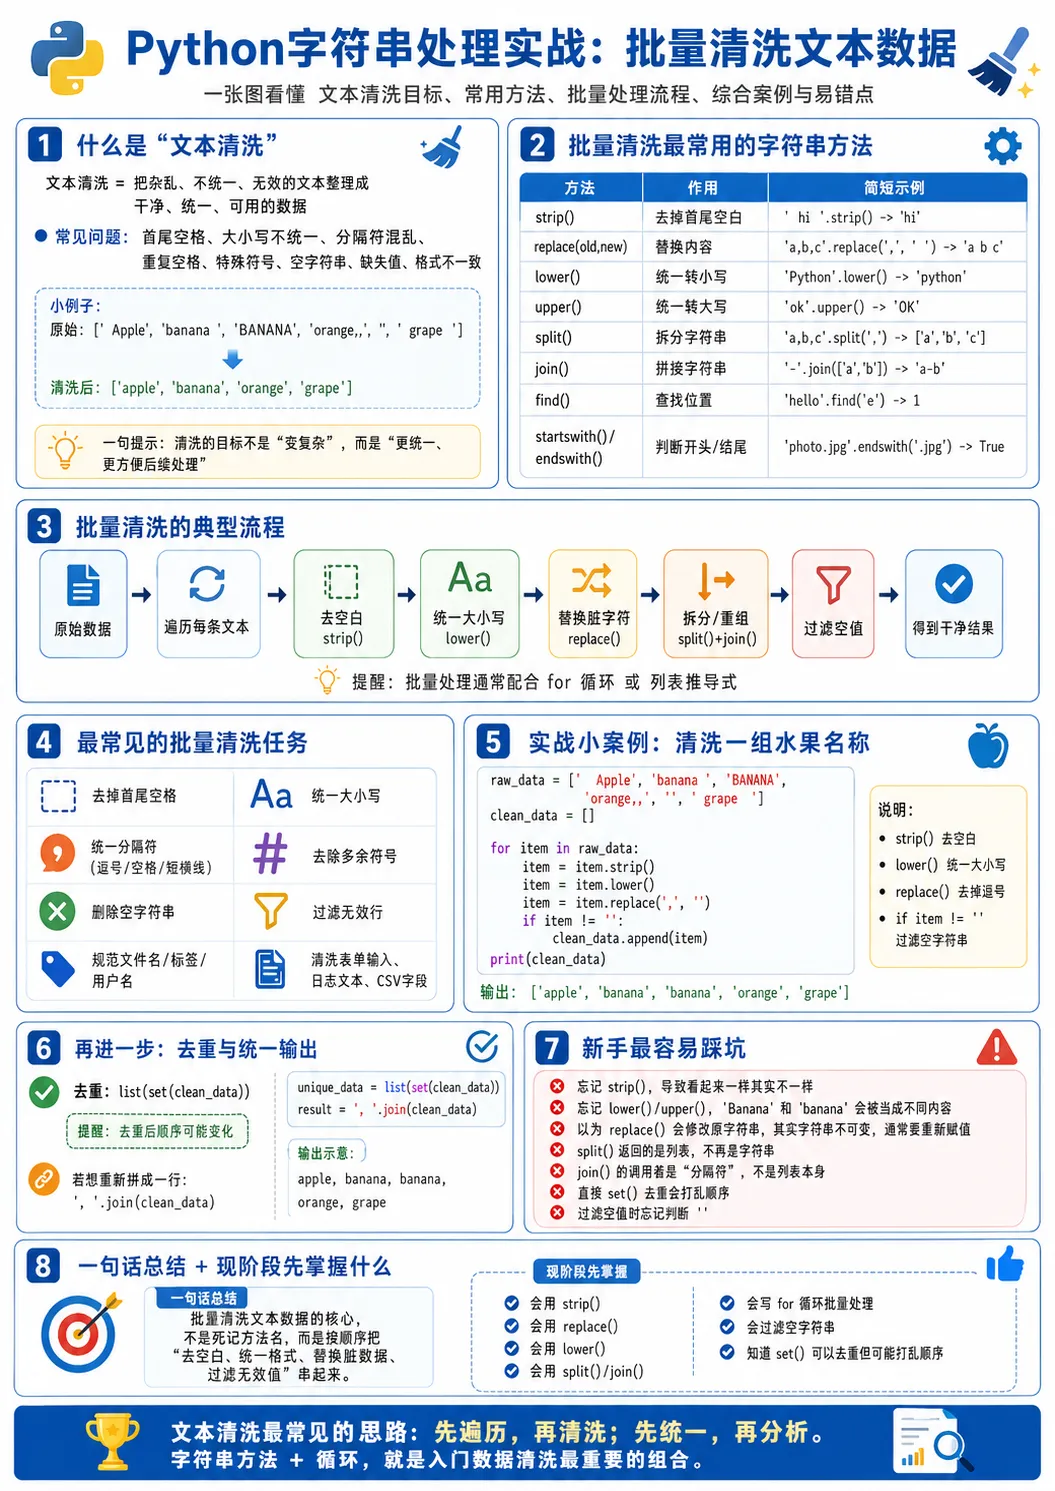
前面几章,我们已经把字符串里最核心的一批工具都学过了。
会切片 会查找 会替换 会拆分 会拼接 会去掉空格 会做格式化 也知道了编码和路径这些常见坑
但很多同学学到这里,还是会有一个很真实的问题:
单个知识点我都懂,可一碰到真实数据,还是不知道从哪下手。
这太正常了。
因为真实世界里的文本数据,往往不是干干净净摆在你面前的。 它们更常见的样子是:
前后带空格 分隔符不统一 大小写乱七八糟 中间夹着无用字符 一行里塞着多个字段 同一批数据格式还不完全一样
而所谓字符串处理实战,本质上做的就是一件事:
把脏兮兮、不规整、难直接使用的文本,整理成程序更容易处理的样子
这一章,我们就不再零散讲某一个方法。 我们来真正做几组接近实际场景的文本清洗案例,把前面学过的字符串知识,真正用起来。
一、什么叫文本清洗
先别把这个词想得太高深。
文本清洗,说白了就是:
把原本乱糟糟的文本,处理成整齐、统一、可继续使用的文本或结构化数据。
比如下面这些,都属于文本清洗:
去掉前后空格 把多个空格变规范 把逗号、分号、竖线这些分隔符统一 把大小写统一 删除多余字符 拆出姓名、年龄、城市 把一批原始文本变成列表或字典
你以后做表格处理、日志分析、爬虫、接口、自动化办公,几乎都会遇到这个过程。
所以文本清洗不是某个冷门技巧。 它是非常典型、非常高频的基础能力。
二、清洗数据时,先别急着写代码
这是个特别重要的习惯。
很多新手一拿到一段文本,就开始直接敲。 结果写着写着越来越乱。
更稳的做法是先想清楚三件事:
原始数据现在长什么样 我最终想把它变成什么样 中间需要经过哪些处理步骤
比如现在有这样一条数据:
text = ' 张三 , 18 , 北京 '
你想把它变成:
['张三', '18', '北京']
那处理步骤大概率就是:
先去掉整体两边空格 再按逗号拆开 再把每一项两边空格去掉
你看,一旦步骤想清楚了,代码其实就没那么吓人。
所以文本清洗很多时候难的不是语法, 而是你能不能先把处理流程看出来。
三、案例一:清洗一条最基础的用户信息
我们先从最简单的一条数据开始。
原始数据:
text = ' 张三 , 18 , 北京 '
目标:
['张三', '18', '北京']
第一步,先去掉整行两边的空格:
text = ' 张三 , 18 , 北京 'text = text.strip()print(text)
输出:
张三 , 18 , 北京
第二步,按逗号拆开:
parts = text.split(',')print(parts)
输出:
['张三 ', ' 18 ', ' 北京']
你会发现,虽然已经拆成三段了,但每一项两边还有空格。
所以第三步,要继续逐项清理:
clean_parts = []for item in parts: clean_parts.append(item.strip())print(clean_parts)
输出:
['张三', '18', '北京']
这就是一个非常标准的文本清洗流程。
别看它简单,后面很多更复杂的场景,骨架其实都差不多:
先观察 再拆 再逐项清 最后得到更整齐的结果
四、为什么很多清洗问题,本质上都是拆和清
你把刚才那个例子看懂之后,会发现一个很重要的规律。
大部分基础文本清洗,说到底绕不开这几步:
strip() 去边缘杂质split() 拆开字段replace() 替换脏内容lower() 或 upper() 统一大小写 循环逐项处理 必要时再拼回去
也就是说,真实数据清洗并不是在发明新语法。 而是在合理地组合前面学过的基础方法。
所以你以后遇到文本问题,先别慌。 先问自己:
这段数据是不是该先拆开 是不是两边有脏空格 是不是分隔符不统一 是不是大小写不一致 是不是有多余符号要替换
很多题一旦这样拆,难度会立刻下降。
五、案例二:批量清洗多条学生记录
现在我们把难度往上提一点。
假设有这样一批原始数据:
rows = [' 张三 , 18 , 北京 ','李四,20, 上海',' 王五, 19,深圳 ']
我们的目标是把它们都清洗成整齐的列表形式:
[ ['张三', '18', '北京'], ['李四', '20', '上海'], ['王五', '19', '深圳']]
代码可以这样写:
rows = [' 张三 , 18 , 北京 ','李四,20, 上海',' 王五, 19,深圳 ']result = []for row in rows: row = row.strip() parts = row.split(',') clean_parts = []for item in parts: clean_parts.append(item.strip()) result.append(clean_parts)print(result)
输出:
[['张三', '18', '北京'], ['李四', '20', '上海'], ['王五', '19', '深圳']]
这时候你已经开始进入真正的批量清洗了。
前面我们处理的是一条。 现在处理的是很多条。 思路并没有变,只是外面多套了一层循环。
这就是编程特别有意思的地方。
单条逻辑一旦写顺, 加上循环,就能从处理一个,变成处理一批。
六、把清洗后的数据变成更像业务数据的结构
前面的结果虽然已经整齐了,但还是列表套列表。
如果你后面想更自然地使用它, 把它转成字典往往会更舒服。
比如我们希望最终结果变成这样:
[ {'name': '张三', 'age': '18', 'city': '北京'}, {'name': '李四', 'age': '20', 'city': '上海'}, {'name': '王五', 'age': '19', 'city': '深圳'}]
代码可以这样写:
rows = [' 张三 , 18 , 北京 ','李四,20, 上海',' 王五, 19,深圳 ']students = []for row in rows: row = row.strip() parts = row.split(',') clean_parts = []for item in parts: clean_parts.append(item.strip()) student = {'name': clean_parts[0],'age': clean_parts[1],'city': clean_parts[2] } students.append(student)print(students)
这一步非常关键。
因为真实开发里,文本清洗的最终目的,往往不是把文本变好看, 而是把文本变成程序后面好处理的数据结构。
这才是清洗真正的价值。
七、案例三:统一大小写,处理不规范英文数据
现实数据里,还有一类特别常见的问题:
同样的内容,大小写写得乱七八糟。
比如一批标签:
tags = ['Python', 'python', 'PYTHON', 'Java', 'JAVA', 'java']
如果你直接统计,会把它们当成不同内容。 可业务上它们其实是同一个词。
这时候就要先统一大小写。
最常见的做法是统一转成小写:
tags = ['Python', 'python', 'PYTHON', 'Java', 'JAVA', 'java']new_tags = []for tag in tags: new_tags.append(tag.lower())print(new_tags)
输出:
['python', 'python', 'python', 'java', 'java', 'java']
这时候如果你再去重,就更合理了:
tags = ['Python', 'python', 'PYTHON', 'Java', 'JAVA', 'java']new_tags = []for tag in tags: new_tags.append(tag.lower())result = set(new_tags)print(result)
输出:
{'python', 'java'}
这就是很典型的清洗思路:
先统一 再统计 再去重
很多人去重做不对,不是集合不会用, 而是前面清洗没做。
这点特别值得记住。
八、为什么文本清洗常常决定统计结果对不对
这个问题非常现实。
比如你统计网站里到底有多少个不同标签。 如果不清洗,下面这些可能都会被当成不同值:
PythonpythonPYTHONpython Python
可实际业务上,它们明明是一个东西。
所以如果你在做统计前,没把空格和大小写统一掉, 最后结果很可能就是错的。
你会发现,数据处理很多时候不是算法有多复杂, 而是你前面的基础清洗做没做到位。
这也是为什么很多经验丰富的人,一拿到数据,第一反应不是分析, 而是先看脏不脏。
九、案例四:统一分隔符,把乱格式文本改整齐
真实数据还有一个很典型的问题:
分隔符不统一。
比如一批记录可能长这样:
rows = ['张三,18,北京','李四;20;上海','王五|19|深圳']
你看,第一条用逗号,第二条用分号,第三条用竖线。 这种数据如果直接 split(','),根本不可能统一处理。
这时候最常见的思路就是:
先把不同分隔符统一替换成同一种 再统一拆分
代码可以这样写:
rows = ['张三,18,北京','李四;20;上海','王五|19|深圳']result = []for row in rows: row = row.replace(';', ',') row = row.replace('|', ',') parts = row.split(',') result.append(parts)print(result)
输出:
[['张三', '18', '北京'], ['李四', '20', '上海'], ['王五', '19', '深圳']]
这个案例特别典型。
因为很多看起来难搞的数据,真正的难点不在后面, 而在于格式没统一。
所以做清洗时,经常要先做一件事:
把不统一的形式,先拉到同一条线上
只有格式统一了,后面的批量处理才会顺。
十、案例五:清洗带多余空行和无效内容的文本
再看一个更贴近真实文件内容的场景。
假设你从文件里读出这样一组行数据:
lines = [' 张三,18,北京 ','',' ','李四,20,上海','王五,19,深圳','']
这里有空字符串,也有全是空格的无效行。 如果你不处理,后面拆分时就会很别扭。
更稳的做法是先过滤掉无效行。
lines = [' 张三,18,北京 ','',' ','李四,20,上海','王五,19,深圳','']valid_lines = []for line in lines: line = line.strip()if line != '': valid_lines.append(line)print(valid_lines)
输出:
['张三,18,北京', '李四,20,上海', '王五,19,深圳']
然后再继续拆:
result = []for line in valid_lines: result.append(line.split(','))print(result)
输出:
[['张三', '18', '北京'], ['李四', '20', '上海'], ['王五', '19', '深圳']]
你会发现,清洗时很多时候不是一步到位, 而是先去垃圾,再做正式处理。
这就是很常见的实战思路。
十一、案例六:批量清洗用户名,做注册前预处理
假设有一批用户输入的用户名:
users = [' Tom ','jerry','ALICE ',' bob']
你希望最后统一成:
去掉两边空格 统一小写
代码可以这样写:
users = [' Tom ','jerry','ALICE ',' bob']new_users = []for user in users: user = user.strip() user = user.lower() new_users.append(user)print(new_users)
输出:
['tom', 'jerry', 'alice', 'bob']
这类处理在用户系统里特别常见。
因为真实用户输入,几乎从来不会像你想得那么整齐。 如果程序不做预处理,后面注册、对比、查重,很容易出现奇怪问题。
比如:
Tom 和 tom看起来像两个不同输入 但业务上你可能希望把它们视为同一个用户风格
所以清洗,其实也是在帮程序建立更稳定的规则。
十二、案例七:把一句乱文本整理成适合展示的句子
假设你有一句很乱的文本:
text = ' python is very useful '
你想把它整理成更规整的一句:
去掉两边空格 按空白拆开 再重新用单个空格拼起来
代码可以这样写:
text = ' python is very useful 'parts = text.split()result = ' '.join(parts)print(result)
输出:
python is very useful
这个案例特别适合理解 split() 和 join() 的配合。
前面学方法时你可能觉得它们只是两个普通工具。 但放到实际清洗里,你会发现它们简直像一对搭档。
先拆散 再重组
这就是很多文本整形的核心套路。
十三、为什么 split 不写参数时这么适合做基础清洗
因为它默认按空白拆,而且会自动把多个连续空白当成一个处理。
比如:
text = 'a b c'print(text.split())
输出:
['a', 'b', 'c']
你会发现,它直接帮你把多余空白问题顺手解决了。
所以面对那种:
单词之间空格乱 文本中有多个连续空白 需要把一句话整理成标准空格格式
这种场景时,split() 加 join() 真的是非常顺手的一套组合。
十四、案例八:清洗商品标题中的多余符号
再看一个更像电商场景的例子。
假设一批商品标题是这样的:
titles = ['【热卖】机械键盘!!!','【新品】无线鼠标!!!','【促销】显示器!!!']
你想把它们统一处理成更干净的标题:
去掉前面的 【热卖】、【新品】、【促销】去掉后面的 !!!
这里我们先不讲太复杂的模式提取,只用当前学过的方法做基础清洗。
titles = ['【热卖】机械键盘!!!','【新品】无线鼠标!!!','【促销】显示器!!!']new_titles = []for title in titles: title = title.replace('【热卖】', '') title = title.replace('【新品】', '') title = title.replace('【促销】', '') title = title.replace('!!!', '') new_titles.append(title)print(new_titles)
输出:
['机械键盘', '无线鼠标', '显示器']
这个例子非常贴近真实业务。
很多原始文本并不纯粹,它们会带着广告词、标签、情绪符号、装饰前缀。 而清洗的目标,往往就是把这些无关噪音去掉,只保留你真正关心的主体内容。
十五、案例九:批量提取日志中有用的信息
假设你有这样几条简单日志:
logs = ['INFO: 程序启动成功','ERROR: 文件读取失败','INFO: 用户登录成功','ERROR: 数据库连接失败']
你现在只想要错误日志。
代码可以这样写:
logs = ['INFO: 程序启动成功','ERROR: 文件读取失败','INFO: 用户登录成功','ERROR: 数据库连接失败']errors = []for log in logs:if log.startswith('ERROR'): errors.append(log)print(errors)
输出:
['ERROR: 文件读取失败', 'ERROR: 数据库连接失败']
如果你还想进一步只保留错误内容,不要前面的 ERROR: ,就可以继续清洗:
messages = []for log in logs:if log.startswith('ERROR'): log = log.replace('ERROR: ', '') messages.append(log)print(messages)
输出:
['文件读取失败', '数据库连接失败']
你看,字符串处理一旦进到真实场景,很多时候不是华丽技巧, 而是很踏实的过滤、替换、提取。
十六、真正的文本清洗,往往是多步连续处理
这一点你一定要建立起来。
很多同学刚开始做题时,总想找一个一招秒掉问题的方法。 但真实清洗里,更多时候是多步串联。
比如你可能会这样处理一批文本:
先 strip()再 replace()再 lower()再 split()再逐项 strip()最后转成字典
这不是啰嗦。 这恰恰就是数据清洗最真实的样子。
原始数据往往本来就不规整。 所以你别指望一步就神奇变干净。
更合理的思路是:
一层一层洗 每一步都只解决一个问题
这样代码不仅更稳,也更容易调试。
十七、一个完整小案例:清洗报名表原始文本
现在我们来做一个更像样的综合案例。
假设你从某个地方拿到一批原始报名数据:
rows = [' 张三 ; 18 ; 北京 ','李四,20,上海',' 王五 | 19 | 深圳 ','',' 赵六, 21 , 杭州 ']
我们的目标是:
去掉空行 统一分隔符 清理每一项两边空格 最终整理成字典列表
代码如下:
rows = [' 张三 ; 18 ; 北京 ','李四,20,上海',' 王五 | 19 | 深圳 ','',' 赵六, 21 , 杭州 ']students = []for row in rows: row = row.strip()if row == '':continue row = row.replace(';', ',') row = row.replace('|', ',') parts = row.split(',') clean_parts = []for item in parts: clean_parts.append(item.strip()) student = {'name': clean_parts[0],'age': clean_parts[1],'city': clean_parts[2] } students.append(student)print(students)
输出:
[ {'name': '张三', 'age': '18', 'city': '北京'}, {'name': '李四', 'age': '20', 'city': '上海'}, {'name': '王五', 'age': '19', 'city': '深圳'}, {'name': '赵六', 'age': '21', 'city': '杭州'}]
这个案例非常有代表性。
因为它几乎把前面学过的一整套字符串基础工具都串起来了:
strip()replace()split()循环 条件判断 字典 列表
这才是真正的实战味道。
十八、为什么这类案例特别值得你反复敲
因为它训练的不是某个单独语法, 而是完整的数据处理思维。
你以后不管是处理:
学生信息 订单文本 商品标签 日志内容 表格导出文本 网页抓下来的字段
其实都在做类似的事情:
先看脏在哪 再逐步处理 最后变成规整结构
一旦这个思维练出来,你后面学文件、JSON、CSV、正则、Pandas,都会轻松很多。 因为你已经开始理解 数据从乱到整洁 的过程了。
十九、文本清洗时最容易犯的几个错
先说第一个。
只清理了整体两边空格,却忘了拆开后的每一项也可能带空格。
比如:
text = '张三, 18, 北京'
你就算先 strip() 了, 拆出来的 18 和 北京 前面仍然可能带空格。
第二个错,是没有先统一分隔符,就直接 split()。 数据格式不统一时,这样会直接漏掉很多内容。
第三个错,是清洗顺序乱了。 比如空行还没过滤,就直接开始拆分,后面就容易报错或得到怪结果。
第四个错,是只把数据变好看了,却没把它变成后续更容易处理的结构。 很多时候,清洗的终点应该是列表、字典这种结构化结果,而不是仅仅一条更干净的字符串。
第五个错,是一上来就想写得特别高级。 其实基础阶段最重要的是写清楚、写稳,不是写炫。
二十、真正实用的文本清洗口诀
你可以先给自己记一个很实用的顺序:
先去边 再统一 再拆分 再逐项清 再转结构
翻成更直白的话就是:
先 strip() 去整体边缘杂质 再 replace() 统一格式 再 split() 拆成字段 再对每一项继续处理 最后装进列表、字典这些更好用的数据结构里
这个顺序不是绝对死规定, 但对入门阶段非常有帮助。
很多乱数据,你就按这条路去想,思路会清楚很多。
二十一、练习题:这一章一定要自己改一改
下面这些题,建议你别只复制运行,最好自己改一改。
1. 清洗下面这条数据,得到 ['李四', '20', '上海']
text = ' 李四 , 20 , 上海 '
参考思路:
先 strip()再 split(',')再逐项 strip()
2. 把下面这批标签统一转小写,再去重
tags = ['Python', 'python', 'PYTHON', 'Java', 'JAVA']
3. 把下面这批记录里的分号和竖线都统一成逗号
rows = ['张三;18;北京','李四|20|上海','王五,19,深圳']
4. 过滤掉下面这些行里的空行和纯空格行
lines = ['张三,18,北京', '', ' ', '李四,20,上海']
5. 把下面一批用户名去掉两边空格并统一小写
users = [' Tom ', 'JERRY', ' alice ', 'BOB']
这些题只要你自己敲完,你会明显感觉到字符串处理开始不像知识点,而更像工具了。
二十二、本章小结
这一章最重要的,不是又多学了几个字符串方法, 而是你开始真正把它们组合起来用了。
文本清洗,本质上就是把不规整的数据一步步整理成规整的数据。 前面学过的 strip()、split()、replace()、lower()、join()、查找判断、循环、字典、列表,在这里终于真正开始联合作战了。
你要记住这一章最核心的几件事:
文本清洗通常不是一步完成,而是多步连续处理。 很多问题都可以拆成 去边、统一、拆分、逐项清理、转结构 这几步。 真正高频的不是某个单独方法,而是方法之间的组合。 清洗的终点,往往应该是更适合程序继续处理的数据结构。
学会这一章之后,你会慢慢发现,自己不再只是会对字符串做几下小操作, 而是开始能真正处理一批真实文本数据了。
下一章我们继续讲 字符串专题总结:把文本处理能力真正建立起来。 到那一章,我们会把这一整个阶段的知识真正串起来,让你知道自己到底已经掌握了什么。