一、案例简介
政策文本整理是一项典型的高重复性工作。面对几十篇政策文件,研究者不仅需要从长文本中提取“支持产业”“政策工具”“技术方向”等核心信息,还要判断“机器人”“工业机器人”“智能机器人”等近义表达是否属于同一类别。
人工处理容易出现三个问题:
- 3. 文件数量增加后,整理效率和结果一致性明显下降。
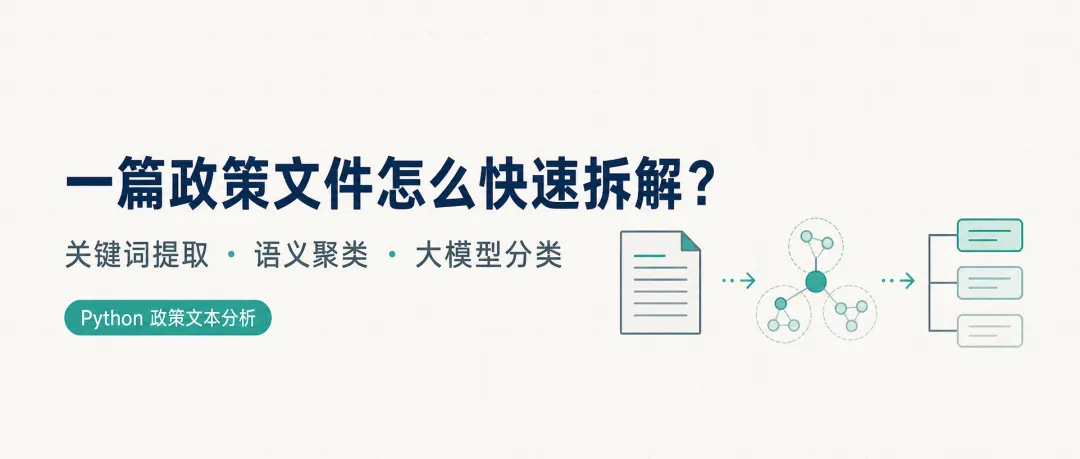
针对这一场景,代码构建了一套三阶段政策文本分析流程:
政策原文 ↓关键词提取 ↓语义聚类 ↓大模型结构化分类 ↓政策工具、支持产业、技术方向
原始数据为批量 .txt 政策文件,主入口为 run_pipeline.py。运行后,程序会依次完成:
- • 利用 TF-IDF 和 TextRank 提取高价值关键词;
主要输出目录如下:
output/├── step1_keybert/ # 关键词提取结果├── step2_semantic/ # 语义聚类结果└── step3_llm/ # 大模型分类结果
案例代码获取:
https://ppmandata.net/codeBase/2067495942281498625
二、代码思路
整套流程的核心思路是:
先把政策长文本压缩成关键词,再将关键词压缩成语义簇,最后由大模型完成结构化理解。
1. 文本预处理
程序首先读取政策文件,并完成基础清洗,包括:
这一步可以减少“进一步”“有关部门”“积极推进”等政策套话对分析结果的干扰。
2. 关键词提取
关键词提取同时使用 TF-IDF 和 TextRank。
- • TF-IDF 衡量词语在当前政策文件中的重要程度;
- • TextRank 根据词语之间的共现关系识别核心词;
相较于只使用一种算法,双算法融合能够兼顾词频差异和文本结构信息。
3. 语义聚类
关键词提取完成后,程序使用预训练语言模型生成文本向量,并计算关键词之间的余弦相似度。
当两个关键词的相似度超过设定阈值时,程序会将其划入同一个语义簇。例如:
工业机器人、智能机器人、机器人装备→ 机器人产业技术改造、设备更新、智能化改造→ 技术升级
语义聚类可以减少重复类别,统一不同政策文件中的表达口径。
4. 大模型分类
最后,程序将聚类后的关键词及相关原文片段发送给大模型,要求模型按照统一框架输出 JSON 结果。
主要分类维度包括:
通过限制输出格式和降低模型温度,可以提高批量分析结果的一致性。
三、核心代码
1. 双算法提取关键词
tfidf_results = jieba.analyse.extract_tags( text, topK=top_n * 2, withWeight=True, allowPOS=tuple(ALLOWED_POS))textrank_results = jieba.analyse.textrank( text, topK=top_n * 2, withWeight=True, allowPOS=tuple(ALLOWED_POS))keyword_score_map = {}for word, score in tfidf_results: if filter_token(word): keyword_score_map[word] = ( keyword_score_map.get(word, 0) + score * 0.5 )for word, score in textrank_results: if filter_token(word): keyword_score_map[word] = ( keyword_score_map.get(word, 0) + score * 0.5 )
程序分别获取 TF-IDF 和 TextRank 结果,再按照相同权重合并分数。最终保留综合得分较高的关键词。
2. 计算语义相似度
embeddings = st_model.encode( keyword_list, convert_to_tensor=True)cosine_scores = util.cos_sim( embeddings, embeddings)for i in range(len(keyword_list)): if i in cluster_assignment: continue current_cluster = [keyword_list[i]] cluster_assignment[i] = len(clusters) for j in range(i + 1, len(keyword_list)): similarity = cosine_scores[i][j].item() if ( j not in cluster_assignment and similarity >= config.SIMILARITY_THRESHOLD ): current_cluster.append(keyword_list[j]) cluster_assignment[j] = len(clusters) clusters.append(current_cluster)
代码先将关键词转换为语义向量,再计算两两之间的余弦相似度。超过阈值的关键词会被归入同一个语义簇。
3. 调用大模型分类
prompt = f"""你是一名公共政策分析专家。请根据政策关键词聚类结果和相关原文片段,按照以下三个维度进行分类:1. 政策调节工具2. 支持产业重点3. 技术瓶颈与攻关方向请严格输出JSON格式,不要添加额外解释。关键词聚类结果:{cluster_results}相关原文片段:{text_fragments}"""response = client.chat.completions.create( model=config.LLM_MODEL, messages=[ { "role": "system", "content": "You are a specialized JSON-outputting policy analyzer." }, { "role": "user", "content": prompt } ], temperature=0.1)
模型输入并非完整政策文件,而是经过筛选的关键词、语义簇和相关原文片段。这样既能减少无效信息,也能降低调用成本。
4. 批量执行完整流程
def main(): target_files = ( all_files[:config.DEMO_LIMIT] if config.DEMO_MODE else all_files ) run_step1(target_files) run_step2(target_files) run_step3(target_files)if __name__ == "__main__": main()
总入口将三个步骤依次串联。更换政策文件或调整参数后,只需要重新运行入口脚本即可完成全部分析。
四、结果展示
1. 关键词提取结果
以智能制造类政策文件为例,第一阶段提取出的主要关键词如下:
[图片]
2. 语义聚类结果
第二阶段将表达相近的关键词自动合并:
经过语义聚类后,零散关键词被整理为更加统一的政策概念。
3. 大模型分类结果
最终输出可以整理为以下结构:
对应的 JSON 输出形式如下:
{ "政策调节工具": [ "财政补贴", "专项资金", "税收优惠", "示范项目" ], "支持产业重点": [ "工业机器人", "智能制造", "核心零部件", "工业软件" ], "技术瓶颈与攻关方向": [ "高精度控制器", "伺服系统", "智能传感器", "工业操作系统" ]}
通过这套流程,原本需要逐篇阅读和手工归类的政策文件,可以被初步转换为统一、可比较的结构化数据。后续还可以继续开展政策工具统计、产业支持方向比较、地区政策差异分析以及年度政策演变研究。