量化投资与金融数据分析中,股票基础信息、交易日历、日线数据的本地化存储是基础环节。本文通过 30 行核心 Python 代码,实现基于 Tushare 接口获取 A 股核心数据,并将数据存储到本地 SQLite 数据库。
前置准备
1. 环境要求
- 操作系统:Windows/macOS/Linux均可
2. 依赖库安装
打开终端/命令提示符,执行以下命令安装所需库:
pip install tushare pandas
说明:sqlite3是Python内置库,无需额外安装;tushare用于获取金融数据,pandas用于数据处理。
3. Tushare Token获取
Tushare接口需要通过Token鉴权,获取步骤:
- Windows:
set TUSHARE_TOKEN=你的Token - macOS/Linux:
export TUSHARE_TOKEN=你的Token
参考前述日志:
实现步骤解析
步骤1:导入核心库
首先导入代码运行所需的所有库:
# 系统库:读取环境变量、数据库连接
import os
import sqlite3
# 日期处理库:计算时间范围
from datetime import datetime, timedelta
# 数据处理库:结构化数据操作
import pandas as pd
# 金融数据接口库:获取股票数据
import tushare as ts
步骤2:初始化配置
# 1. Tushare鉴权:从环境变量读取Token
ts.set_token(os.getenv("TUSHARE_TOKEN"))
pro = ts.pro_api()  # 创建接口实例

# 2. 数据库路径:数据将保存到当前目录的tushare_basic.db文件
DB_PATH = "tushare_basic.db"

# 3. 时间参数:定义数据的时间范围
END_DATE = "20260113"# 数据结束日期(格式:YYYYMMDD)
# 计算起始日期为结束日期前1年(timedelta(days=365)表示1年)
START_DATE = (datetime.strptime(END_DATE, "%Y%m%d") - timedelta(days=365)).strftime("%Y%m%d")
关键说明:datetime.strptime将字符串日期转为日期对象,strftime再转回指定格式的字符串。
步骤3:获取股票基础信息
调用Tushare的stock_basic接口,获取沪深市场所有股票的核心信息:
# 获取股票基础信息,指定返回字段
# 字段说明:ts_code(股票代码)、symbol(证券代码)、name(股票名称)、industry(所属行业)、list_date(上市日期)
stock_df = pro.stock_basic(fields="ts_code,symbol,name,industry,list_date")
# 打印获取的股票数量,验证数据是否正常返回
print(f"成功获取 {len(stock_df)} 只股票的基础信息")
示例输出:成功获取 5000 只股票的基础信息(数量随市场实时变化)
步骤4:获取交易所交易日历
金融数据分析需区分交易日和非交易日,调用trade_cal接口获取:
# 获取上交所(SSE)指定时间范围的交易日历
cal_df = pro.trade_cal(exchange="SSE", start_date=START_DATE, end_date=END_DATE)
# 筛选出仅交易日(is_open=1代表交易日,0为非交易日)
cal_df = cal_df[cal_df["is_open"] == "1"]
# 打印交易日数量
print(f"获取 {len(cal_df)} 个上交所交易日({START_DATE} 至 {END_DATE})")
步骤5:批量获取股票日线数据(简化版)
日线数据是股票分析的核心,为避免接口限流,先获取前10只股票的单日数据:
# 提取前10只股票的代码(简化版,避免接口调用过多)
codes = stock_df["ts_code"].head(10).tolist()

# 初始化空列表,存储每只股票的有效日线数据
daily_list = []

# 遍历股票代码,逐个获取日线数据
for code in codes:
# 获取单只股票指定日期的日线数据
    df = pro.daily(ts_code=code, start_date=END_DATE, end_date=END_DATE)
# 过滤停牌/无数据的情况(df.empty表示数据为空)
ifnot df.empty:
        daily_list.append(df)

# 拼接所有有效日线数据(无数据则返回空DataFrame)
daily_df = pd.concat(daily_list, ignore_index=True) if daily_list else pd.DataFrame()
print(f"成功获取 {len(daily_df)} 条股票日线数据")
关键说明:pd.concat用于拼接多个DataFrame,ignore_index=True重置索引避免重复。
步骤6:将数据写入SQLite数据库
SQLite是轻量级本地数据库,无需额外安装服务,适合存储小型金融数据集:
# 建立数据库连接(with语句自动关闭连接,避免资源泄露)
with sqlite3.connect(DB_PATH) as conn:
# 写入股票基础信息表:表名stock_basic,若存在则替换
    stock_df.to_sql("stock_basic", conn, if_exists="replace", index=False)
# 写入交易日历表:表名trade_cal
    cal_df.to_sql("trade_cal", conn, if_exists="replace", index=False)
# 写入日线数据表:表名daily
    daily_df.to_sql("daily", conn, if_exists="replace", index=False)

# 打印完成提示
print(f"所有数据已成功保存至本地数据库:{DB_PATH}")
关键参数:if_exists="replace"表示表已存在时覆盖,也可设为append(追加)或fail(报错);index=False不将DataFrame的索引写入数据库。
完整源代码
将以上步骤整合,保存为stock_data_collector.py:
# 导入核心库
import os
import sqlite3
from datetime import datetime, timedelta
import pandas as pd
import tushare as ts

# === 初始化配置 ===
# Tushare鉴权
ts.set_token(os.getenv("TUSHARE_TOKEN"))
pro = ts.pro_api()

# 数据库路径
DB_PATH = "tushare_basic.db"

# 时间参数
END_DATE = "20260113"
START_DATE = (datetime.strptime(END_DATE, "%Y%m%d") - timedelta(days=365)).strftime(
"%Y%m%d"
)

# === 1. 获取股票基础信息 ===
stock_df = pro.stock_basic(fields="ts_code,symbol,name,industry,list_date")
print(f"成功获取 {len(stock_df)} 只股票的基础信息")

# === 2. 获取上交所交易日历 ===
cal_df = pro.trade_cal(exchange="SSE", start_date=START_DATE, end_date=END_DATE)
cal_df = cal_df[cal_df["is_open"] == "1"]
print(f"获取 {len(cal_df)} 个上交所交易日({START_DATE} 至 {END_DATE})")

# === 3. 批量获取前10只股票日线数据 ===
codes = stock_df["ts_code"].head(10).tolist()
daily_list = []
for code in codes:
    df = pro.daily(ts_code=code, start_date=END_DATE, end_date=END_DATE)
ifnot df.empty:
        daily_list.append(df)
daily_df = pd.concat(daily_list, ignore_index=True) if daily_list else pd.DataFrame()
print(f"成功获取 {len(daily_df)} 条股票日线数据")

# === 4. 写入SQLite数据库 ===
with sqlite3.connect(DB_PATH) as conn:
    stock_df.to_sql("stock_basic", conn, if_exists="replace", index=False)
    cal_df.to_sql("trade_cal", conn, if_exists="replace", index=False)
    daily_df.to_sql("daily", conn, if_exists="replace", index=False)

print(f"所有数据已成功保存至本地数据库:{DB_PATH}")
运行与验证
1. 运行代码
打开终端,进入代码所在目录,执行:
python stock_data_collector.py
2. 预期输出
成功获取 5000 只股票的基础信息
成功获取 10 条股票日线数据
所有数据已成功保存至本地数据库:tushare_basic.db
3. 验证数据库(可选)
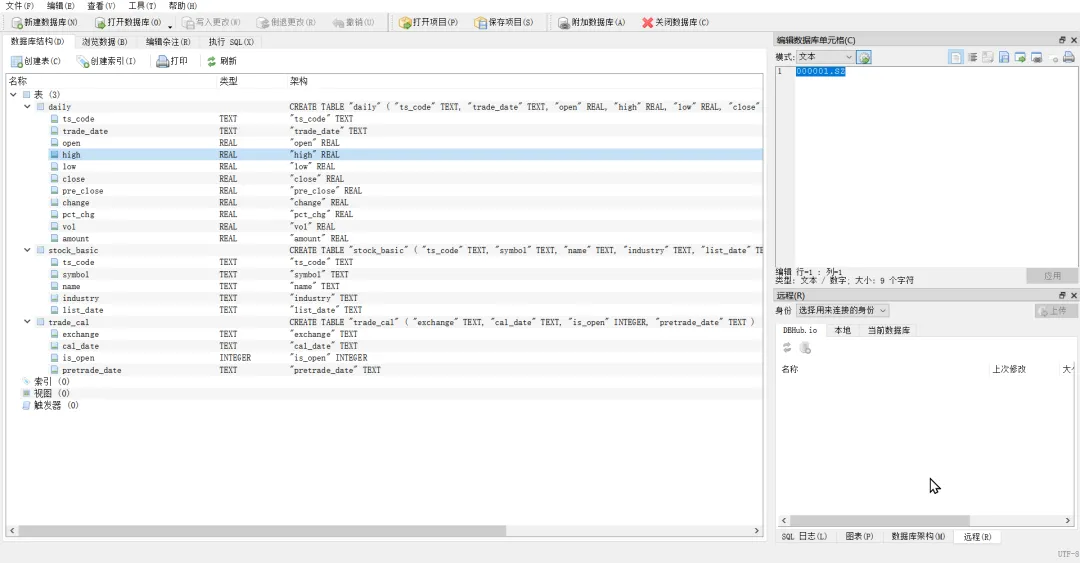
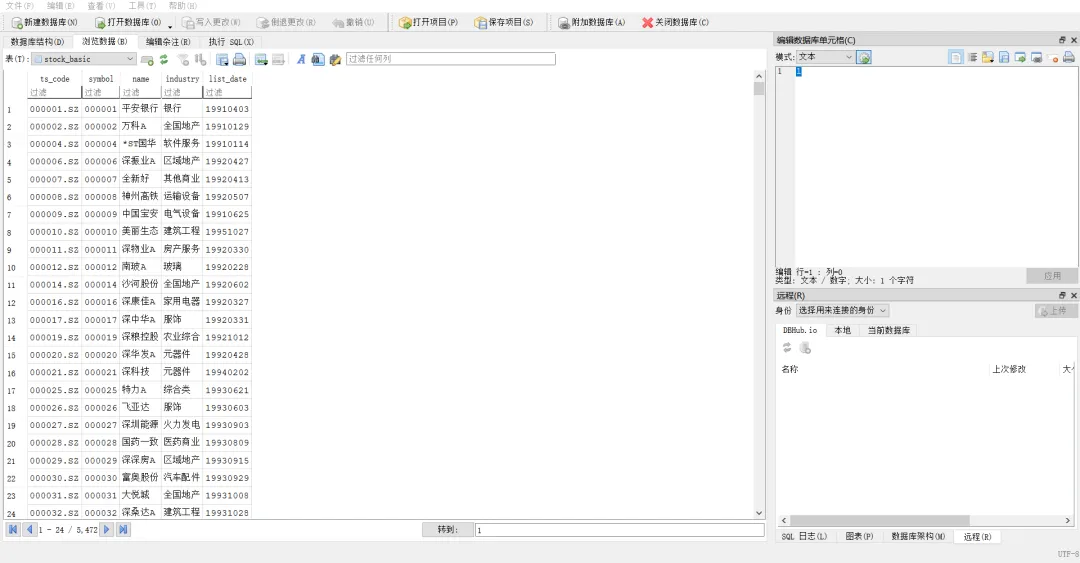
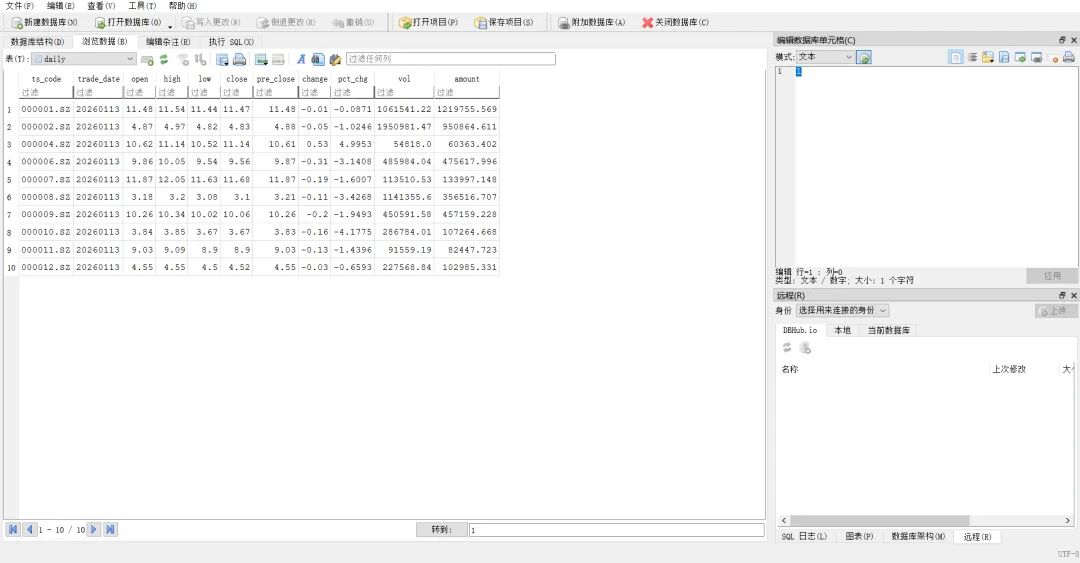
可使用SQLite可视化工具(如SQLite Studio、Navicat)打开ts_stock.db,查看以下三张表:
扩展建议
- 扩大数据范围:将
head(10)改为head(100)或移除head()获取全量股票数据(注意Tushare接口限流); - 增加异常处理:添加
try-except捕获接口调用失败、数据库连接异常等情况; - 增量更新数据:将
if_exists="replace"改为append,并增加数据去重逻辑; - 获取更多字段:修改
fields参数,获取开盘价、收盘价、成交量等更多日线字段; - 多线程加速:使用
threading/multiprocessing批量获取股票数据,提升效率。
 10个月宝宝每天需要喝多少奶粉?