当前位置:首页>python>【Hadoop+Spark+python毕设】基于大数据的奥运会金牌榜可视化分析系统、包括数据爬取、数据可视化、实战教学

【Hadoop+Spark+python毕设】基于大数据的奥运会金牌榜可视化分析系统、包括数据爬取、数据可视化、实战教学

  • 2026-09-08 01:32:34
【Hadoop+Spark+python毕设】基于大数据的奥运会金牌榜可视化分析系统、包括数据爬取、数据可视化、实战教学
计算机毕业设计小月哥
谢谢关注!
大数据、网站、小程序、安卓、深度学习
基于大数据的奥运会金牌榜可视化分析系统-功能介绍
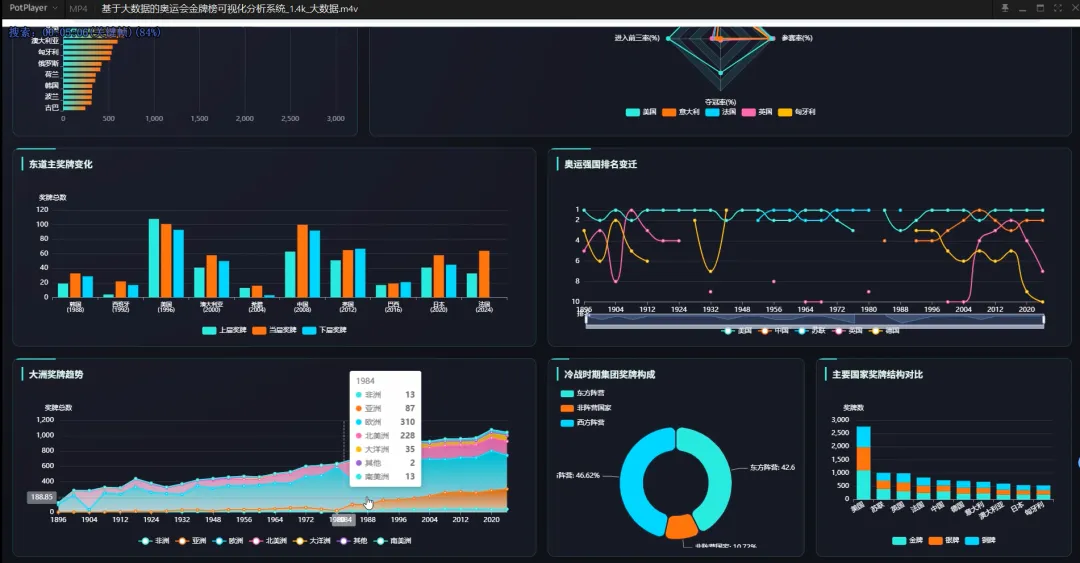
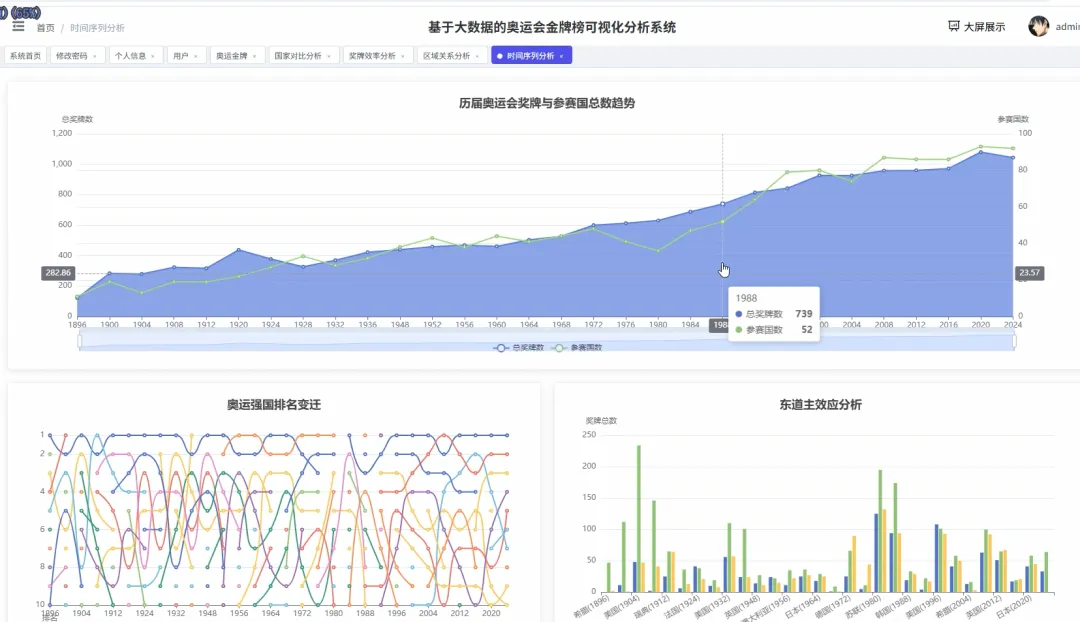
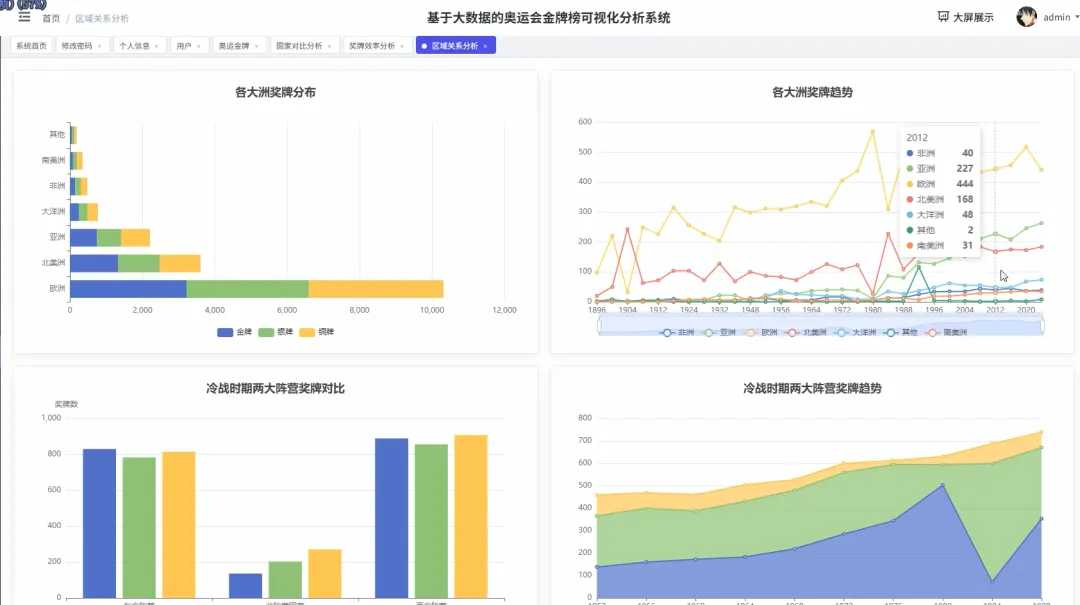
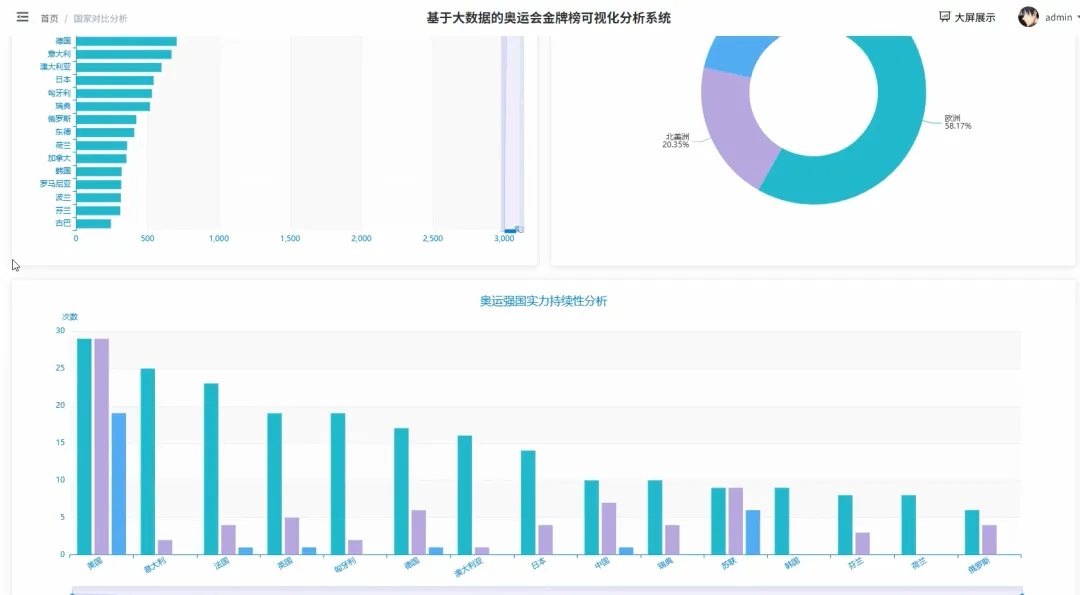
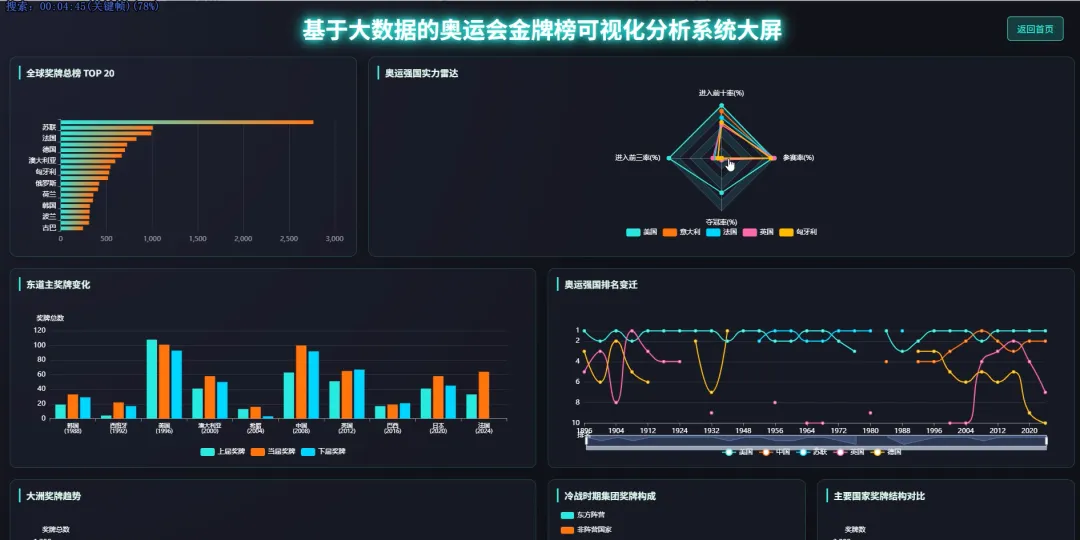
本系统是一个专为计算机专业毕业设计打造的,基于大数据技术栈的奥运会金牌榜可视化分析平台。系统整体采用Hadoop作为海量历史奥运数据的分布式存储基础,充分利用Spark引擎强大的并行计算能力来执行复杂的数据分析与挖掘任务,确保了处理百年奥运数据时的高效性与稳定性。后端服务采用Python语言进行开发,并借助Django框架快速构建了稳健的RESTful API接口,负责处理前端的各类分析请求。前端界面则基于当前流行的Vue.js框架,结合ElementUI组件库打造了美观且用户友好的操作界面,并通过ECharts这一强大的可视化图表库,将枯燥的数据转化为直观、动态且可交互的图表。系统核心功能涵盖了时间序列与趋势分析、国家/地区比较分析、奖牌结构与效率分析以及区域与国际关系分析四大模块,具体实现了如历届奥运会奖牌总量变化趋势、奥运强国百年变迁、主办国效应评估、金牌转化效率计算、冷战时期东西方阵营对比等多个深度分析维度,旨在为用户提供一个全面、直观、交互式的奥运会历史数据洞察平台,将百年奥运的辉煌与变迁以数据驱动的形式生动呈现。
基于大数据的奥运会金牌榜可视化分析系统-技术介绍

大数据框架:Hadoop+Spark(本次没用Hive,支持定制)

开发语言:Python+Java(两个版本都支持)

后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)

前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery

详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy

数据库:MySQL

基于大数据的奥运会金牌榜可视化分析系统-背景与意义

选题背景

随着现代奥林匹克运动走过一个多世纪,累积了海量的、蕴含丰富信息的历史数据。每一届奥运会都产生数以万计的奖牌记录、运动员信息和赛事结果,这些数据共同构成了一座庞大的体育历史宝库。过去,人们想要了解奥运格局的演变,大多依赖于零散的新闻报道、纪录片或是简单的统计表格,这种方式不仅效率低下,而且难以发现数据背后隐藏的深层规律和复杂关联。进入大数据时代,我们拥有了处理和分析这类大规模数据集的技术能力,比如Hadoop和Spark等分布式计算框架,它们能让我们以前所未有的深度和广度来审视奥运历史。公众对于体育赛事的关注度也日益高涨,大家不再只满足于观看比赛,更渴望了解其背后的历史故事、国家实力的此消彼长以及各种有趣的统计现象。因此,开发一个能够系统性地整合、处理并可视化百年奥运数据的系统,不仅是技术发展的必然产物,也满足了社会大众对深度体育内容的需求。

选题意义

这个项目的意义,说大不大,说小不小,主要还是体现在实际应用和学习价值上。从实际应用的角度来看,它为体育爱好者、历史研究者甚至是一些体育管理机构提供了一个相当便捷的分析工具。普通人不用再去费力地翻找各种资料,就能通过这个系统直观地看到某个国家在奥运史上的兴衰历程,或者举办奥运会到底对主办国的成绩有多大影响,这些数据驱动的结论比单纯的感官印象要客观得多。对于学生而言,这个毕设的意义就更直接了。它完整地走了一遍大数据项目的全流程,从数据的理解、清洗,到使用Spark进行分布式计算分析,再到最后用ECharts把结果漂亮地展示出来,这本身就是一次非常宝贵的综合实践。它不是一个空架子,而是真正把Hadoop、Spark这些热门技术用到了一个具体的、有意义的场景里,做出来的东西也能看、能用,这对于找工作或者继续深造都是一个不错的加分项,能实实在在地证明自己具备解决复杂问题的能力。

基于大数据的奥运会金牌榜可视化分析系统-视频展示
已关注
关注
重播 分享 赞
基于大数据的奥运会金牌榜可视化分析系统-视频展示
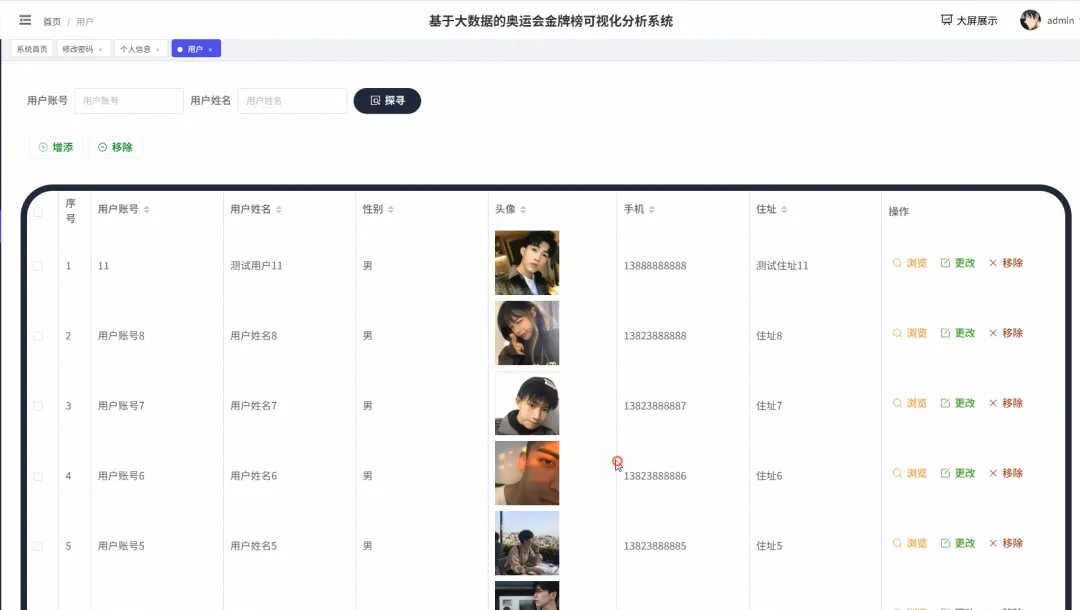
基于大数据的奥运会金牌榜可视化分析系统-图片展示
大屏上
大屏下
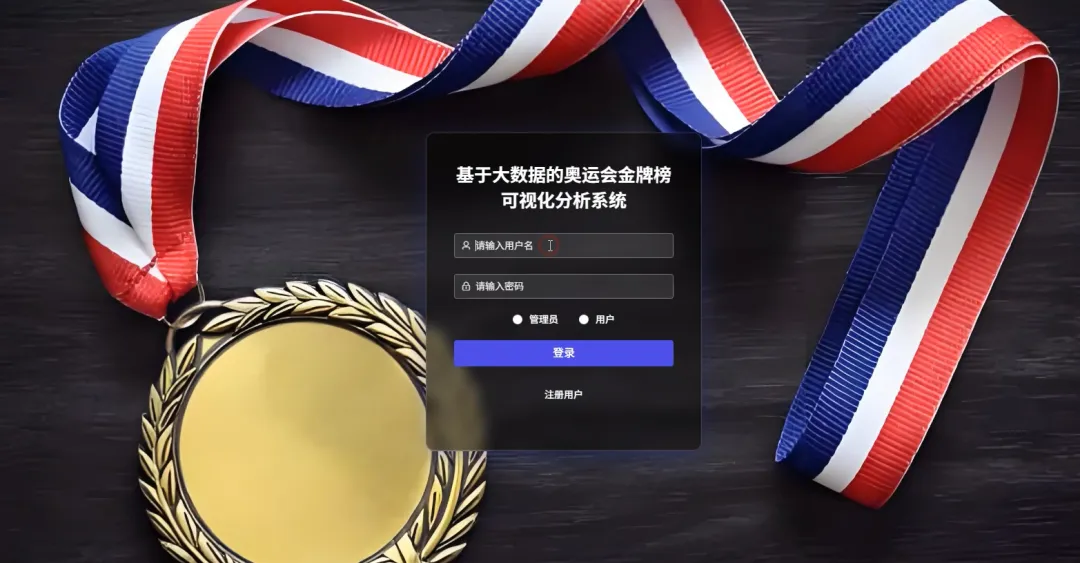
登录
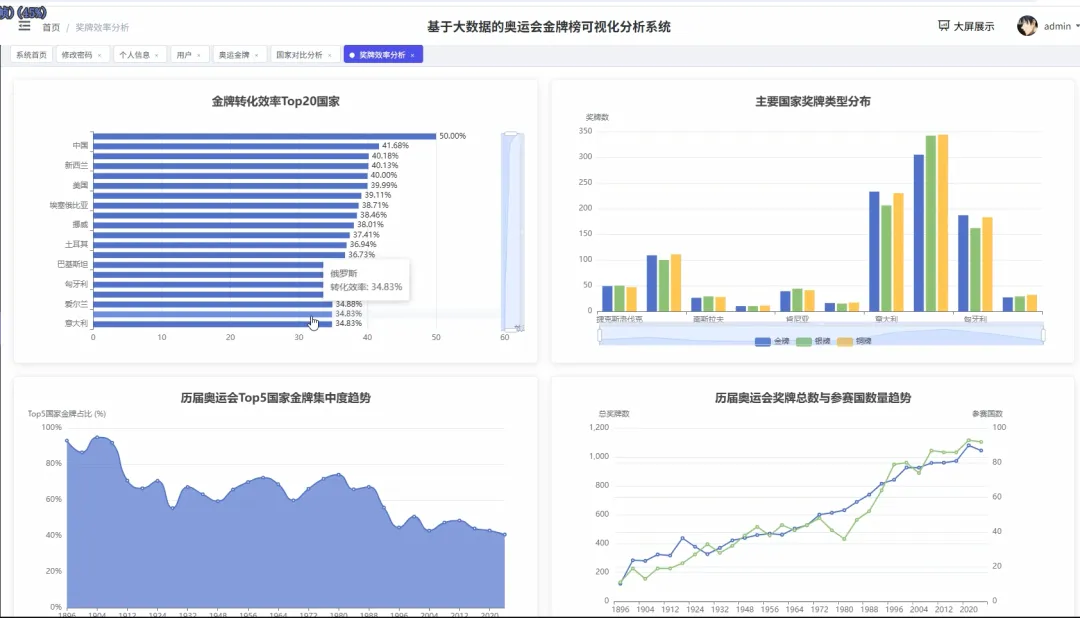
奥运奖牌效率分析
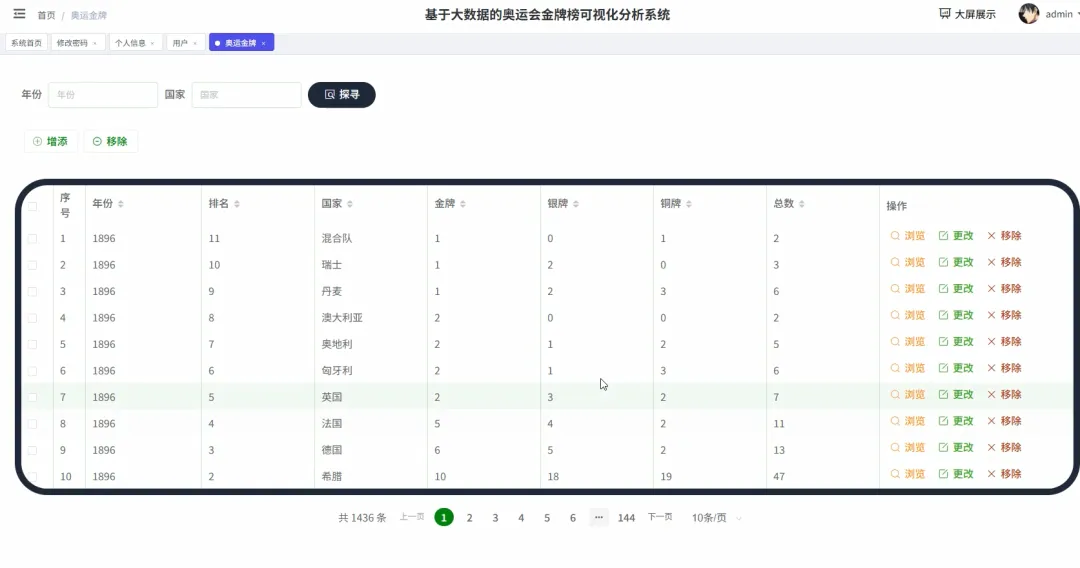
奥运金牌管理
奥运历史趋势分析
地缘政治格局分析
国家奖牌实力分析
用户管理
基于大数据的奥运会金牌榜可视化分析系统-代码展示
from pyspark.sql import SparkSession, functions as F, Windowspark = SparkSession.builder.appName("OlympicAnalysis").getOrCreate()df = spark.read.csv("hdfs://path/to/olympics.csv", header=True, inferSchema=True)def get_medal_trends():    filtered_df = df.filter((df['Season'] == 'Summer') & (df['Year'] >= 1896))    trend_df = filtered_df.groupBy('Year').agg(F.sum('Total').alias('Total_Medals'))    trend_df = trend_df.orderBy('Year')    result = trend_df.collect()    json_data = [{"year": row['Year'], "medals": row['Total_Medals']} for row in result]    return json_datadef get_powerful_nations_transition():    summer_df = df.filter(df['Season'] == 'Summer')    gold_sum_df = summer_df.groupBy('Year', 'NOC').agg(F.sum('Gold').alias('Total_Gold'))    window_spec = Window.partitionBy('Year').orderBy(F.desc('Total_Gold'))    ranked_df = gold_sum_df.withColumn('Rank', F.row_number().over(window_spec))    top10_df = ranked_df.filter(ranked_df['Rank'] <= 10)    result = top10_df.orderBy('Year', 'Rank').collect()    json_data = [{"year": row['Year'], "noc": row['NOC'], "rank": row['Rank'], "gold": row['Total_Gold']} for row in result]    return json_datadef get_gold_conversion_efficiency():    total_medals_df = df.groupBy('NOC').agg(F.sum('Total').alias('Career_Total'), F.sum('Gold').alias('Career_Gold'))    efficiency_df = total_medals_df.filter(total_medals_df['Career_Total'] > 0)    efficiency_df = efficiency_df.withColumn('Conversion_Rate', (F.col('Career_Gold') / F.col('Career_Total')).cast('decimal(10, 4)'))    efficiency_df = efficiency_df.orderBy(F.desc('Conversion_Rate'))    efficiency_df = efficiency_df.filter(efficiency_df['Career_Total'] >= 10)    result = efficiency_df.collect()    json_data = [{"noc": row['NOC'], "total_medals": row['Career_Total'], "gold_medals": row['Career_Gold'], "rate": float(row['Conversion_Rate'])} for row in result]    return json_data
基于大数据的奥运会金牌榜可视化分析系统-结语
END

长按扫码关注

最新文章

随机文章