Python爬虫入门连载02:requests零基础入门,获取网页源代码
上一期我们装好爬虫两大核心库:requests、bs4今天正式上手实战,用几行代码实现:
自动访问任意网页、获取完整网页源代码
一、requests库是什么?
大白话:
requests 就是代码版浏览器可以代替我们:输入网址、访问网页、拿到网页返回的所有内容。不用打开Chrome、Edge浏览器,几行代码就能模拟访问网站。
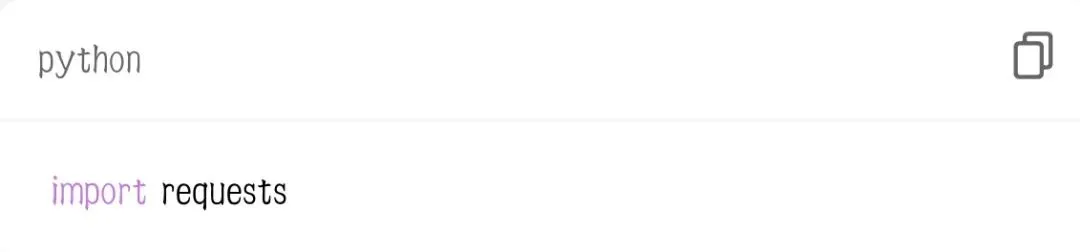
二、第一步:导入库
导入之后,就可以调用功能发送网络请求。
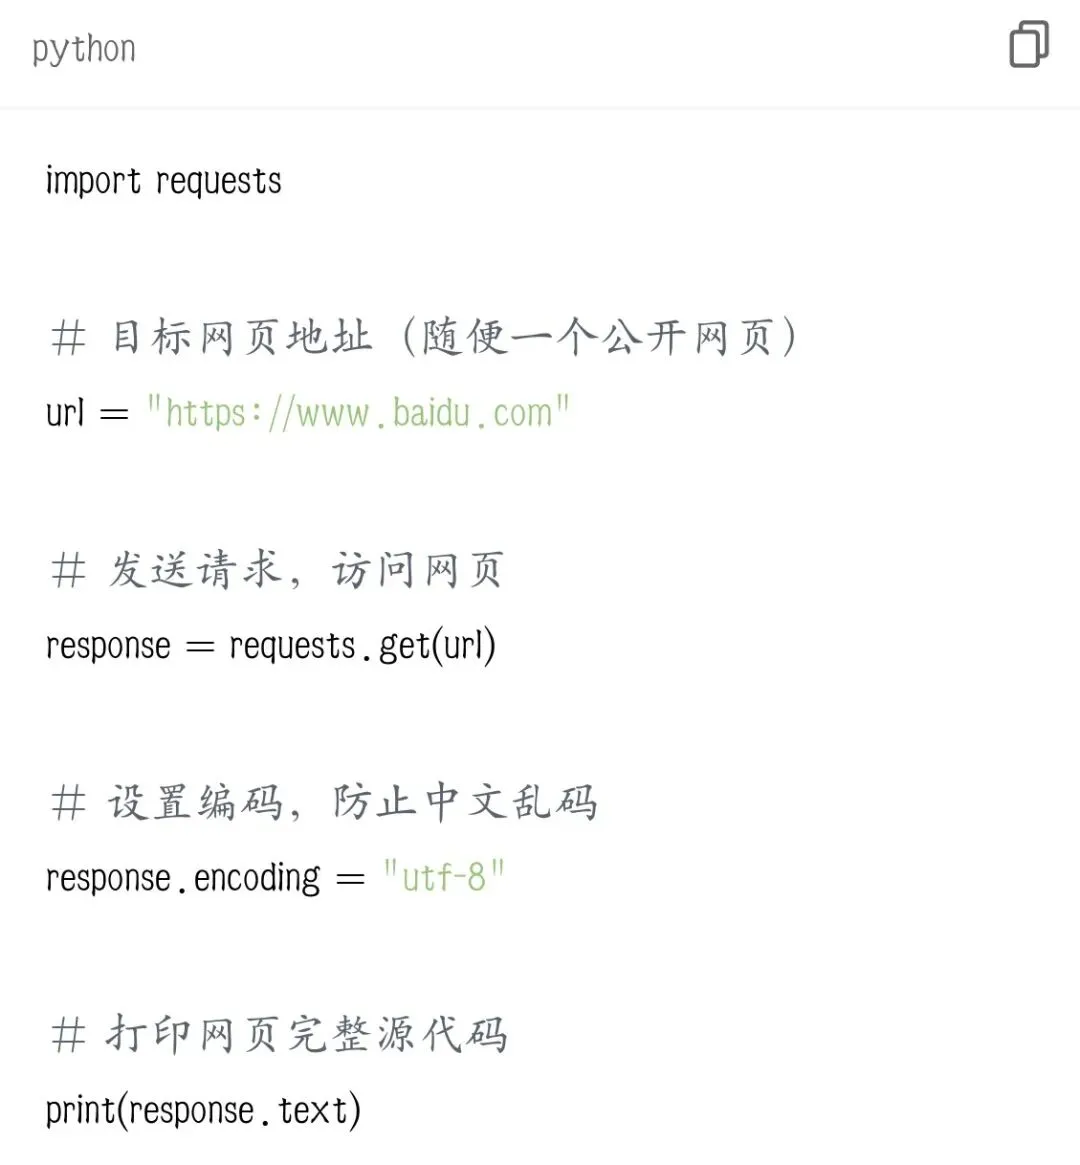
三、最简单爬虫:获取网页源码
完整可直接运行代码
运行后你会看到:
满屏的网页HTML代码,这就是浏览器看到的网页底层源码。
四、代码逐行讲解
1.import requests 导入网络请求库
2.url = "网址" 定义要爬的网页地址
3.requests.get(url) 发送GET请求,访问网页
4.response.encoding = "utf-8" 设置编码,解决中文乱码
5.response.text 获取网页源代码文本
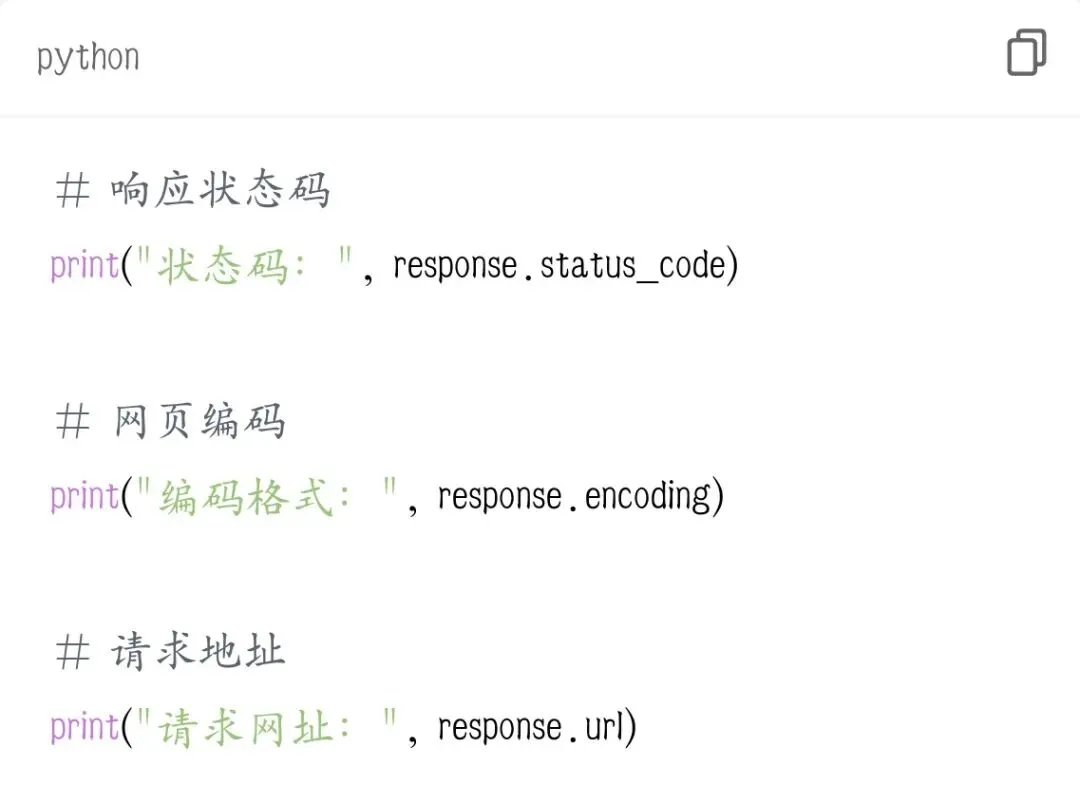
五、常用爬虫基础属性
状态码小常识
·200:访问成功,正常可以爬
·404:网页不存在
·500:服务器出错
只要看到 200,说明请求成功,可以正常抓取数据。
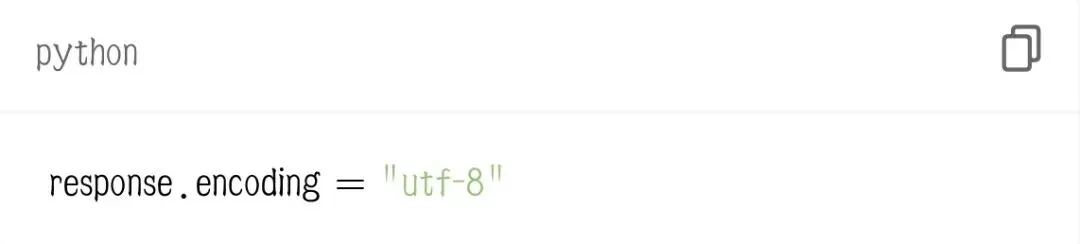
六、解决中文乱码重点
很多新手爬网页出现乱码方框,就是没设置编码:
固定加上这一行,90%网页中文都能正常显示。
七、新手常见避坑
❌ 网址必须带 https:// 或 http://,不能直接写www
❌ 没设置编码,中文全部乱码
❌ 没联网直接运行,一定会报错
❌ 不要频繁重复请求同一个网站,容易被限制
本期小结
1.requests.get() 用来访问网页
2.response.text 获取网页完整源码
3.response.status_code 判断网页是否访问成功
4.加 encoding="utf-8" 解决中文乱码
5.几行代码就能拿到任意公开网页源码
小作业
把代码里的网址换成任意一个新闻官网,运行并查看网页源码,观察结构。
下期预告
Python爬虫连载03:BeautifulSoup解析网页,提取标题、文字、超链接学会从密密麻麻的源码里,精准捞出我们想要的内容,不再看一堆杂乱代码!
 10个月宝宝每天需要喝多少奶粉?