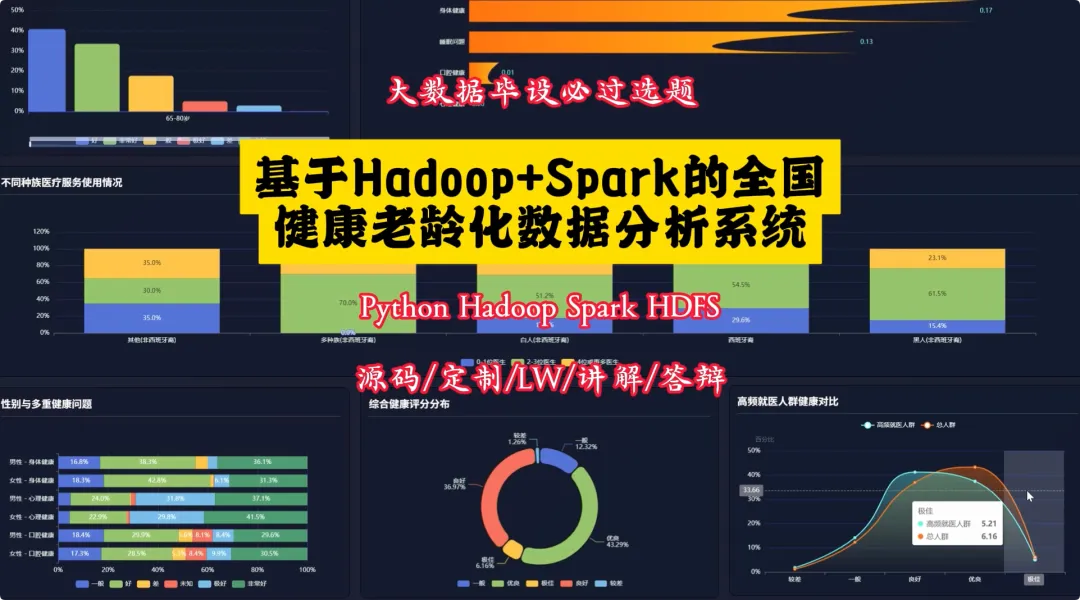
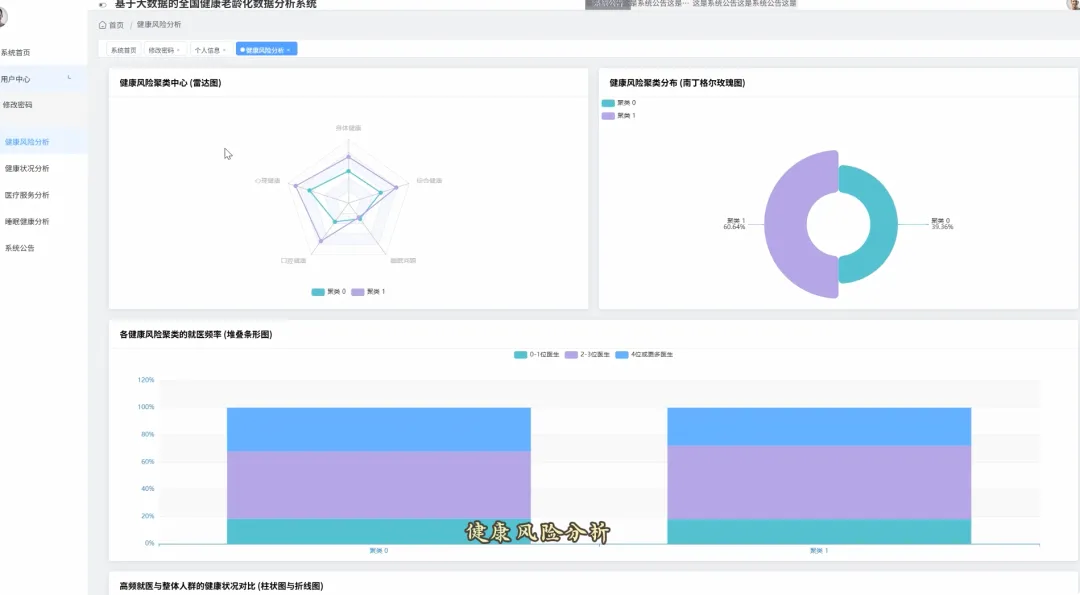
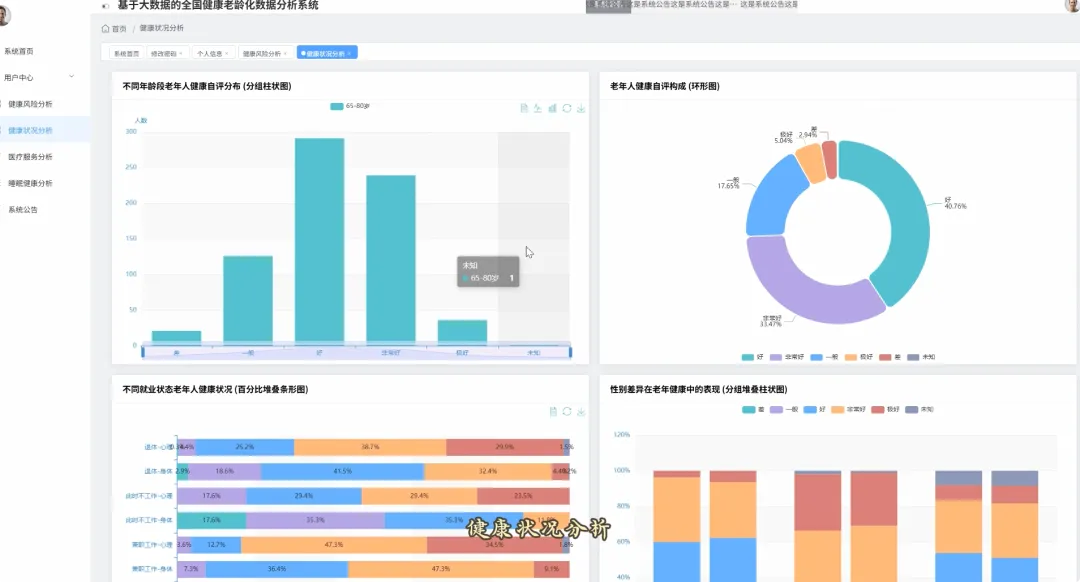
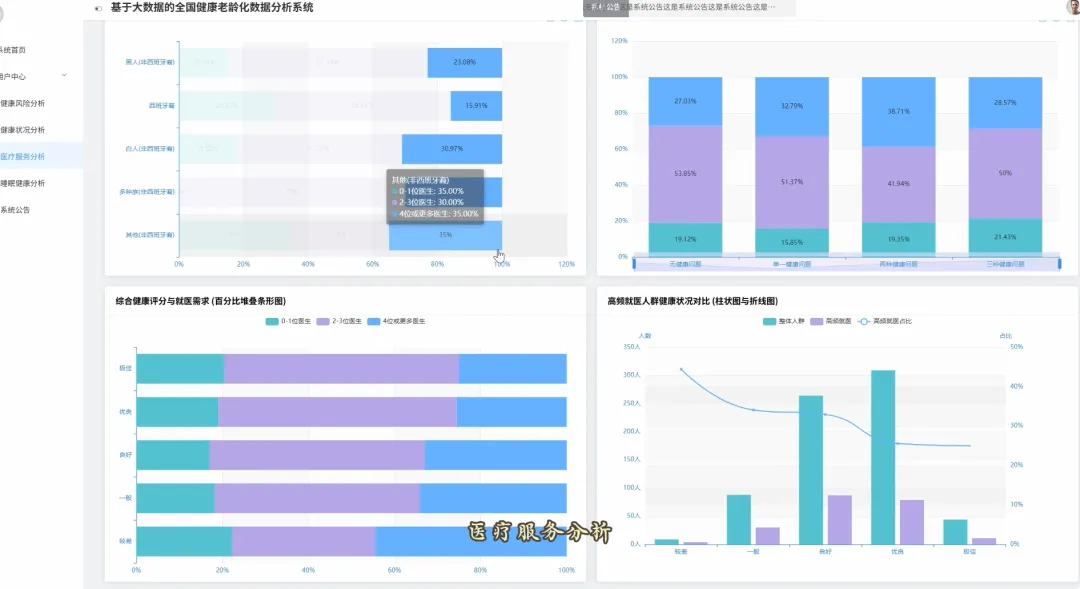
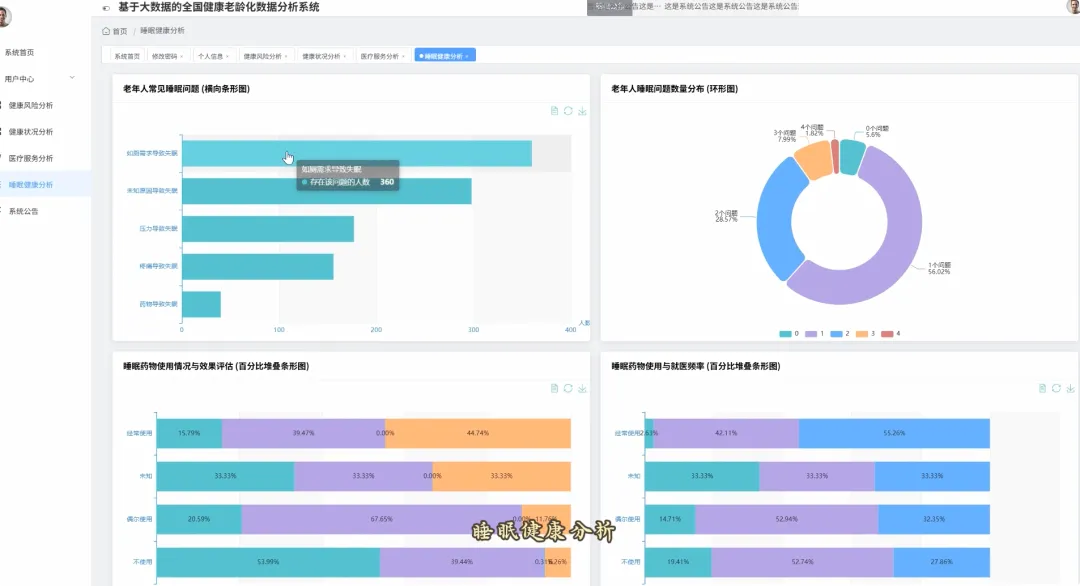
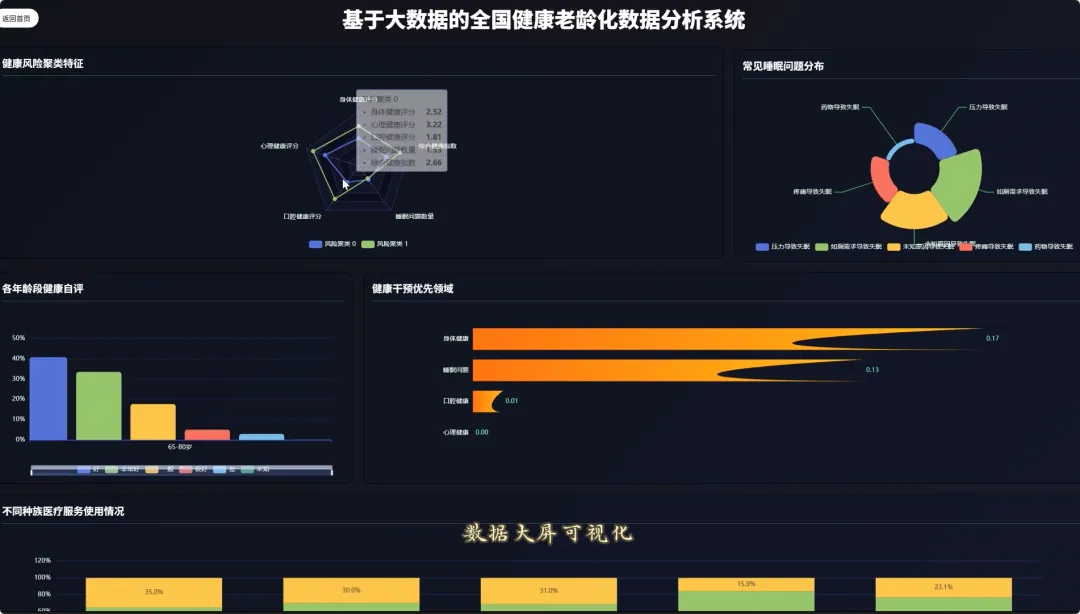
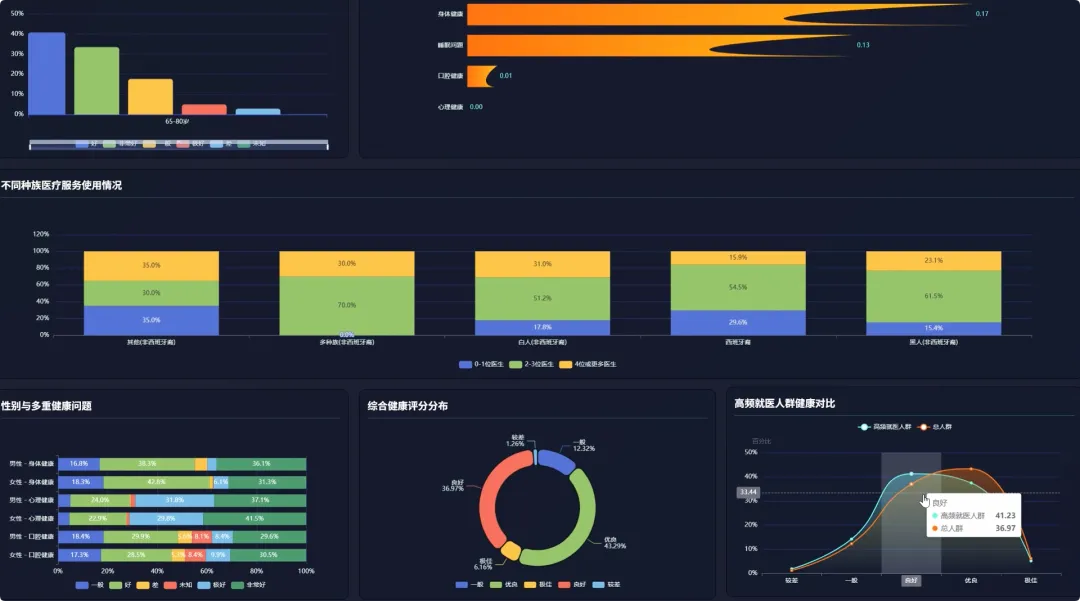
from pyspark.sql import SparkSessionfrom pyspark.ml.feature import VectorAssemblerfrom pyspark.ml.clustering import KMeansfrom pyspark.sql import functions as Fspark = SparkSession.builder.appName("HealthAgingAnalysis").getOrCreate()df = spark.read.csv("hdfs://path/to/health_data.csv", header=True, inferSchema=True)def health_risk_clustering(data): feature_cols = ["Physical Health", "Mental Health", "Dental Health", "Trouble Sleeping"] assembler = VectorAssembler(inputCols=feature_cols, outputCol="features") assembled_data = assembler.transform(data) kmeans = KMeans(featuresCol="features", predictionCol="cluster", k=3, seed=42) model = kmeans.fit(assembled_data) clustered_data = model.transform(assembled_data) cluster_analysis = clustered_data.groupBy("cluster").agg( F.avg("Physical Health").alias("avg_physical_health"), F.avg("Mental Health").alias("avg_mental_health"), F.avg("Dental Health").alias("avg_dental_health"), F.count("*").alias("cluster_size") ) return cluster_analysisdef health_correlation_analysis(data): data = data.withColumn("Physical_Health_Num", F.when(F.col("Physical Health") == "Excellent", 5) .when(F.col("Physical Health") == "Very Good", 4) .when(F.col("Physical Health") == "Good", 3) .when(F.col("Physical Health") == "Fair", 2) .otherwise(1)) data = data.withColumn("Mental_Health_Num", F.when(F.col("Mental Health") == "Excellent", 5) .when(F.col("Mental Health") == "Very Good", 4) .when(F.col("Mental Health") == "Good", 3) .when(F.col("Mental Health") == "Fair", 2) .otherwise(1)) correlation = data.stat.corr("Physical_Health_Num", "Mental_Health_Num") mental_group_analysis = data.groupBy("Mental Health").agg(F.avg("Physical_Health_Num").alias("avg_physical_score")) return correlation, mental_group_analysisdef high_frequency_visitors_analysis(data): high_freq_df = data.filter(F.col("Number of Doctors Visited") == "3") characteristics = high_freq_df.agg( F.avg("Physical Health").alias("avg_physical_health_status"), F.avg("Mental Health").alias("avg_mental_health_status"), F.count(F.when(F.col("Prescription Sleep Medication") == "Yes", True)).alias("sleep_med_users_count"), F.count("*").alias("total_high_freq_visitors") ) gender_distribution = high_freq_df.groupBy("Gender").count().withColumnRenamed("count", "gender_count") return characteristics, gender_distribution
 10个月宝宝每天需要喝多少奶粉?