告别重复劳动!Abaqus Python 自动化建模:手把手教你实现“分层建模”与“节点自动融合”内置函数 mergeNodes
在有限元分析(FEA)的日常工作中,我们经常会遇到需要对模型进行“分层”处理的情况——无论是为了模拟复合材料、定义不同的网格密度,还是为了后续的断裂力学分析。
如果仅仅靠 GUI 界面点点点,效率低且容易出错。今天,我们将深度解析一段高效的 Abaqus Python 脚本,看它如何优雅地完成从底层节点构建到结果自动可视化的全流程。
💡 为什么选择“分层建模”方案?
在本次演示的脚本中,我们并没有直接创建一个完整的矩形,而是将区域划分为 Lower Region 和 Upper Region。这种做法的优势在于:
🛠️ 核心参数概览
程序通过参数化驱动,所有几何与网格指标均可一键修改:
| | |
|---|
| L / H | | |
| H_split | | |
| nx | | |
| ny1 / ny2 | | |
| Material | | |
| Elem Type | | |
from abaqus import *from abaqusConstants import *import materialimport sectionimport regionToolsetimport displayGroupMdbToolset as dgmimport partimport assemblyimport stepimport interactionimport loadimport meshimport optimizationimport jobimport sketchimport visualizationimport xyPlotimport displayGroupOdbToolset as dgoimport connectorBehaviorimport sysimport osL = 100.0H = 20.0H_split = H / 2.0nx = 20ny1 = 2ny2 = 2dx = L / nxdy1 = H_split / ny1dy2 = H_split / ny2total_force = 1000.0model_name = 'Automated_Plane_Stress_Split'if model_name in mdb.models: del mdb.models[model_name]my_model = mdb.Model(name=model_name)my_part = my_model.Part( name='Plate', dimensionality=TWO_D_PLANAR, type=DEFORMABLE_BODY)nodes_region1 = []for j in range(ny1 + 1): for i in range(nx + 1): x = i * dx y = j * dy1 n = my_part.Node(coordinates=(x, y, 0.0)) nodes_region1.append(n)nodes_region2 = []for j in range(ny2 + 1): for i in range(nx + 1): x = i * dx y = H_split + j * dy2 n = my_part.Node(coordinates=(x, y, 0.0)) nodes_region2.append(n)all_part_nodes = my_part.nodesnode_dict = {}tolerance = 1e-6for node in all_part_nodes: coord_key = ( round(node.coordinates[0] / tolerance) * tolerance, round(node.coordinates[1] / tolerance) * tolerance, round(node.coordinates[2] / tolerance) * tolerance ) if coord_key not in node_dict: node_dict[coord_key] = node.labelnode_merge_map = {}for node in all_part_nodes: coord_key = ( round(node.coordinates[0] / tolerance) * tolerance, round(node.coordinates[1] / tolerance) * tolerance, round(node.coordinates[2] / tolerance) * tolerance ) node_merge_map[node.label] = node_dict[coord_key]duplicate_count = len(all_part_nodes) - len(node_dict)elements_region1 = []for j in range(ny1): for i in range(nx): n1_local = j * (nx + 1) + i n2_local = j * (nx + 1) + (i + 1) n3_local = (j + 1) * (nx + 1) + (i + 1) n4_local = (j + 1) * (nx + 1) + i node1 = nodes_region1[n1_local] node2 = nodes_region1[n2_local] node3 = nodes_region1[n3_local] node4 = nodes_region1[n4_local] elem = my_part.Element( nodes=(node1, node2, node3, node4), elemShape=QUAD4 ) elements_region1.append(elem)elements_region2 = []for j in range(ny2): for i in range(nx): n1_local = j * (nx + 1) + i n2_local = j * (nx + 1) + (i + 1) n3_local = (j + 1) * (nx + 1) + (i + 1) n4_local = (j + 1) * (nx + 1) + i node1 = nodes_region2[n1_local] node2 = nodes_region2[n2_local] node3 = nodes_region2[n3_local] node4 = nodes_region2[n4_local] elem = my_part.Element( nodes=(node1, node2, node3, node4), elemShape=QUAD4 ) elements_region2.append(elem)all_node_labels = [n.label for n in my_part.nodes]my_part.Set( nodes=my_part.nodes.sequenceFromLabels(all_node_labels), name='All-Nodes')my_part.mergeNodes( nodes=my_part.sets['All-Nodes'], tolerance=tolerance)mat = my_model.Material(name='Steel')mat.Elastic(table=((210000.0, 0.3), ))my_model.HomogeneousSolidSection( name='Sec', material='Steel', thickness=1.0)p_elems = my_part.elementsmy_part.Set(elements=p_elems, name='All-E')my_part.SectionAssignment( region=my_part.sets['All-E'], sectionName='Sec')my_part.setElementType( regions=my_part.sets['All-E'], elemTypes=(mesh.ElemType(elemCode=CPS4R),))all_nodes_final = my_part.nodesleft_labels = [n.label for n in all_nodes_final if abs(n.coordinates[0] - 0.0) < tolerance]my_part.Set( nodes=my_part.nodes.sequenceFromLabels(left_labels), name='Set-Left')right_labels = [n.label for n in all_nodes_final if abs(n.coordinates[0] - L) < tolerance]my_part.Set( nodes=my_part.nodes.sequenceFromLabels(right_labels), name='Set-Right')my_asm = my_model.rootAssemblyinst = my_asm.Instance(name='Inst', part=my_part, dependent=ON)my_model.StaticStep(name='Step-1', previous='Initial')my_model.EncastreBC( name='Fix', createStepName='Initial', region=inst.sets['Set-Left'])f_per_node = total_force / len(right_labels)my_model.ConcentratedForce( name='Pull', createStepName='Step-1', region=inst.sets['Set-Right'], cf1=f_per_node)job_name = 'Analysis_Task_Split'if job_name in mdb.jobs: del mdb.jobs[job_name]my_job = mdb.Job( name=job_name, model=model_name, type=ANALYSIS, description='Automated Plane Stress Analysis - Split Domain')my_job.submit()my_job.waitForCompletion()odb_path = job_name + '.odb'my_odb = session.openOdb(name=odb_path)vp = session.viewports['Viewport: 1']vp.setValues(displayedObject=my_odb)vp.odbDisplay.setPrimaryVariable( variableLabel='S', outputPosition=INTEGRATION_POINT, refinement=(INVARIANT, 'Mises'))vp.odbDisplay.display.setValues(plotState=(CONTOURS_ON_DEF, ))vp.odbDisplay.commonOptions.setValues(deformationScaling=AUTO)
🔍 脚本技术亮点解析
1. 纯手动节点构建 (Orphan Mesh) 🏗️
脚本跳过了传统的 Sketch 绘图,直接利用 my_part.Node 在空间中通过循环生成节点坐标。这种“底层开发”模式赋予了仿真工程师对模型最绝对的控制权。
2. 巧妙的节点融合技术 (Node Merge) 🔗
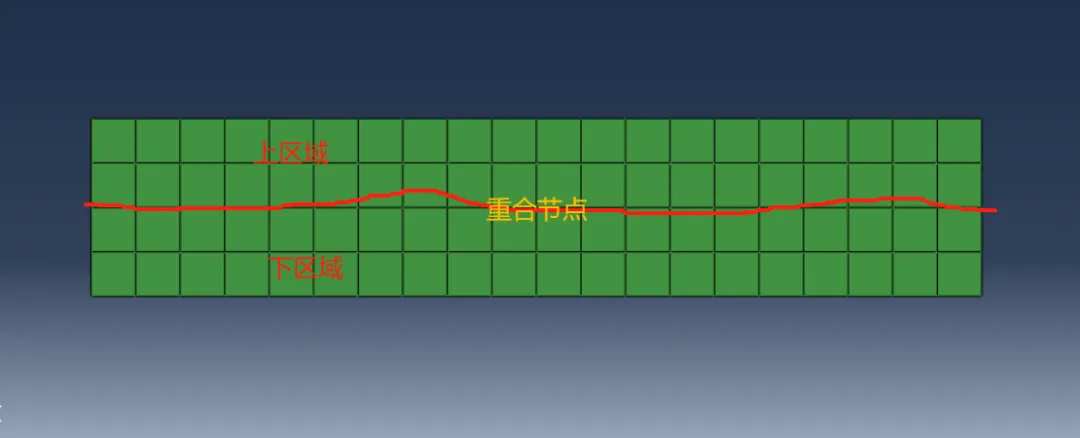
这是本程序的灵魂所在。由于上下两个区域分别生成节点,在交界处(Y =H_split)会产生重叠节点。脚本采用了双重保险:
3. 全自动化分析流 🌊
从创建材料、指派截面、定义边界条件(左侧固定,右侧拉伸),到最后的 Job 提交与 ODB 结果自动打开,真正实现了 “一键仿真”。
📊 仿真结果呈现
程序运行结束后,会自动进入后处理模块并执行以下操作:
📝 结语
通过 Python 驱动 Abaqus,不仅是提升效率的手段,更是通往数字化设计(Generative Design)和大规模参数化扫描的必经之路。
这段代码展示了一个完整的自动化闭环:
输入:几何与物理参数
处理:底层网格构建与拓扑修复
求解:自动计算
输出:可视化云图与分析报告
希望这篇推文的思路能给你带来启发!如果你对这段脚本的某个特定函数(如 sequenceFromLabels 或 mergeNodes 的容差设置)感兴趣,欢迎在评论区留言或直接私信我交流。