一、项目背景与意义
1.1 为什么需要口罩检测?
2020年以来,口罩佩戴检测成为了计算机视觉领域最受关注的应用场景之一。在公共场所(医院、商场、地铁站、机场等),自动检测人员是否佩戴口罩不仅能够提高防疫效率,还能减少人工检查的接触风险。
核心应用场景:
1.2 技术挑战
口罩检测看似简单,但实际落地面临不少挑战:
- 光照变化
- 口罩多样性
- 遮挡程度
- 多人场景
- 实时性要求
1.3 本文目标
本文将基于 Python + Keras/TensorFlow + OpenCV + MobileNetV2 技术栈,从零构建一个完整的人脸口罩检测系统。你将学到:
- 使用MobileNetV2进行迁移学习训练口罩分类器
二、核心技术原理
2.1 系统架构
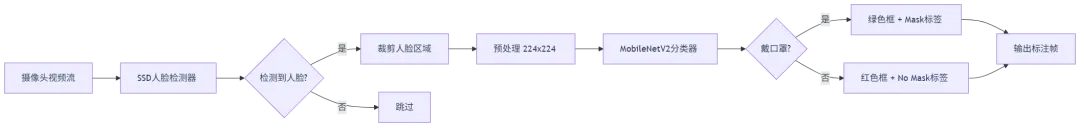
本项目采用两阶段流水线架构:
视频帧输入 → SSD人脸检测 → 人脸ROI裁剪 → MobileNetV2口罩分类 → 结果标注输出
2.2 MobileNetV2 迁移学习
为什么选择MobileNetV2?
MobileNetV2是Google提出的轻量级卷积神经网络,专为移动端和嵌入式设备设计。相比VGG16、ResNet50等大模型,MobileNetV2在保持较高精度的同时,参数量大幅减少:
迁移学习策略:
- 加载在ImageNet上预训练的MobileNetV2(不含顶层全连接层)
- 冻结基础网络的所有层(
trainable = False) AveragePooling2D(7×7)FlattenDense(128, relu)Dropout(0.5)Dense(2, softmax)
# 加载预训练MobileNetV2(不含顶层)baseModel = MobileNetV2(weights="imagenet", include_top=False, input_tensor=Input(shape=(224, 224, 3)))# 构建自定义分类头headModel = baseModel.outputheadModel = AveragePooling2D(pool_size=(7, 7))(headModel)headModel = Flatten(name="flatten")(headModel)headModel = Dense(128, activation="relu")(headModel)headModel = Dropout(0.5)(headModel)headModel = Dense(2, activation="softmax")(headModel)# 组合完整模型model = Model(inputs=baseModel.input, outputs=headModel)# 冻结基础网络层for layer in baseModel.layers: layer.trainable = False
2.3 SSD人脸检测器
人脸检测使用的是OpenCV自带的SSD (Single Shot MultiBox Detector) 模型,基于Caffe框架训练:
- 模型文件:
res10_300x300_ssd_iter_140000.caffemodel - 配置文件
- 输入尺寸
- 置信度阈值
# 加载SSD人脸检测器prototxtPath = "face_detector/deploy.prototxt"weightsPath = "face_detector/res10_300x300_ssd_iter_140000.caffemodel"faceNet = cv2.dnn.readNet(prototxtPath, weightsPath)# 检测人脸blob = cv2.dnn.blobFromImage(frame, 1.0, (300, 300), (104.0, 177.0, 123.0))faceNet.setInput(blob)detections = faceNet.forward()
三、环境搭建与数据准备
3.1 环境依赖
# requirements.txttensorflow>=1.15.2keras==2.3.1imutils==0.5.3numpy==1.18.2opencv-python==4.2.0.*matplotlib==3.2.1scipy==1.4.1
安装命令:
pip install -r requirements.txt
3.2 数据集结构
数据集包含两个类别,按目录组织:
dataset/├── with_mask/ # 戴口罩的人脸图片│ ├── 0_0_0 copy 10.jpg│ ├── 0_0_0 copy 11.jpg│ └── ...└── without_mask/ # 未戴口罩的人脸图片 ├── 0_0_caiguoqing_0130.jpg ├── 0_0_caiyilin_0024.jpg └── ...
3.3 数据增强
为提高模型泛化能力,训练时使用ImageDataGenerator进行在线数据增强:
aug = ImageDataGenerator( rotation_range=20, # 随机旋转±20度 zoom_range=0.15, # 随机缩放±15% width_shift_range=0.2, # 水平平移±20% height_shift_range=0.2, # 垂直平移±20% shear_range=0.15, # 剪切变换±15% horizontal_flip=True, # 随机水平翻转 fill_mode="nearest" # 填充模式)
四、模型训练
4.1 训练配置
4.2 完整训练代码
# train_mask_detector.py 核心逻辑# 1. 加载数据data = []labels = []for category in ["with_mask", "without_mask"]: path = os.path.join(DIRECTORY, category) for img in os.listdir(path): img_path = os.path.join(path, img) image = load_img(img_path, target_size=(224, 224)) image = img_to_array(image) image = preprocess_input(image) data.append(image) labels.append(category)# 2. 标签编码lb = LabelBinarizer()labels = lb.fit_transform(labels)labels = to_categorical(labels)# 3. 划分训练/测试集(trainX, testX, trainY, testY) = train_test_split( data, labels, test_size=0.20, stratify=labels, random_state=42)# 4. 编译模型opt = Adam(lr=INIT_LR, decay=INIT_LR / EPOCHS)model.compile(loss="binary_crossentropy", optimizer=opt, metrics=["accuracy"])# 5. 训练H = model.fit( aug.flow(trainX, trainY, batch_size=BS), steps_per_epoch=len(trainX) // BS, validation_data=(testX, testY), validation_steps=len(testX) // BS, epochs=EPOCHS)# 6. 保存模型model.save("mask_detector.model", save_format="h5")
4.3 训练结果评估
训练完成后,使用分类报告评估模型性能:
# 在测试集上评估predIdxs = model.predict(testX, batch_size=BS)predIdxs = np.argmax(predIdxs, axis=1)# 输出分类报告print(classification_report(testY.argmax(axis=1), predIdxs, target_names=lb.classes_))
训练过程中会自动保存训练曲线图 plot.png,包含:
五、实时视频流检测
5.1 检测流水线
实时检测的核心函数 detect_and_predict_mask:
def detect_and_predict_mask(frame, faceNet, maskNet): # 1. 获取帧尺寸 (h, w) = frame.shape[:2] # 2. 构建blob并进行人脸检测 blob = cv2.dnn.blobFromImage(frame, 1.0, (300, 300), (104.0, 177.0, 123.0)) faceNet.setInput(blob) detections = faceNet.forward() faces = [] locs = [] preds = [] # 3. 遍历检测结果 for i in range(0, detections.shape[2]): confidence = detections[0, 0, i, 2] if confidence > 0.5: # 置信度阈值 # 计算边界框坐标 box = detections[0, 0, i, 3:7] * np.array([w, h, w, h]) (startX, startY, endX, endY) = box.astype("int") # 确保边界框在帧内 (startX, startY) = (max(0, startX), max(0, startY)) (endX, endY) = (min(w - 1, endX), min(h - 1, endY)) # 提取人脸ROI并预处理 face = frame[startY:endY, startX:endX] face = cv2.cvtColor(face, cv2.COLOR_BGR2RGB) face = cv2.resize(face, (224, 224)) face = img_to_array(face) face = preprocess_input(face) faces.append(face) locs.append((startX, startY, endX, endY)) # 4. 批量预测 if len(faces) > 0: faces = np.array(faces, dtype="float32") preds = maskNet.predict(faces, batch_size=32) return (locs, preds)
5.2 可视化标注
检测结果使用不同颜色区分:
for (box, pred) in zip(locs, preds): (startX, startY, endX, endY) = box (mask, withoutMask) = pred # 判断是否戴口罩 label = "Mask" if mask > withoutMask else "No Mask" color = (0, 255, 0) if label == "Mask" else (0, 0, 255) # 显示概率 label = "{}: {:.2f}%".format(label, max(mask, withoutMask) * 100) # 绘制边界框和标签 cv2.putText(frame, label, (startX, startY - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.45, color, 2) cv2.rectangle(frame, (startX, startY), (endX, endY), color, 2)
5.3 主循环
# 初始化视频流vs = VideoStream(src=0).start()while True: frame = vs.read() frame = imutils.resize(frame, width=400) # 检测口罩 (locs, preds) = detect_and_predict_mask(frame, faceNet, maskNet) # 可视化结果 for (box, pred) in zip(locs, preds): # ... 绘制标注 ... cv2.imshow("Frame", frame) # 按'q'退出 if cv2.waitKey(1) & 0xFF == ord("q"): breakcv2.destroyAllWindows()vs.stop()
六、完整项目结构
Face-Mask-Detection-master/├── dataset/ # 数据集│ ├── with_mask/ # 戴口罩图片│ └── without_mask/ # 未戴口罩图片├── face_detector/ # 人脸检测模型│ ├── deploy.prototxt # SSD网络配置│ └── res10_300x300_ssd_iter_140000.caffemodel # 预训练权重├── train_mask_detector.py # 训练脚本├── detect_mask_video.py # 实时检测脚本├── mask_detector.model # 训练好的口罩检测模型├── plot.png # 训练曲线图└── requirements.txt # 依赖列表
七、常见错误与解决方案
错误1:TensorFlow版本兼容性问题
现象:
AttributeError: module 'tensorflow' has no attribute 'keras'
原因:TensorFlow 2.x中Keras已集成,导入方式不同。
解决方案:
# 错误写法(TF 1.x风格)import keras# 正确写法(TF 2.x)from tensorflow import keras# 或from tensorflow.keras.models import load_model
错误2:OpenCV无法读取摄像头
现象:
error: (-215:Assertion failed) !_src.empty() in function 'cv::cvtColor'
原因:摄像头索引不正确或摄像头被占用。
解决方案:
# 尝试不同的摄像头索引vs = VideoStream(src=0).start() # 尝试 0, 1, 2...# 或使用视频文件测试vs = cv2.VideoCapture("test_video.mp4")
错误3:模型文件路径问题
现象:
OSError: Unable to open file (unable to open file: name = 'face_detector/deploy.prototxt')
原因:工作目录不正确,相对路径找不到文件。
解决方案:
import os# 使用绝对路径base_dir = os.path.dirname(os.path.abspath(__file__))prototxtPath = os.path.join(base_dir, "face_detector", "deploy.prototxt")
错误4:GPU内存不足
现象:
ResourceExhaustedError: OOM when allocating tensor
原因:批次大小过大或GPU内存不足。
解决方案:
# 减小批次大小BS = 16 # 从32降到16# 或使用CPU训练import osos.environ["CUDA_VISIBLE_DEVICES"] = "-1"
八、优化建议
8.1 性能优化
8.2 精度优化
- 微调基础网络
- 增加数据
- 模型集成
- 调整阈值
8.3 部署优化
# 解冻部分层进行微调(提升精度)for layer in baseModel.layers[-20:]: # 解冻最后20层 layer.trainable = True# 使用更小的学习率进行微调opt = Adam(lr=INIT_LR / 10, decay=(INIT_LR / 10) / EPOCHS)
九、总结
本文从零开始构建了一个完整的人脸口罩检测系统,核心要点回顾:
- 两阶段架构:SSD人脸检测 + MobileNetV2口罩分类,兼顾速度与精度
- 迁移学习:利用ImageNet预训练权重,在小数据集上快速收敛
- 数据增强
- 实时处理
这个项目虽然代码量不大(两个核心脚本不到200行),但完整覆盖了计算机视觉项目的标准流程:数据准备 → 模型训练 → 评估 → 部署推理。非常适合作为CV入门实战项目。
下一篇预告:我们将继续探索30个计算机视觉项目中的下一个——YOLOR卡片目标检测,看看最新的YOLO变体如何在保持实时性的同时提升检测精度。
参考链接
 10个月宝宝每天需要喝多少奶粉?