Python实现空间移动窗口+时间序列逐像元的RF+shap分析识别出主要驱动因子
- 2026-10-11 06:12:05
Python实现空间移动窗口+时间序列逐像元的RF+shap分析识别出主要驱动因子
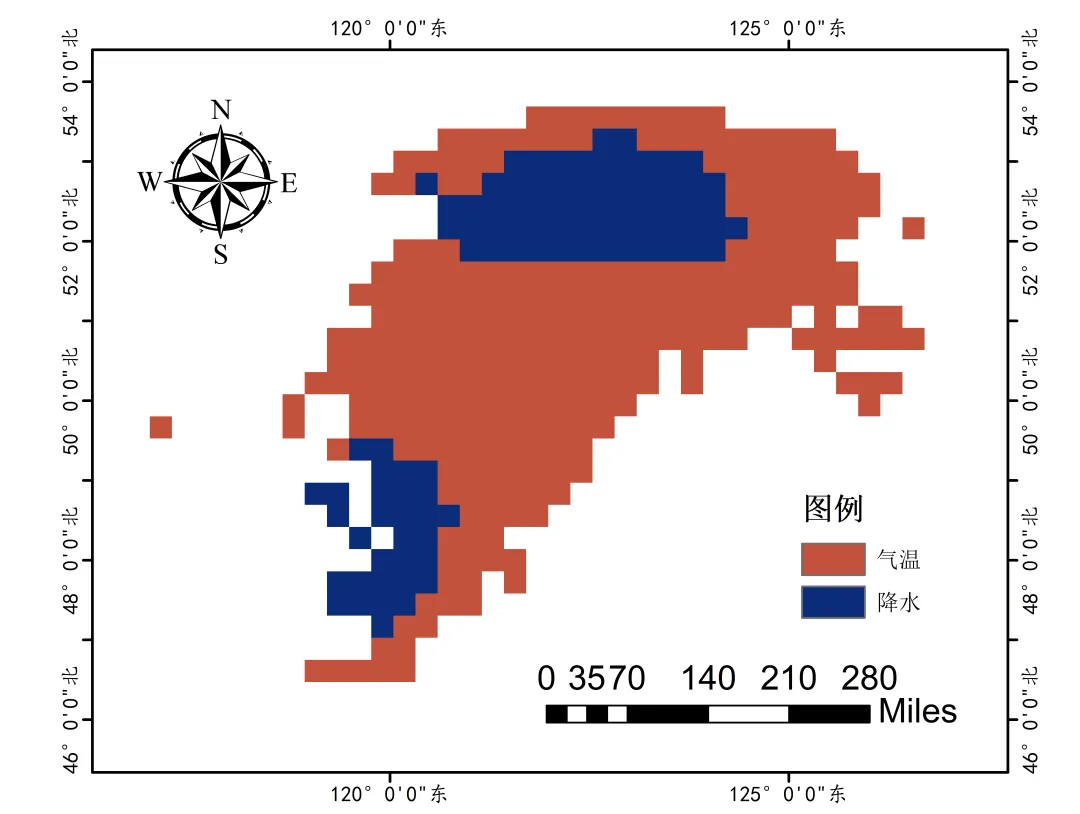
代码执行的主要逻辑,有40年影像数据,包括降水、气温、日照等数据的年均值,降水十目标,其他是特征,读取这些数据来进行匹配,通过提取时空滑动窗口数据来扩充样本量,时空滑动窗口就是说对于每一个像元,要以这个像元作为中心,往外扩充,提取周围的像元,比如5*5,3*3,把这个范围内的所有像元包括时间序列的数据都提取出来作为机器学习的数据集,来构建模型进行分析,利用 SHAP来解析各特征对结果的贡献度,将分析的结果作为中心像元的结果输出。最终就可以得到每一个像元最重要的影响因子。需要注意的有几点就是,首先是文件的命名必须是2002JS、2003RZ这种的年份+时间的形式,另外就是要根据数据来设置并行处理的数量,还有如果你的数据达到km级的话,要弄个运存大点的电脑,不然会崩。 
库的导入以及字体设置 
基础配置参数,主要的修改部分都集中在了这个部分,包括目标与特征定义,有效数据范围定义,因为栅格数据有背景值有时候会读取进来,输出结果的路径,模型的参数设置 
栅格数据读取函数,读取单张的tif数据,并将文件定义的 NoData转换为的 NaN,方便后续计算时自动忽略 
分析结果保存为栅格数据的函数,将计算结果,如 R2 矩阵、SHAP 值保存为tif 文件。继承原始数据的地理坐标系和投影信息,确保跟输入数据一样。 
文件查找的函数,通过正则表达式自动匹配文件夹中的文件。 
加载并堆叠数据的函数,将某一个变量的所有年份数据读取进来,根据设定的有效范围清洗异常值,然后堆叠成一个三维数组 (时间, 行, 列)。为了后续方便按时间序列提取数据。 
提取空间窗口,辅助函数,用于从二维空间中取出一个以 (row, col) 为中心的小方块。比如5*5,3*3 
单行处理函数,核心部分,主要的分析执行部分,实现了逐像元建模。 对于图像中的每一个像元位置,它不仅看该像元本身,还看它周围的邻域以及所有的历史年份。将这些时空数据展平,形成一个机器学习数据集。利用 
excel数据保存函数,将栅格数据的结果以excel的形式保存 
主运行函数,负责调用前面的函数加载数据并对齐时间。根据图像的高度将任务切分,收集所有子进程算出来的每一行结果,拼装成完整的栅格图,保存 
期刊图片复现|Python绘制二维偏依赖PDP图 期刊复现|python绘制基于SHAP分析和GAM模型拟合的单特征依赖图 期刊图片复现|python绘制带有渐变颜色shap特征重要性组合图(条形图+蜂巢图) 期刊复现|用Python绘制SHAP特征重要性总览图、依赖图、双特征交互效应SHAP图,解锁XGBoost模型的终极奥秘 期刊图片复现|Python绘制shap重要性蜂巢图+单特征依赖图+交互效应强度气泡图+交互效应依赖图(回归+二分类+分类) 
需要的请后台私信我获取详细信息,注意只会分享练习数据和代码文件,不会提供答疑服务,代码文件中已经包含了每行代码的完整注释!!
代码输出成果展示
代码解释
第一部分
# =========================================================================================# ====================================== 1. 环境设置 =======================================# =========================================================================================import osimport reimport numpy as npimport rasteriofrom tqdm import tqdmfrom sklearn.ensemble import RandomForestRegressorfrom sklearn.metrics import r2_score, mean_squared_errorimport shapfrom concurrent.futures import ProcessPoolExecutorimport multiprocessingfrom sklearn.model_selection import train_test_split, GridSearchCVimport pandas as pd
第二部分
# =========================================================================================# ======================================2.基础参数配置 =======================================# =========================================================================================output_dir = r"3_CenterPixelCheck" #输出路径os.makedirs(output_dir, exist_ok=True) #创建输出目录target_var_name = "JS" #目标变量feature_var_names = ["QW", "RZ"] #特征变量#将特征变量名映射到特定的数字标签,用于最后的结果feature_numerical_labels = {"QW": 1,"RZ": 2,}#量的有效数据范围valid_ranges = {"JS": (0, 100),"QW": (-100, 100),"RZ": (0, 1000),}#最少有效时间序列长度min_observations_required = 10#每个变量对应的栅格数据文件所在的文件夹路径variable_folder_paths = {"JS": r"JS","QW": r"QW","RZ": r"RZ",}# 定义随机森林的超参数搜索空间param_grid = {'n_estimators': [5, 10],'max_depth': [1]}#定义随机森林回归模型的参数rf_params = {'random_state': 0,'n_jobs': 1}excel_output_dir = os.path.join(output_dir, "excel_output") #Excel输出目录os.makedirs(excel_output_dir, exist_ok=True) #创建Excel输出目录#主要是怕数据太多一个装不下MAX_ROWS_PER_EXCEL = 1000000 #设置每个Excel文件的最大行数current_excel_file_index = 0 #当前Excel文件索引excel_data = [] #用于存储当前批次的Excel数据WINDOW_SIZE = 5 #窗口设置
第三部分
# =========================================================================================# ====================================== 3. 读取栅格数据的函数=======================================# =========================================================================================def read_raster(path):with rasterio.open(path) as src: #使用rasterio打开指定路径的栅格文件data = src.read(1).astype(np.float32) #读取第一个波段的数据,并将其数据类型转换为float32nodata = src.nodata # 获取栅格文件定义的NoData值if nodata is not None: # 如果文件定义了NoData值data[data == nodata] = np.nan # 将数组中等于NoData值的所有像元替换为NumPy的NaNreturn data, src.meta # 返回读取的数据数组和栅格文件的元数据信息
第四部分
# =========================================================================================# ====================================== 4. 写入栅格数据的函数=======================================# =========================================================================================def write_raster(path, array, meta):meta_copy = meta.copy() # 复制元数据字典,以避免修改原始元数据# 更新元数据meta_copy.update({'count': 1, #输出栅格的波段数为1'dtype': 'float32', #输出栅格的数据类型'nodata': np.nan, #输出栅格的NoData值'compress': 'lzw' #输出栅格的压缩方式})with rasterio.open(path, 'w', **meta_copy) as dst: #以写入模式('w')打开指定路径的栅格文件,并传入更新后的元数据dst.write(array.astype(np.float32), 1) # 将数据数组转换为float32类型后写入栅格文件的第一个波段
第五部分
# =========================================================================================# ====================================== 5.查找特定变量相关文件的函数=======================================# =========================================================================================def find_variable_files(var_name_to_match, specific_variable_folder_path):matched = {} #用于存储匹配到的年份及其对应的文件路径#正则表达式,用于匹配文件名格式:年份 + 变量名 + ".tif"或".tiff"pattern = re.compile(r"(\d{4})" + re.escape(var_name_to_match) + r"\.(tif|tiff)", re.IGNORECASE)for root, _, files in os.walk(specific_variable_folder_path): # 遍历指定文件夹及其所有子文件夹for file in files: # 遍历当前文件夹下的所有文件m = pattern.fullmatch(file) #匹配当前文件名if m: # 如果文件名与模式完全匹配year = m.group(1) # 提取正则表达式捕获的第一个组,即四位数字年份matched[year] = os.path.join(root, file) # 将年份和对应的完整文件路径存入字典return matched # 返回包含年份和文件路径的字典
第六部分
# =========================================================================================# =========================6.定义加载变量栅格数据堆栈并进行过滤的函数=======================================# =========================================================================================def load_variable_stack(var_name, paths_config, range_dict):if var_name not in paths_config: # 检查变量名是否存在于路径配置字典中raise FileNotFoundError(f"未配置变量 '{var_name}' 路径")files_map = find_variable_files(var_name, paths_config[var_name]) # 查找该变量对应的所有栅格文件if not files_map: # 如果没有找到文件raise FileNotFoundError(f"在路径 '{paths_config[var_name]}' 中没有找到变量 '{var_name}' 的文件。")dates = sorted(files_map.keys()) # 获取所有文件的年份并进行排序stack = [] #用于存储读取的各年份栅格数据数组meta0 = None #用于存储第一个读取的栅格文件的元数据作为参考,用于数据结果使用vmin, vmax = range_dict[var_name] #获取该变量的有效值范围 (最小值, 最大值)for d in tqdm(dates, desc=f"加载 {var_name}"): #遍历排序后的年份,使用tqdm显示加载进度arr, meta = read_raster(files_map[d]) # 读取对应年份的栅格数据和元数据invalid = (arr < vmin) | (arr > vmax) # 创建一个布尔掩码,标记出超出有效值范围的像元arr[invalid] = np.nan # 将无效像元的值设为NaNif meta0 is None: # 如果是第一次读取文件meta0 = meta # 保存当前文件的元数据作为参考元数据stack.append(arr) # 将处理后的数据数组添加到堆栈列表中if not stack: # 如果没有加载到任何数据raise ValueError(f"'{var_name}' 没有加载到任何数据") #抛出值错误return np.stack(stack), dates, meta0 # 将列表中的所有数组堆叠成一个NumPy数组,并返回该数组、年份列表和参考元数据
第七部分
# =========================================================================================# =========================7. 提取窗口数据的函数=======================================# =========================================================================================def extract_window(data, row, col, window_radius, padding_value_unused):height, width = data.shape # 获取栅格数据的高度和宽度# 计算窗口的边界row_start = max(0, row - window_radius) # 窗口起始行索引row_end = min(height, row + window_radius + 1) # 窗口结束行索引col_start = max(0, col - window_radius) # 窗口起始列索引col_end = min(width, col + window_radius + 1) # 窗口结束列索引# 提取窗口区域的数据window = data[row_start:row_end, col_start:col_end]return window # 返回提取的窗口数据
第八部分
GridSearchCV 自动调参训练随机森林模型。计算 R2 和 RMSE 。利用 SHAP 计算每个特征对预测结果的贡献,并找出谁是主导因子。最后返回这一行的所有计算结果。# =========================================================================================# =========================8. 定义处理栅格数据中单行的函数======================================# =========================================================================================def process_row(args):(i, H, W, target, feats, data_dict, min_samples_for_window_model,model_params_dict, feature_labels_param, param_grid,current_window_radius, current_padding_value, min_valid_points_for_center_target_ts) = args# 初始化当前这一行对应的结果数组(R2, RMSE, SHAP等),默认都是NaNmodel_data = [] # 用于收集要写入Excel的详细数据for j in range(W): # 遍历这一行中的每一个像元(列循环)y_center_pixel_timeseries = y_stack[:, i, j]if np.sum(~np.isnan(y_center_pixel_timeseries)) < min_valid_points_for_center_target_ts:continue# 提取目标变量(Y)在所有时间步的空间窗口y_pixel_windows_at_t = [extract_window(y_stack[t, :, :], i, j, current_window_radius, current_padding_value).flatten()for t in range(y_stack.shape[0])]valid_mask = ~np.isnan(y_pixel) & ~np.isnan(X_pixel).any(axis=1) # 去除包含NaN的样本if valid_mask.sum() < min_samples_for_window_model: # 样本量不足则跳过continueyv = y_pixel[valid_mask]Xv = X_pixel[valid_mask]# 检查方差是否为0(如果是常数,无法训练)if np.nanstd(yv) == 0 or any(np.nanstd(Xv[:, k]) == 0 for k in range(Xv.shape[1])):continue# 划分训练/验证集X_train, X_val, y_train, y_val = train_test_split(Xv, yv, test_size=0.3, random_state=0)# 使用网格搜索(GridSearchCV)寻找最佳超参数grid_search = GridSearchCV(RandomForestRegressor(random_state=0, n_jobs=1),param_grid, cv=2, scoring='r2', n_jobs=1)grid_search.fit(X_train, y_train)best_model = grid_search.best_estimator_ # 获取最佳模型pred = best_model.predict(X_val)r2_current = r2_score(y_val, pred)rmse_current = np.sqrt(mean_squared_error(y_val, pred))# 将结果存入数组r2_r[j] = r2_currentrmse_r[j] = rmse_currentexplainer = shap.TreeExplainer(best_model)shap_values_pixel_all_points = explainer.shap_values(Xv)# 计算平均 SHAP 值,代表特征对结果的平均影响方向和强度mean_shap_for_pixel_model = np.nanmean(shap_values_pixel_all_points, axis=0)mean_abs_shap_for_pixel_model = np.nanmean(np.abs(shap_values_pixel_all_points), axis=0)model_data.append({ ... })return i, r2_r, rmse_r, shap_values_r, shap_values_abs_r, max_shap_feature_label_r, model_data
第九部分
# =========================================================================================# =========================9. excel文件保存函数=====================================# =========================================================================================def save_to_excel(data, filename):output_dir_excel = os.path.dirname(filename) #获取文件名所在目录if not os.path.exists(output_dir_excel): # 如果目录不存在os.makedirs(output_dir_excel, exist_ok=True) #创建目录df = pd.DataFrame(data) # 将数据列表转换为pandas DataFramedf.to_excel(filename, index=False, engine='openpyxl') # 保存到Excel文件
第十部分
# =========================================================================================# =========================10主运行函数=====================================# =========================================================================================def run_parallel():global current_excel_file_index, excel_data# 将每一行作为一个独立的任务包tasks = [(r_idx, H, W, target_var_name, feature_var_names, aligned_data, ... ) for r_idx in range(H)]num_workers = min(multiprocessing.cpu_count(), H, 8 if H > 16 else H if H > 0 else 1) # 智能计算并行进程数print(f"使用 {num_workers} 个进程并行计算...")#开始并行计算with ProcessPoolExecutor(max_workers=num_workers) as executor:# executor.map 会自动将任务分发给多个 CPU 核心results_list = list(tqdm(executor.map(process_row, tasks), total=H, desc="逐行随机森林、SHAP与最大特征分析"))# 初始化全图大小的空数组r2_map = np.full((H, W), np.nan, dtype=np.float32)for r_idx_res, r2_row, rmse_row, shap_row, ... in results_list:# 将每一行的计算结果填回全图数组中对应的位置r2_map[r_idx_res, :] = r2_row# 处理 Excel 数据,如果数据量过大分卷保存excel_data.extend(model_data_list_for_row)while len(excel_data) >= MAX_ROWS_PER_EXCEL:# 保存最后的 Excel 数据if excel_data:save_to_excel(...)#输出最终的栅格图像write_raster(..., r2_map, meta_ref)
如何应用?
1.设置输出结果的路径:
output_dir = r"RF_SHAP" 2.定义目标:
target_var_name = "JS" #目标变量3.定义特征:
feature_var_names = ["QW", "RZ"] #特征变量4.设置变量的有效数据范围:
valid_ranges = { "JS": (0, 100), "QW": (-100, 100), "RZ": (0, 1000),}5.设置特征对应的数值:
feature_numerical_labels = { "QW": 1, "RZ": 2,}6.定义一下时间序列最短的范围:
min_observations_required = 107.定义原始文件路径:
variable_folder_paths = {"JS": r"\JS","QW": r"QW","RZ": r"\RZ",}
8.定义模型的超参数:
param_grid = { 'n_estimators': [5, 10], 'max_depth': [1]}推荐
获取方式
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
