期刊图片复现|Python绘制RF重要性分析与相关性热力图
- 2026-10-11 06:15:47
期刊图片复现|Python绘制RF重要性分析与相关性热力图
论文:Deficit irrigation alleviates the increase in soil salinity content in saline-alkali regions of China and improves irrigation water productivity: A meta-analysis 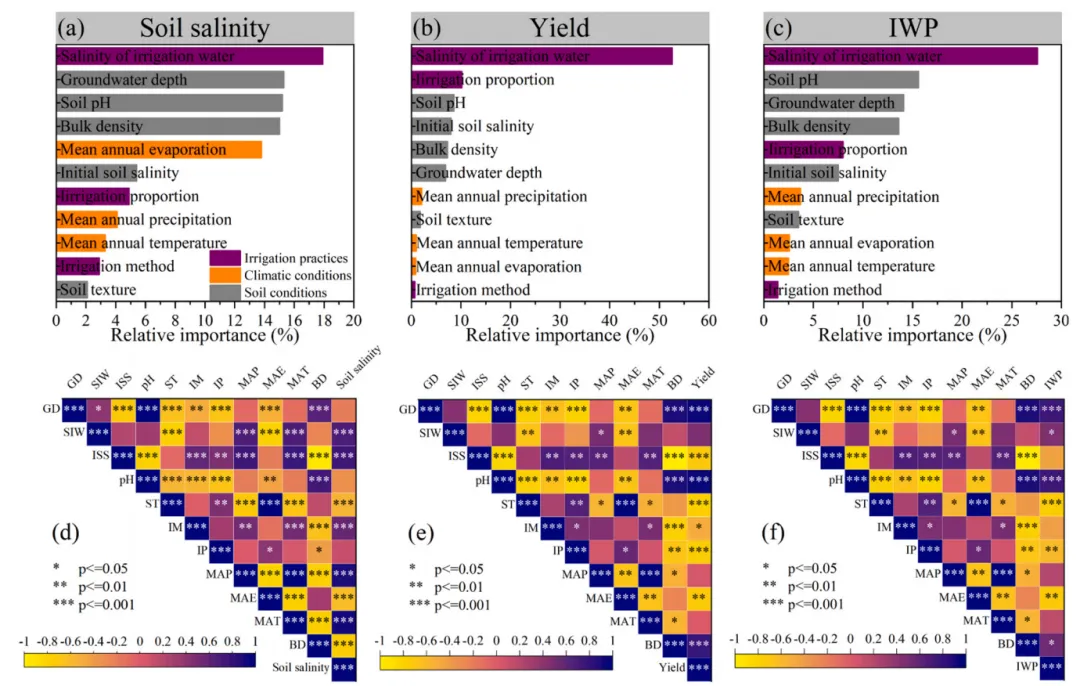
多种配色 利用随机森林模型(a-c)与皮尔逊相关性分析(d-f),综合揭示了灌溉措施(紫色)、土壤条件(灰色)及气候条件(橙色)对盐碱地土壤盐分含量、作物产量和灌溉水生产力的相对重要性及其相互关联。分析结果表明,SIW是决定这三个目标变量的最核心驱动因子,处于绝对主导地位,同时也是影响IWP和土壤盐分的首要因素;紧随其后的是土壤条件,而气候条件的整体影响力相对较弱。相关性热力图进一步印证了这一点。 注意,此为个人理解,可能存在错误,具体内容还请阅读原文进行理解。 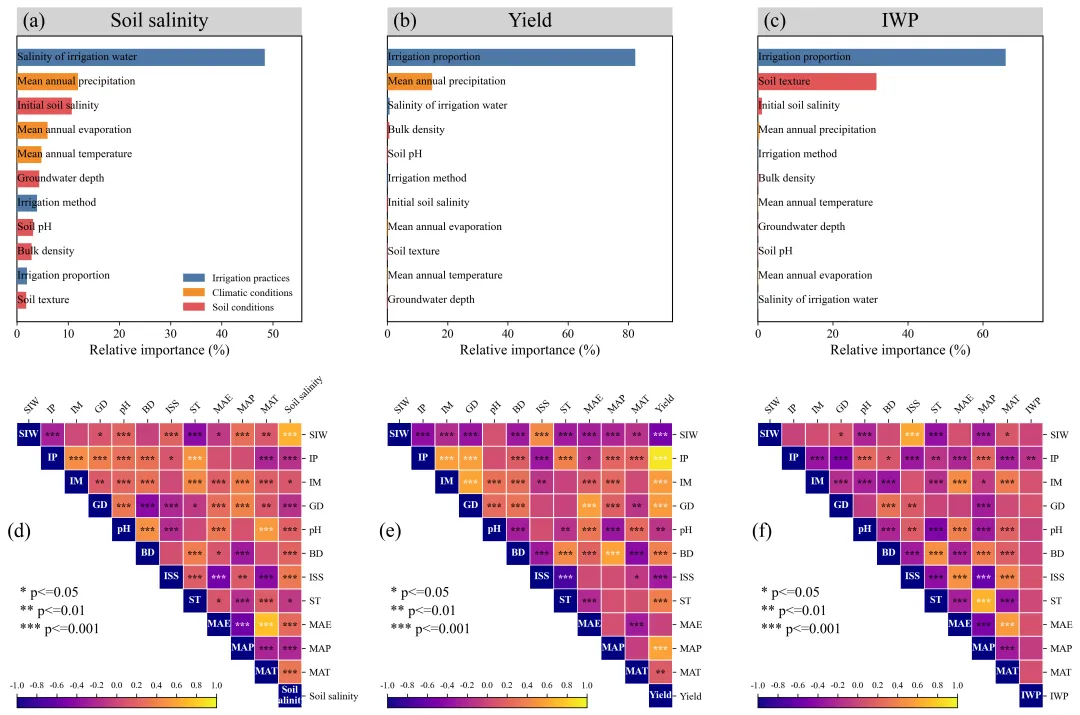
多种配色 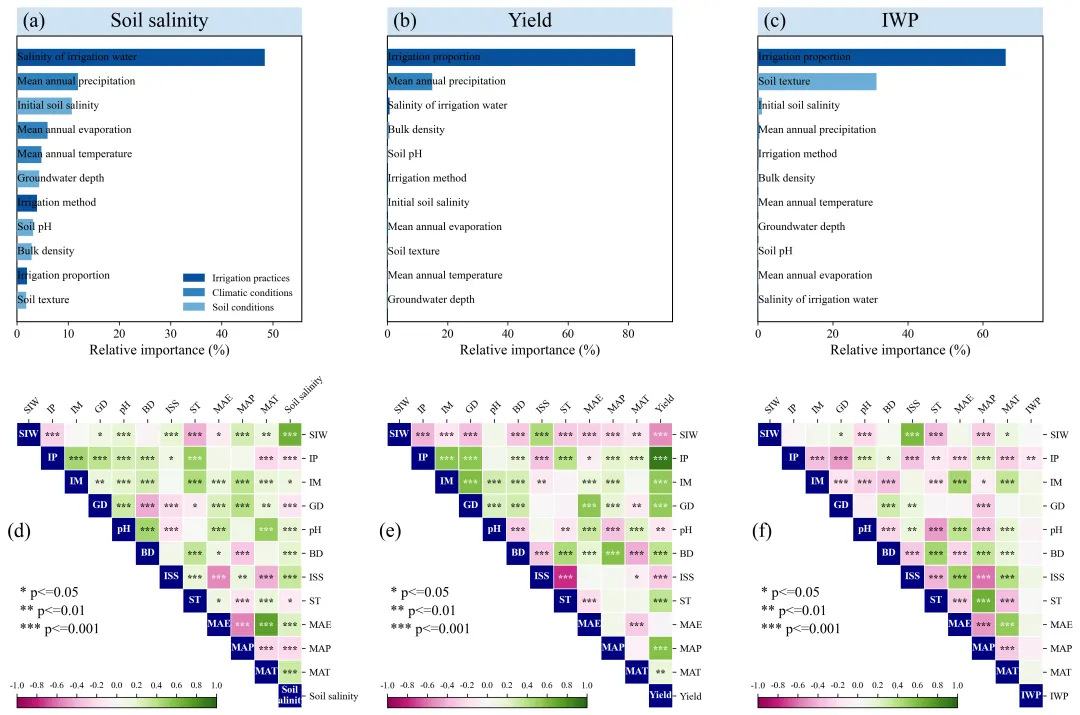
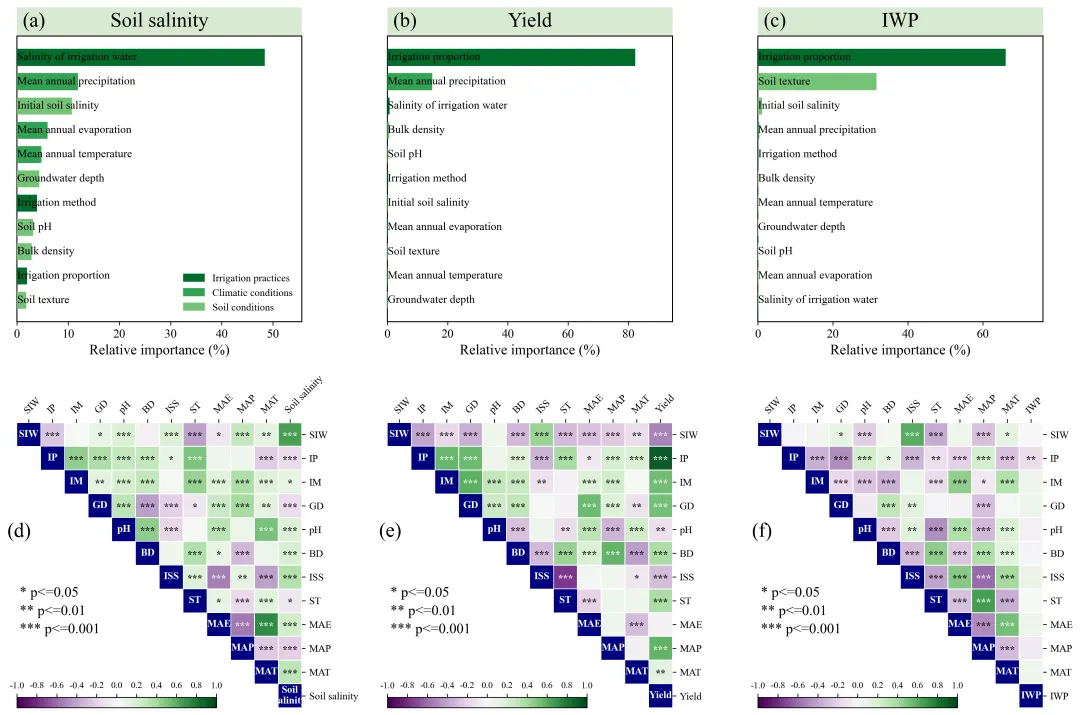
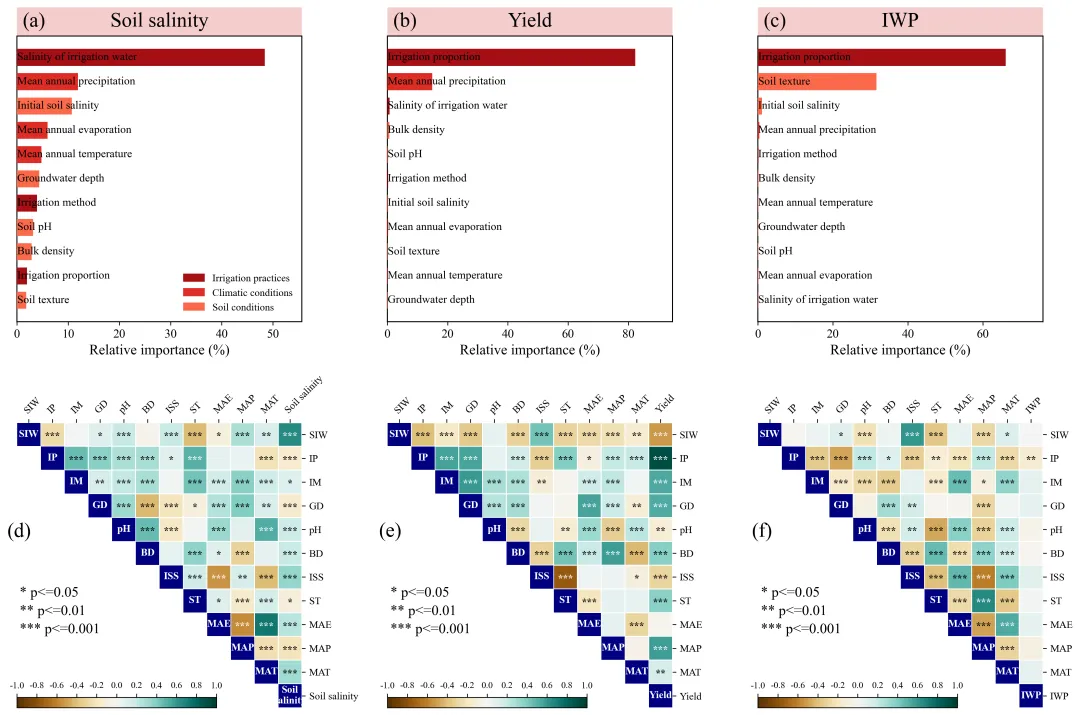
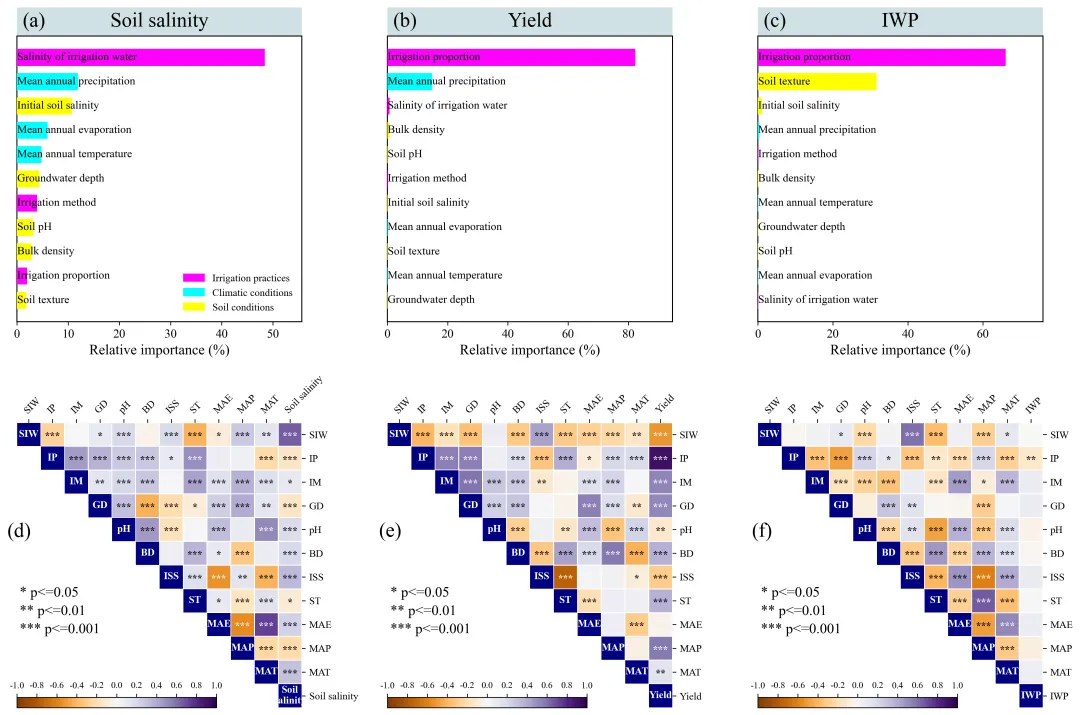
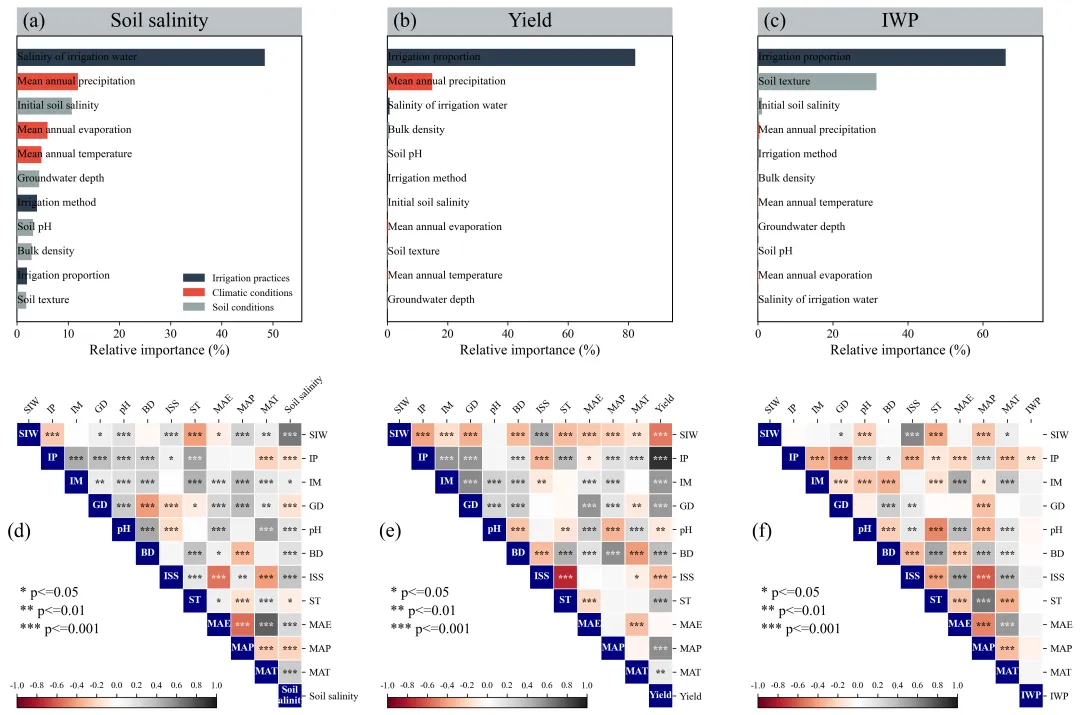
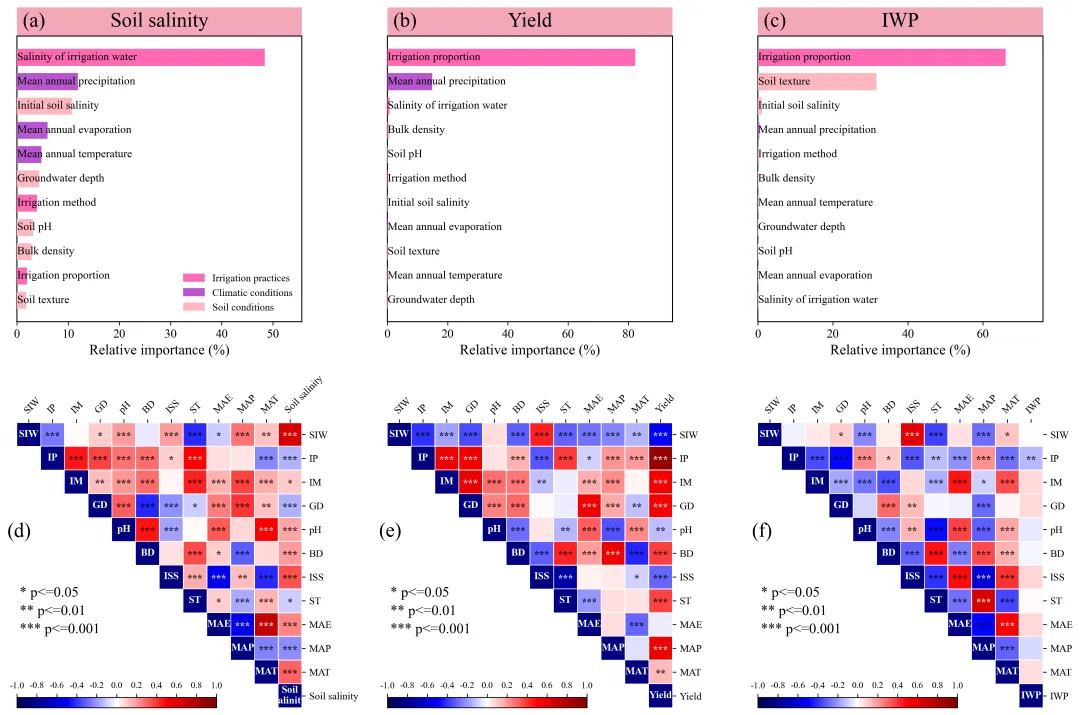
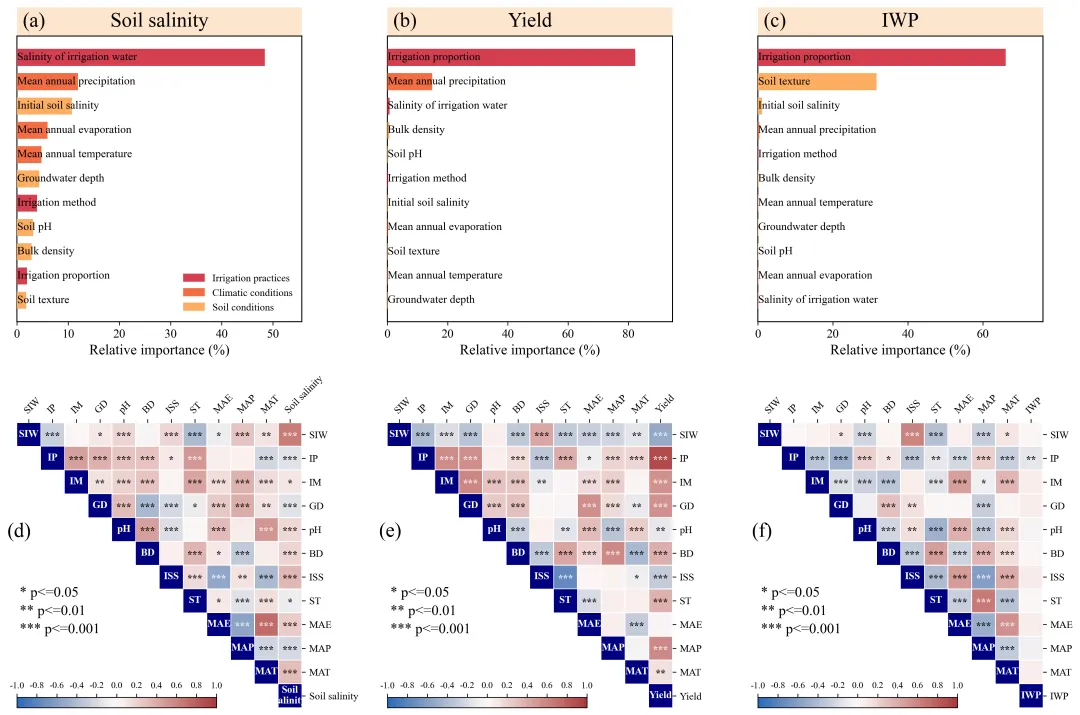
多种配色 
库的导入以及字体设置 
相关性分析方法与变量信息配置,通过数字 1, 2, 3 控制使用哪种相关性计算方法,同时通过一个数据字典映射了变量简称到全称,还定义了每个变量的类别。用于在后续绘制条形图时,决定了条形图的颜色分组。 
颜色库的设置以及配色方案的选择 
期刊图片复现|Python绘制SHAP重要性玫瑰图+相关性网络图组合图 期刊图片复现|Python绘制XGB+SHAP特征重要性条形图+蜂巢图+玫瑰图组合图 期刊图片复现|Python绘制基于边缘分布与残差分析的回归拟合图 期刊图片复现|Python绘制XGB+SHAP特征重要性排序+依赖组合图 Python绘制GAM模型非线性交互效应等高线热力图(带有峰值区间和谷值区间) 
需要的请后台私信我,注意只会分享练习数据和代码文件,不会提供答疑服务,代码文件中已经包含了每行代码的完整注释!!!
代码绘制成果展示
代码解释
第一部分
# =========================================================================================# ====================================== 1. 环境设置 =======================================# =========================================================================================import matplotlib.pyplot as pltimport seaborn as snsimport pandas as pdimport numpy as npimport matplotlib.patches as mpatchesfrom sklearn.ensemble import RandomForestRegressorfrom sklearn.model_selection import train_test_split, GridSearchCVfrom sklearn.metrics import r2_scorefrom scipy.stats import pearsonr, spearmanr, kendalltau
第二部分
# =========================================================================================# ======================================2.相关性分析方法设置=======================================# =========================================================================================# 相关性方法库method_map = {1: 'pearson',2: 'spearman',3: 'kendall'}CORRELATION_METHOD = 1 # 定义相关性分析的方法# 获取当前选择的方法名称selected_method = method_map.get(CORRELATION_METHOD, 'pearson')
第三部分
# =========================================================================================# ======================================3.颜色库=======================================# =========================================================================================COLOR_SCHEMES = {1: {'colors': {'Irrigation practices': '#800080', 'Climatic conditions': '#FF8C00', 'Soil conditions': '#808080'},'heatmap': 'viridis','title_bg': '#BFBFBF'},}CURRENT_SCHEME_ID = 40 # 定义当前使用的配色方案
第四部分
特征重要性条形图绘制函数:数据准备,负责将输入的特征重要性字典转换为可视化的 DataFrame,并分配颜色。
# =========================================================================================# ======================================4.条形图绘制函数======================================# =========================================================================================def draw_bar_chart(ax, imp_dict, title, label_char, color_palette, title_bg_color):plot_data = [] # 初始化绘图数据列表for abbr, value in imp_dict.items(): # 遍历特征重要性字典info = VAR_INFO.get(abbr) # 获取变量的类别信息if info:plot_data.append({'Variable': info['name'], # 变量'Value': value, # 重要性'Category': info['cat'] # 类别})df_plot = pd.DataFrame(plot_data) #转换为 DataFramedf_plot['Color'] = df_plot['Category'].map(color_palette) # 根据类别映射颜色
第五部分
特征重要性条形图绘制函数:绘制水平条形图并添加自定义的标题背景。
# 按照重要性数值排序df_plot = df_plot.sort_values('Value', ascending=True)# 绘制水平条形图bars = ax.barh(df_plot['Variable'], #y轴df_plot['Value'], #x轴color=df_plot['Color'], # 颜色height=0.7, # 高度zorder=3)# 标题ax.text(0.5, #x1.05, #ytitle, # 文本transform=ax.transAxes, # 轴坐标系ha='center', # 水平va='center', # 垂直fontsize=20, # 字体大小color='black', # 字体颜色zorder=5)
第六部分
特征重要性条形图绘制函数:图表的细节调整,包括去除默认坐标轴、添加数值标签、设置子图编号等。
ax.set_yticks([]) # 去掉 y 轴刻度线for bar, label in zip(bars, df_plot['Variable']): # 遍历每个条形和标签# 添加特征名称ax.text(0.05, # xbar.get_y() + bar.get_height() / 2, # ylabel, # 标签文本ha='left', # 左对齐va='center', # 垂直fontsize=11, # 字体大小color='black') # 字体颜色#子图编号ax.text(0.02, #x 坐标1.05, #y 坐标f'({label_char})', #子图编号文本transform=ax.transAxes, # 轴坐标系fontsize=20, # 字体大小fontweight='normal', # 字体粗细va='center', # 垂直居中ha='left', # 左对齐zorder=6)
第七部分
特征重要性条形图绘制函数:图例设置
if label_char == 'a': # 仅在第一个子图中添加图例patches = [mpatches.Patch(color=v, label=k) for k, v in color_palette.items()] # 创建图例色块ax.legend(handles=patches, # 图例句柄loc='lower right', # 位置fontsize=10, # 字体大小frameon=False, # 不显示图例边框bbox_to_anchor=(1.0, 0.0)) #位置
第八部分
热力图绘制函数: 创建下三角掩膜,遮盖下三角,只显示上三角部分,绘制热图
# =========================================================================================# ======================================5.热力图的绘制函数======================================# =========================================================================================def draw_heatmap(ax, corr_df, p_val_df, label_char, cmap_name):mask = np.tril(np.ones_like(corr_df, dtype=bool), k=-1) # 创建下三角掩膜# 绘制热图sns.heatmap(corr_df, # 据mask=mask, # 掩膜annot=False, # 不自动标注数值fmt=".2f", # 数值格式cmap=cmap_name, # 颜色映射vmin=-1, # 最小值vmax=1, # 最大值center=0, # 中心值square=True, # 单元格设为正方形linewidths=0.5, # 分隔线宽度cbar=False, # 不显示默认颜色条ax=ax) # 指定绘制的轴
第九部分
热力图绘制函数:显著性标注,遍历矩阵,根据 P 值在热图格子上添加星号 ,表示相关性的显著程度。
for i in range(corr_df.shape[0]): # 遍历行for j in range(corr_df.shape[1]): # 遍历列if text and i != j: # 如果有标记且不是对角线ax.text(j + 0.5, # x 坐标i + 0.6, # y 坐标text, # 文本内容ha='center', # 水平居中va='center', # 垂直居中color='white' if abs(corr_df.iloc[i, j]) > 0.5 else 'black', # 根据背景深浅自动调整字体颜色fontsize=10, # 字体大小fontweight='bold') # 加粗
第十部分
热力图绘制函数:设置对角线变量名
n = len(corr_df) # 特征数量for i in range(n): # 遍历对角线位置# 创建矩形,位置在对角线rect = mpatches.Rectangle((i, i), #位置1, # 宽度1, # 高度fill=True, # 填充color='#000080', # 填充颜色i + 0.5, # y 坐标label, # 文本内容ha='center', # 水平居中va='center', # 垂直居中color='white', # 字体颜色fontsize=10, # 字体大小fontweight='bold') # 字体加粗
第十一部分
热力图绘制函数:细节调整,整理坐标轴标签的位置,添加子图编号和显著性说明图例。
ax.xaxis.tick_top() # 将 x 轴刻度移至顶部ax.xaxis.set_label_position('top') # 设置 x 轴标签位置为顶部# 设置 x 轴刻度标签ax.set_xticklabels(corr_df.columns, rotation=45,ha='left',rotation_mode='anchor')ax.yaxis.tick_right() # 将 y 轴刻度移至右侧ax.yaxis.set_label_position('right') # 设置 y 轴标签位置为右侧# 添加显著性的说明文本sig_text = "* p<=0.05\n** p<=0.01\n*** p<=0.001"ax.text(0.01, # x 坐标0.25, # y 坐标sig_text, # 文本内容transform=ax.transAxes, # 使用轴坐标系fontsize=14, # 字体大小ha='left', # 左对齐va='bottom', # 底部对齐linespacing=1.5) # 行间距
第十二部分
主程序:数据加载与预处理,定义了三个目标变量对应的文件,并开始循环读取数据。
# =========================================================================================# ======================================6.执行部分======================================# =========================================================================================if __name__ == "__main__":plot_results = [] # 初始化结果列表,用于存储绘图所需数据# 目标变量target_configs = [{'name': 'Soil salinity', 'file': 'region_data_1.xlsx'},{'name': 'Yield', 'file': 'region_data_2.xlsx'},{'name': 'IWP', 'file': 'region_data_3.xlsx'}]base_path = r'热力图' #原始数据的路径for config in target_configs: # 遍历每个文件和目标target_name = config['name'] # 目标变量file_name = config['file'] # 文件名file_path = os.path.join(base_path, file_name) # 文件路径df = pd.read_excel(file_path) # 读取数据文件features_cols = list(VAR_INFO.keys()) # 获取特征名X = df[features_cols] # 特征y = df[target_name] # 目标
第十三部分
主程序:随机森林建模与网格搜索,执行机器学习流程。使用网格搜索(GridSearchCV)来优化随机森林回归模型的超参数。通过 3 折交叉验证 ,尝试 所有参数组合,寻找性能最佳的模型。打印测试集上的 R2 分数,确认模型预测能力
# 划分训练集和测试集X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# 超参数网格param_grid = {'n_estimators': [100, 200],'max_depth': [None, 10, 20],'min_samples_leaf': [1, 2],'max_features': ['sqrt', 'log2', None]}# 初始化RF回归器rf_base = RandomForestRegressor(random_state=42)# 初始化网格搜索grid_search = GridSearchCV(estimator=rf_base, param_grid=param_grid, cv=3, n_jobs=-1, verbose=0)grid_search.fit(X_train, y_train) # 在训练集上进行拟合best_rf = grid_search.best_estimator_ # 最佳模型#评估模型score = r2_score(y_test, best_rf.predict(X_test))print(f" 最佳模型 R2 Score: {score:.3f}")
第十四部分
主程序:计算特征重要性
# 获取特征重要性importances = best_rf.feature_importances_# 将重要性归一化为百分比importances = 100.0 * (importances / importances.sum())# 创建特征名到重要性的字典imp_dict = dict(zip(X.columns, importances))
第十五部分
主程序:计算特征与目标变量之间的相关系数矩阵,并计算对应的 P 值矩阵用于显著性检验。
cols = features_cols + [target_name] # 定义相关性分析的列df_subset = df[cols].copy() # 提取相关数据子集corr_matrix = df_subset.corr(method=selected_method) # 计算相关性矩阵p_matrix = pd.DataFrame(np.zeros_like(corr_matrix), columns=cols, index=cols) # 初始化 P 值矩阵else:_, p = pearsonr(vec_x, vec_y)p_matrix.loc[c1, c2] = pplot_results.append({'imp': imp_dict, # 重要性'corr': corr_matrix, # 相关性'p_val': p_matrix, # P 值'title': target_name # 标题})
第十六部分
主程序:组合图绘制与布局
current_config = COLOR_SCHEMES.get(CURRENT_SCHEME_ID, COLOR_SCHEMES[1]) # 获取当前配色配置current_palette = current_config['colors'] # 获取颜色调色板current_heatmap_cmap = current_config['heatmap'] # 获取热力图颜色映射current_title_bg = current_config['title_bg'] # 获取标题背景色# 创建画布fig = plt.figure(figsize=(18, 14))# 创建网格布局draw_heatmap(ax4, plot_results[0]['corr'], plot_results[0]['p_val'], "d", current_heatmap_cmap)ax5 = fig.add_subplot(gs[1, 1])draw_heatmap(ax5, plot_results[1]['corr'], plot_results[1]['p_val'], "e", current_heatmap_cmap)ax6 = fig.add_subplot(gs[1, 2])draw_heatmap(ax6, plot_results[2]['corr'], plot_results[2]['p_val'], "f", current_heatmap_cmap)
第十七部分
主程序:颜色条添加与主图保存
cbar_axes = [ax4, ax5, ax6] # 定义需要添加颜色条的轴列表for ax in cbar_axes: # 遍历这些轴pos = ax.get_position() # 获取轴的位置cax = fig.add_axes([pos.x0, pos.y0, pos.width * 0.7, 0.01]) # 创建颜色条的轴位置norm = plt.Normalize(-1, 1) # 设置颜色条的归一化范围sm = plt.cm.ScalarMappable(cmap=current_heatmap_cmap, norm=norm) # 创建 ScalarMappable 对象sm.set_array([]) # 设置空数组cbar = fig.colorbar(sm, cax=cax, orientation='horizontal') # 绘制水平颜色条cbar.set_ticks([-1, -0.8, -0.6, -0.4, -0.2, 0, 0.2, 0.4, 0.6, 0.8, 1]) # 设置颜色条刻度cbar.ax.tick_params(labelsize=9) # 设置刻度标签大小cbar.ax.xaxis.set_ticks_position('top') # 设置刻度位置在顶部cbar.ax.xaxis.set_label_position('top') # 设置标签位置在顶部
第十八部分
主程序:子图单独保存
#================================================================子图保存部分============================================================================labels_abc = ['a', 'b', 'c'] # 定义条形图编号for i in range(3): # 遍历前 3 个结果fig_sub, ax_sub = plt.subplots(figsize=(8, 6)) # 创建子图画布draw_bar_chart(ax_sub, plot_results[i]['imp'], plot_results[i]['title'], labels_abc[i], current_palette, current_title_bg) # 绘制单个条形图labels_def = ['d', 'e', 'f'] # 定义热力图编号for i in range(3):fig_sub, ax_sub = plt.subplots(figsize=(8, 7)) # 创建子图画布draw_heatmap(ax_sub, plot_results[i]['corr'], plot_results[i]['p_val'], labels_def[i], current_heatmap_cmap) # 绘制单个热力图pos = ax_sub.get_position() # 获取位置cax = fig_sub.add_axes([pos.x0, pos.y0 - 0.05, pos.width * 0.7, 0.02]) # 创建颜色条位置norm = plt.Normalize(-1, 1) # 归一化sm = plt.cm.ScalarMappable(cmap=current_heatmap_cmap, norm=norm) # 映射sm.set_array([]) # 空数组cbar = fig_sub.colorbar(sm, cax=cax, orientation='horizontal') # 绘制颜色条cbar.set_ticks([-1, -0.8, -0.6, -0.4, -0.2, 0, 0.2, 0.4, 0.6, 0.8, 1]) # 设置刻度cbar.ax.tick_params(labelsize=9) # 设置参数cbar.ax.xaxis.set_ticks_position('top') # 设置刻度位置cbar.ax.xaxis.set_label_position('top') # 设置标签位置
如何应用到你自己的数据
1.选择要使用进行分析的相关性分析方法:
CORRELATION_METHOD = 1 # 定义相关性分析的方法2.选择要使用的配色方案:
CURRENT_SCHEME_ID = 40 # 定义当前使用的配色方案3.设置变量所属的类别:
VAR_INFO = { 'SIW': {'name': 'Salinity of irrigation water', 'cat': 'Irrigation practices'},4.设置不同区域的数据文件以及目标变量:
target_configs = [ {'name': 'Soil salinity', 'file': 'region_data_1.xlsx'},5.设置文件的路径地址:
base_path = r'热力图' #原始数据的路径6.设置超参数:
param_grid = { 'n_estimators': [100, 200], 'max_depth': [None, 10, 20], 'min_samples_leaf': [1, 2], 'max_features': ['sqrt', 'log2', None]}7.设置绘图结果的保存路径:
plt.savefig(fr'RF_analysis{CURRENT_SCHEME_ID}.png', dpi=300, bbox_inches='tight')plt.savefig(fr'RF_analysis{CURRENT_SCHEME_ID}.pdf',dpi=300, bbox_inches='tight')
推荐
获取方式
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
